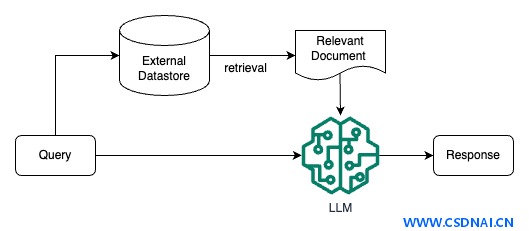
检索增强生成这件事,剥开术语外壳,本质是给模型外挂一个可查询的知识源。用户提问进来,系统先去外部库把相关片段捞出来,再把这些片段塞进模型的上下文窗口,让模型基于证据作答。传统搜索引擎只有检索能力,模型只有参数里的记忆,RAG 站在两者中间:用信息检索技术把外部信息加载进模型单次生成能接受的最大文本输入,也就是上下文窗口。
为什么非要外挂知识
模型对大众常识往往答得稳,碰到长尾知识就开始飘。ICML 那篇 Large Language Models Struggle to Learn Long-Tail Knowledge 做过量化分析,预训练语料里某领域文档越多,模型对该领域事实问答的准确率越高,两者强相关。结论很直白:模型学长尾知识的能力偏弱。想靠堆数据、堆参数补上,实验上有效,但代价不经济。推理时把相关资料作为上下文喂进去,准确率和成本之间能取得更好的平衡。
私有数据是另一道坎。通用模型预训练用的是公开语料,企业内部知识它压根没见过,问起来要么不知道要么编。走预训练或微调把私有知识写进参数,训练迭代成本高,还存在隐私泄露面——已有研究证明特定攻击手法能诱导模型吐出训练数据。把私有数据放在外部库、按需检索,既省了训练开销,也把敏感信息挡在参数之外。
数据新鲜度同理。频繁变动的信息一旦固化进参数就迅速过时,而外部库更新一条记录的成本几乎可以忽略,模型本身不用动。
可解释性也顺带解决了。模型输出不再是无源之水,每条回答都能回溯到具体检索片段,出了问题能定位是检索错了还是生成歪了。
三个模块,各有各的坑
数据和索引模块负责把多来源、多格式的外部数据归一成统一的文档对象。文档对象除正文外还带元信息,元信息在后期检索过滤时非常关键——按时间、按部门、按权限筛,全靠它。
查询和检索模块决定召回质量。这里有个常见误判:上下文窗口越来越长,是不是可以跳过检索、直接把整库塞进去?工程上不成立。长上下文带来的是延迟和成本的线性上升,且模型对超长上下文中部信息的利用率会下降,检索仍然是性价比最高的前置过滤。
响应生成模块负责把检索片段组织进提示词并约束模型作答。片段怎么排序、怎么截断、冲突信息怎么取舍,直接决定最终输出质量。
向量库不是随便挑一个
原文只说了“存到向量数据库”,实际选型要看检索模式。HNSW 索引的两个核心参数 M 和 efConstruction 直接决定召回率与构建耗时的权衡:M 调大提升召回但内存占用上升,efConstruction 调大构建更慢、图质量更好。查询时的 ef 参数则控制搜索广度,ef 越大召回越高、延迟越大,需要按业务延迟预算压测确定。
过滤检索是另一个分水岭。Milvus 这类专用向量库支持带标量的混合过滤,先过滤再检索,元信息条件复杂时表现稳定;pgvector 在数据量不大、且已有 PostgreSQL 运维体系时很省事,但高选择性过滤叠加向量检索时,执行计划可能退化为全表扫描后再排序,延迟不可控。选型前先用真实数据分布做一轮压测,别只看 benchmark 的纯向量召回数字。
三种调用模式的实际差别
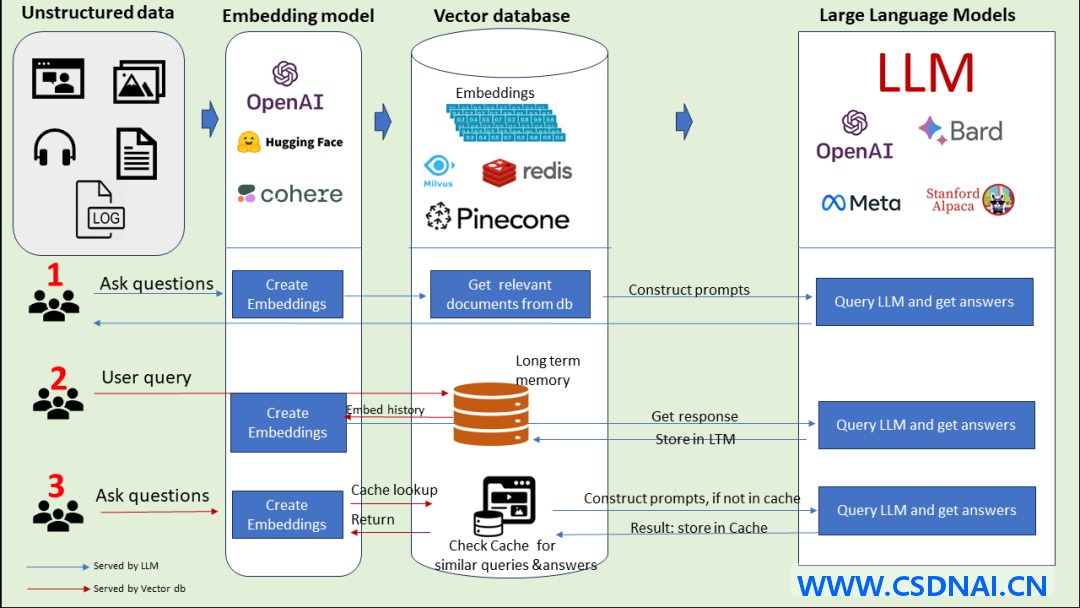
模式一是最标准的形态:非结构化数据经 Embedding 模型向量化入向量库,查询时构造提示词交给模型,结果返回用户。适合文档问答、知识库客服这类场景。
模式二在问答之外多做了一件事:把用户问题和模型回答都写回长时记忆库。这解决的是多轮对话的上下文延续问题,但要注意写入策略——不加筛选地全量落库,记忆库很快会被噪声污染,后续检索质量断崖下跌。
模式三加了一层缓存:问题向量化后先去缓存里找相似问答,命中直接返回,未命中才走模型,回答再回填缓存。高频重复问题的场景收益明显,但相似度阈值设低了会返回似是而非的旧答案,设高了命中率又上不去,这个阈值必须用真实 query 日志调。
验证与排错:别等上线才发现检索是空的
RAG 系统最隐蔽的故障是“检索没坏但没捞到东西”,模型照样流畅作答,只是全靠编。上线前至少跑三类校验。
检索层:准备一批标注了标准答案片段的问题集,计算 top-k 召回率。判定标准是核心问题集 top-5 召回不低于业务约定阈值,低于阈值先查 embedding 模型与入库时是否一致——换过模型而没重建索引是最常见的根因。
上下文层:检查拼进提示词的实际 token 数。片段按相似度排序后从尾部截断,容易把关键信息截掉。用日志打印最终 prompt 长度,对照模型上下文上限留出生成余量。
生成层:对回答做来源引用校验,要求模型输出中标注引用的片段编号,再核对编号是否真实存在于本次检索结果。出现引用不存在编号的情况,说明提示词约束失效或模型在编造来源。
相似度阈值误设是答非所问的高发原因。阈值过高导致召回为空、模型无据可依;过低则引入大量弱相关片段干扰生成。用验证集画出阈值与准确率的曲线,取拐点而不是拍脑袋定 0.8。
RAG 和微调怎么选
两者不是替代关系,边界很清楚。数据频繁变动、需要溯源、以文档和结构化库为主要知识载体,选 RAG。要调整模型的语气、写作风格、特定领域的表达习惯,微调更合适,RAG 管不了行为定制。
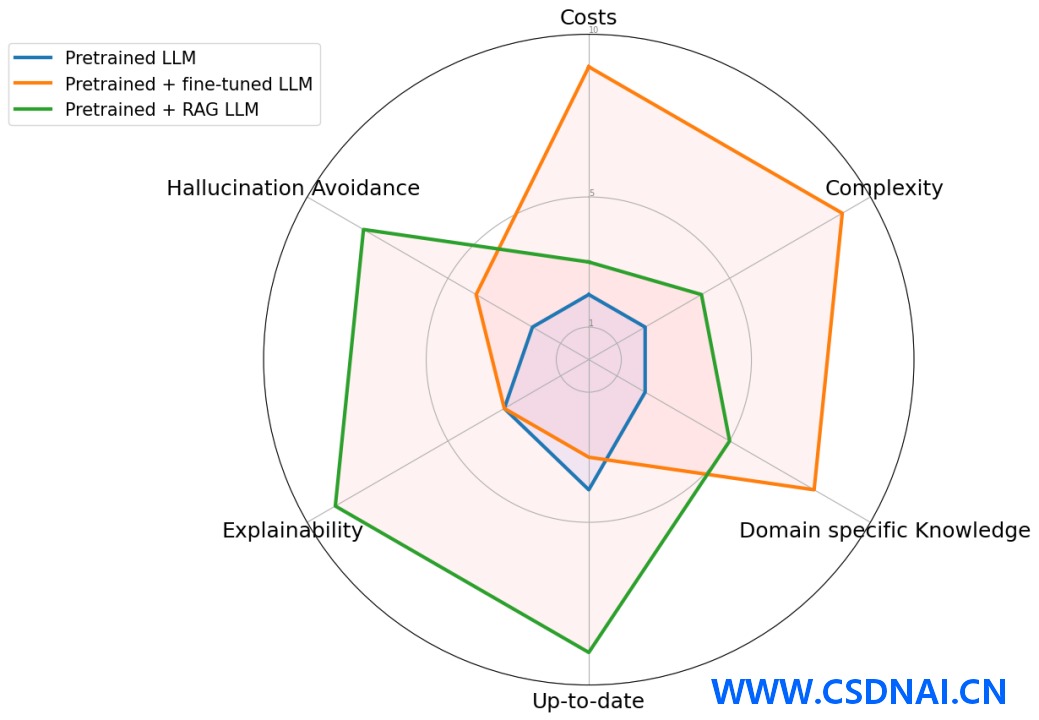
幻觉方面,RAG 的每个回答建立在检索证据上,天然不容易编;微调能靠领域数据压低幻觉,但遇到训练分布外的输入照样会编。透明度上差距更大:RAG 把检索和生成拆成可观测的两段,匹配度可查;微调是黑箱,推理路径不透明。
成本结构也不同。RAG 的持续开销在检索基础设施和数据更新管道;微调的开销集中在高质量数据集整理和算力。与预训练相比,两者都是更经济的路径,雷达图里三种方案在准确性、成本、可定制性上的差异一目了然。
实践中常见的是组合拳:底层模型做一次轻量微调对齐领域表达,知识更新交给 RAG 承担。分工明确,各自做擅长的事。
ID:6861







