终端里敲错一条命令,代价往往不是重敲一遍那么简单。依赖装了一半、配置文件被覆盖、后台进程占着端口——环境已经被改脏了。Code Agent 接下来要做的,是先搞清楚”现在到底处于什么状态”,再决定往哪走。这个诊断过程,恰恰是当前模型最薄弱的一环。
复旦、港中文 MMLab 与上海交大合作的 ReTerm 盯住的就是这个环节。它不教模型如何一次做对,而是教模型如何收拾自己留下的烂摊子,并把收拾的过程变成下一轮训练的数据来源。

纠错难在环境已被污染
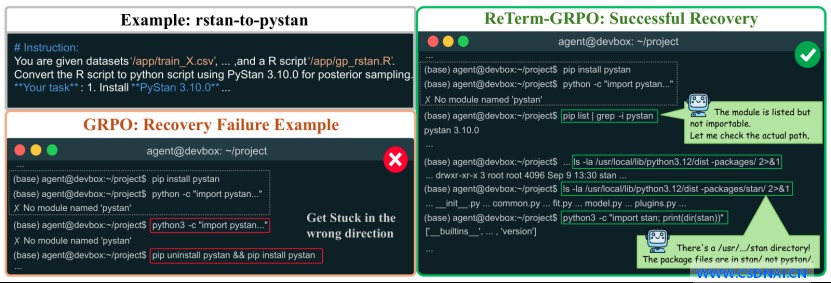
推理题答错了,改个答案就行。终端任务失败了,改的是一整个被改动过的系统。PyStan 那个案例很能说明问题:包确实装上了,import pystan 却报错。标准 GRPO 训出来的模型在这个点上打转——反复卸载、重装、再导入,动作循环但假设没变。ReTerm-GRPO 的模型换了个查法,去看安装路径,发现模块实际落在 stan 目录下,改用 import stan 才走通。
差别不在知识量,在于是否具有”先勘察、再动手”的行为模式。只喂干净环境下的成功轨迹,模型学不到这种模式;人工造的错误又未必是模型真会犯的错。ReTerm 的做法是把训练起点直接设在模型自己搞砸之后的现场。
快照回放与奖励设计的工程细节
这里有个容易被忽略的实现问题。标准 GRPO 在长程终端任务上奖励极其稀疏——整条轨迹只有最终成败一个信号,中间几十步操作拿不到任何区分度。信用分配因此非常粗糙,模型很难判断究竟是哪一步导致了失败。
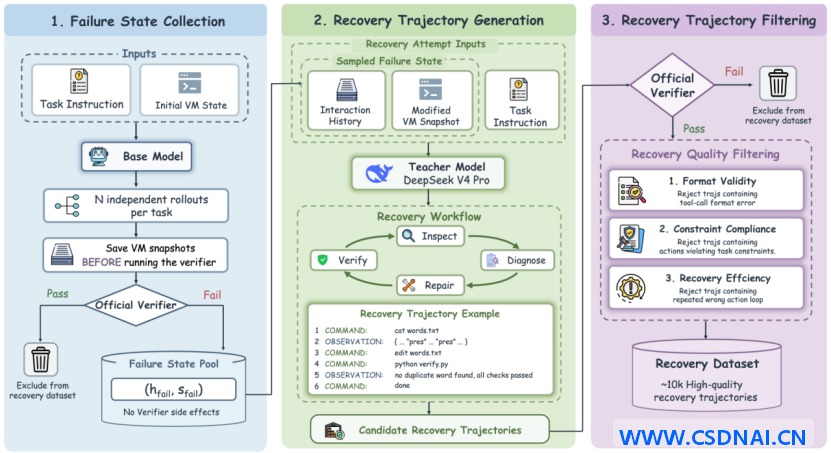
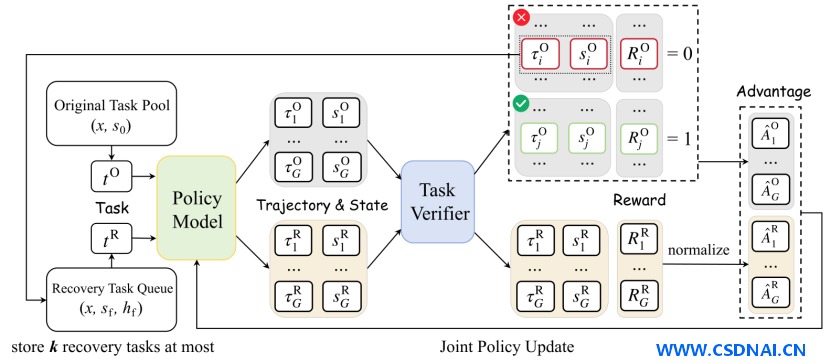
ReTerm-GRPO 的应对方式依赖环境快照:任务失败时冻结当时的文件系统与进程状态,从同一快照出发让模型独立尝试多条恢复路径。每条路径独立判定成败,形成组内对比。这本质上把稀疏的终局奖励拆成了”同一失败现场下的多方案比较”,组内方差直接来自恢复策略的差异,而非任务本身的难度差异。工程上要注意快照必须包含进程与端口状态,只备份文件系统会导致恢复轨迹在回放时行为不一致,训练信号被污染。
先学会接手,再学会自己扛
冷启动阶段构建的 ReTerm-10K 约一万条轨迹,来源是基础模型真实失败的任务。教师模型接手这些失败现场,示范如何定位问题、修复、收尾。经过验证与筛选后用于 SFT,让模型先具有基本的恢复行为模式。
筛选环节比原文描述的要细。至少三个维度需要卡:环境状态一致性——回放时快照能否精确还原失败瞬间;验证器判定边界——恢复成功的判定不能只看退出码,要检查目标状态是否真正达成;分布匹配度——教师轨迹覆盖的失败类型要与基础模型的真实失败分布对齐,否则冷启动学到的是”教师会犯的错”而非”自己会犯的错”。第三点最容易翻车,教师模型能力越强,其失败模式越偏离弱模型,示范的迁移效率反而下降。
SFT 之后进入在线强化学习。模型在自己的失败现场上探索多种恢复方案,验证器给出成败,信号回传更新参数。能力变了,失败的类型也跟着变,新一轮失败继续进入训练。这个循环就是论文所说的失败驱动 RSI。
数字背后的增益结构
9B 模型在三个主评测上的提升都超过 13 个百分点:Terminal-Bench 2.0 从 20.2% 到 34.8%,SWE-bench Verified 从 45.2% 到 58.4%,OpenThoughts-TBLite 从 44.2% 到 60.6%。与同框架同配置的 Qwen3.5-9B 直接对比,增益归属清晰。
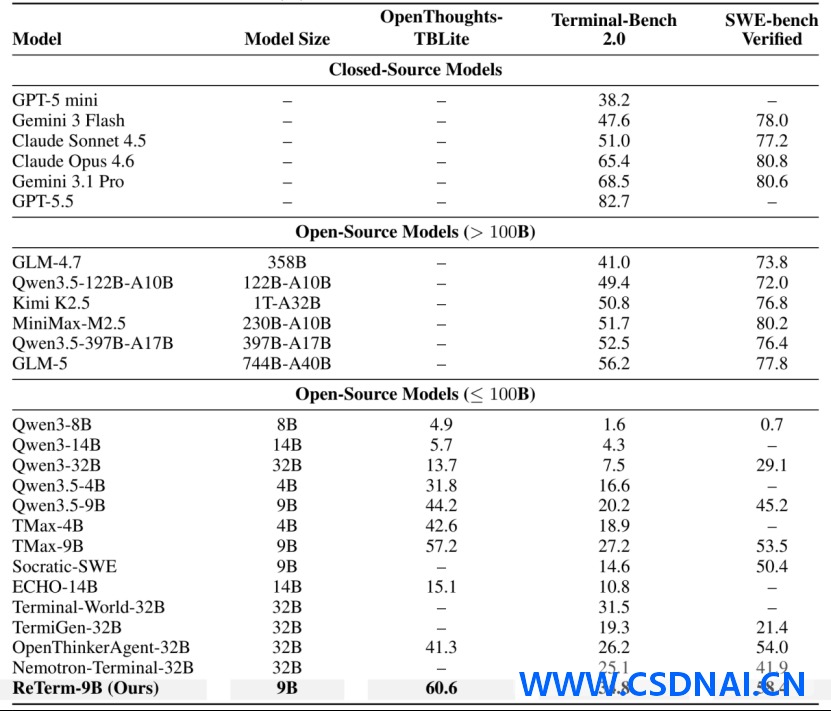
消融把增益拆得更明白。恢复示范 SFT 单独带来 20.2%→25.8%,标准 GRPO 到 28.0%,ReTerm-GRPO 再到 34.8%。也就是说,在常规 RL 之上专门优化恢复行为,额外贡献 6.8 个百分点。这部分才是方法本身的价值,前面的提升里混着 SFT 和 RL 的通用收益。
跨框架验证也做了:同一批 Terminal-Bench 2.0 任务换三套运行框架,增益保留 6.7 到 12.4 个百分点。收益不绑定特定交互协议,这点对实际部署很关键。
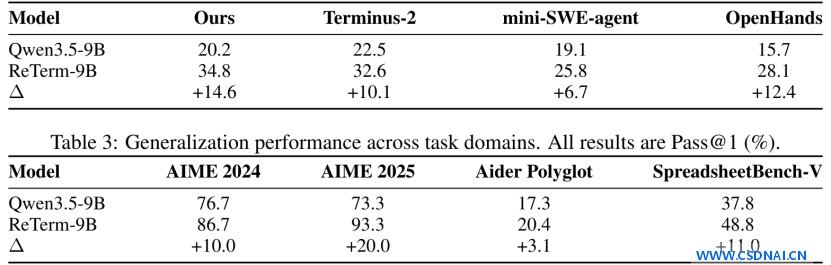
泛化方面,AIME 2025 Pass@1 从 73.3% 升到 93.3%,SpreadsheetBench Verified 从 37.8% 到 48.8%,AIME 2024 与 Aider Polyglot 也有提升。数学和表格任务的增益说明恢复训练改变的不只是终端操作习惯,可能涉及更一般的”出错后重新审视假设”的能力。
恢复率仍有明显天花板
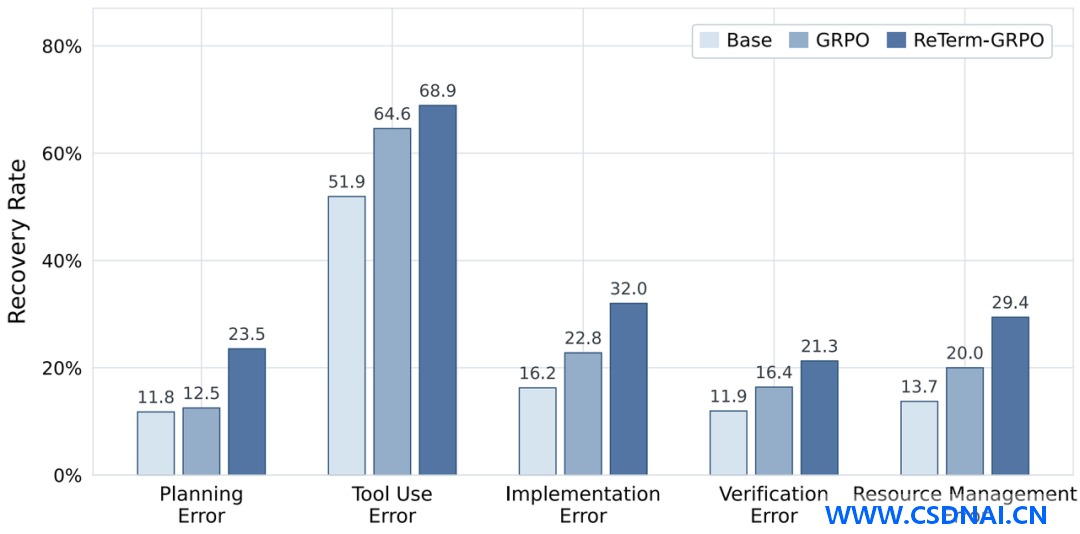
按错误类型拆开看,规划、工具使用、代码实现、验证、资源管理五类错误上,ReTerm-GRPO 的恢复率都高于基础模型和标准 GRPO。但除工具使用外,其余四类的恢复率都没超过 32%。
这个数字值得警惕。它意味着大部分错误发生后模型仍然救不回来,当前方法解决的是”恢复行为能否稳定出现”,还没解决”恢复成功率能否足够高”。规划类错误的恢复尤其难,因为错误假设往往在好几步之后才暴露,回滚成本高,快照回放也只能还原环境、还原不了已经消耗的上下文预算。
另一个现实约束是训练成本。每条失败轨迹都要保留快照、多次采样恢复路径、逐条验证,单任务的计算开销远高于普通 SFT。任务越长、环境越复杂,快照体积和回放开销涨得越快。这套方案适合错误代价高、任务可验证、环境可快照的场景;对不可逆的外部副作用(比如已经发出的网络请求、已经扣费的 API 调用),快照回放无能为力,方法直接失效。
失败作为训练原料的边界
ReTerm 给出的路径是具体的:保留失败现场,自主尝试恢复,用可验证结果更新策略,让新失败进入下一轮。失败从执行终点变成训练起点,这个转向本身有实验价值。
代码、模型与数据已公开(github.com/twothsnd/ReTerm),论文在 arXiv:2610.18484。复现时优先关注快照一致性和验证器判定逻辑这两处,它们决定了训练信号是否干净,比调超参更影响最终结果。
ID:7900