单一向量检索在真实业务里经常翻车。用户搜“iPhone 15 Pro Max 电池容量”,纯语义模型可能召回一堆泛泛而谈的“手机续航评测”;反过来,纯关键词检索又接不住“适合夏天穿的鞋”这种口语化表达。混合检索要解决的就是这个错位。
两路召回的分数量纲问题
混合检索的本质是把 BM25 得分和向量相似度得分揉成一个排序。BM25 由 TF-IDF 演化而来,对词频和文档长度做了归一化,擅长精确匹配产品型号、法条编号这类硬 token。语义得分来自 Sentence-BERT 一类的双塔模型,擅长泛化。
麻烦在于两者量纲完全不同。BM25 在 Lucene 实现里没有上界,实际语料上动辄几十上百;余弦相似度落在 -1 到 1 之间。直接加权等于让 BM25 单方面主导排序。所以必须先做 Min-Max 归一化,把两路得分压到 0 到 1 区间,再按 α 加权:
综合得分 = α · norm(BM25_score) + (1 - α) · norm(Semantic_score)
α 的取值靠验证集调。电商场景常见 0.4 到 0.6,语义略占上风;法律、工单这类强术语场景可以往上压到 0.7。网格搜索够用,贝叶斯优化在参数维度多时更省评估次数。
别急着自研融合,先看引擎给什么
如果底层用的是 Elasticsearch 8.x,混合检索不必从零写归一化逻辑。8.4 之后原生支持 RRF(Reciprocal Rank Fusion),用 rank 而非 score 做融合,天然绕开量纲问题:
{
 "retriever": {
 "rrf": {
 "retrievers": [
 { "standard": { "query": { "match": { "content": "iPhone 15 Pro Max" } } } },
 { "knn": { "field": "embedding", "query_vector": [...], "k": 50, "num_candidates": 200 } }
 ],
 "rank_constant": 60,
 "rank_window_size": 50
 }
 }
}
rank_constant 默认 60,控制排名靠前文档的得分衰减速度;rank_window_size 决定每路召回取多少条参与融合,设太小会截断长尾。RRF 的代价是丢弃了原始分值的绝对信息,只保留相对顺序,对“分数本身有业务含义”的场景不适用。需要精细控制 α 时,还是得走自研加权路线。
融合后的候选集保留 Top-50 左右送进下一阶段。这个数字不是拍脑袋:候选太少,重排模型没有腾挪空间;太多,延迟线性上涨而收益递减。
交叉编码器为什么比双塔准
检索阶段的双塔模型把 query 和 document 分别编码再算余弦,两者在编码时互不可见,交互信息在点积那一步已经损失殆尽。重排序换成交叉编码器,把 query 和 document 拼成一条序列喂进 Transformer:
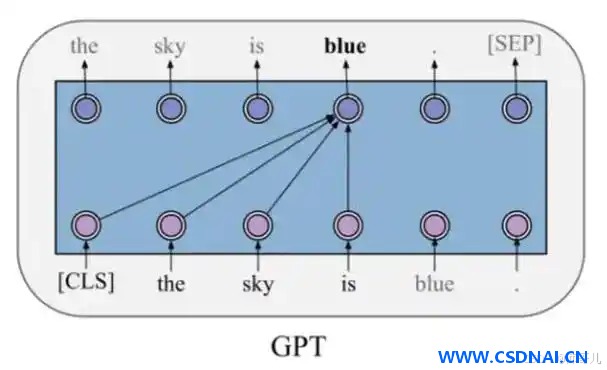
[CLS] 如何优化RAG检索 [SEP] 混合检索通过BM25与向量召回... [SEP]
自注意力机制在这一步能建模“续航”与“电池容量”“使用时长”之间的细粒度关联,取 [CLS] 位置的隐状态过一层 MLP 输出相关性概率。代价是无法预计算文档向量,每个 query-document 对都要完整前向一次,所以只能处理小候选集。
模型选型上,bge-reranker 系列开源可自部署,中等 GPU 就能跑,通用场景够用;Cohere Rerank 走 API,多语言支持好但要付费且数据出域。原文提到的 mxbai-rerank-v2 在长上下文上有优势,但选型时别只看宣传的上下文长度。
一个被忽略的截断陷阱
bge-reranker 的底层是 BERT 类结构,最大输入长度 512 token。query 加 document 拼起来超过这个数就会被静默截断,截掉的部分不参与打分。技术文档、合同条款这类长文本,关键信息往往落在中后段,截断直接导致相关性判断失真,而且不报错,极难排查。
两个应对方向。一是重排前对文档做段落切分,按段分别打分取最大值,代价是请求数翻倍;二是换用支持更长输入的模型,但要注意长上下文模型的推理成本并非线性增长。用 sentence-transformers 的 CrossEncoder 时,把 max_length 显式设成模型上限,并在预处理阶段打印 token 长度分布,超过阈值的样本单独走切分逻辑:
from sentence_transformers import CrossEncoder

model = CrossEncoder("BAAI/bge-reranker-base", max_length=512)
pairs = [(query, doc) for doc in candidates]
scores = model.predict(pairs, batch_size=16, show_progress_bar=False)
batch_size 按显存调,16 到 32 是常见区间。批处理的意义在于摊薄模型加载和 kernel 启动开销,不是越大越好,显存打满反而触发换页拖慢整体。
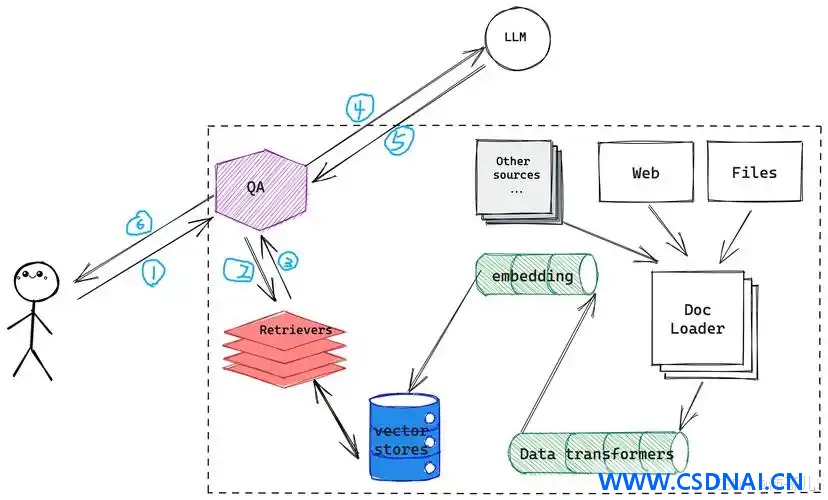
两级增强的配合逻辑
混合检索负责扩大召回面,把精确匹配和语义泛化两路结果并集送进候选池;重排序负责在池子里做精细甄别,把真正对题的那几条顶到最前。前者解决“找得到”,后者解决“排得准”。
这个组合在事实型问答上收益最明显。纯语义检索容易把语义相近但事实错误的文档排前面,重排的交叉注意力能把这种伪相关压下去。业界报告的准确率提升区间在 30% 到 50%,但具体数字强依赖语料质量和标注集,别直接套用到自己的评估里。
动态权重与元数据
固定 α 在混合查询场景下不够用。按 query 类型分流更合理:命中产品型号、编号、专有名词的走关键词权重高的分支,口语化长句走语义分支。分类器可以很轻,正则加小模型就够。
元数据过滤是另一条低成本提效路径。给文档打上发布时间、领域标签,检索时先做前置过滤再算分。“2025年AI趋势”这类时效敏感查询,把两年前的文档直接排除在候选池外,比任何重排模型都有效。前提是元数据字段本身可靠,脏标签引入的偏差比不过滤更糟。
验证怎么做
改完检索链路必须量化验证,别凭感觉。准备一份带标注的 query-doc 对,至少覆盖三类:精确关键词查询、语义泛化查询、长尾罕见查询。指标看 Recall@50 确认召回没退化,看 NDCG@10 确认排序质量提升。每次只改一个变量——先固定重排模型调 α,再固定 α 换重排模型,否则归因不清。
延迟也要盯。混合检索多一路召回,重排多一次前向,端到端 P99 上涨是必然的,提前设好预算阈值,超了就降候选集大小或换更小的重排模型。
ID:6855







