RAG要解决的问题很直接:预训练模型的知识停在训练截止那一刻,权重里没有你私有的文档,也没有昨天刚发生的事。想让模型回答它没见过的内容,就得在推理时把相关资料塞进上下文。检索增强生成就是这条路径的工程化实现。
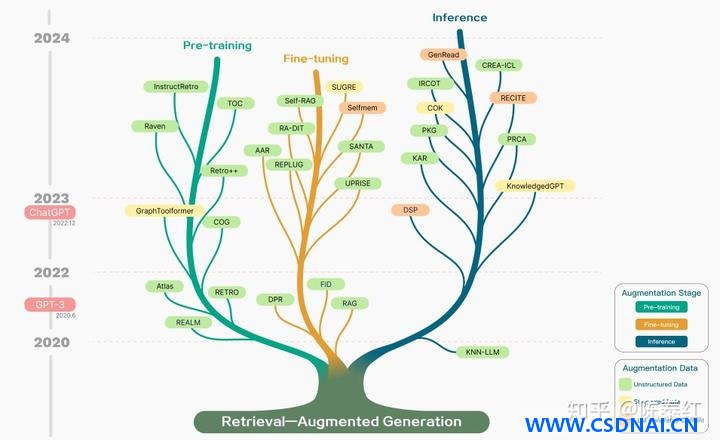
增强可以发生在三个位置:预训练阶段往语料里掺外部数据,微调阶段用领域样本调整参数,推理阶段临时挂接知识库。前两者成本高、周期长,推理阶段的外挂方案最灵活,也是当下绝大多数项目采用的形态。数据源同样分三类:非结构化文本、结构化表格、以及模型自己生成的内容。
检索与生成各自承担什么
整条链路拆开只有两段。检索阶段用编码模型把用户问题转成向量,在文档库里找语义最近的若干片段。生成阶段把召回的片段拼进提示词,作为条件交给大模型输出答案。
两段的分工决定了系统的强弱项。检索质量差,生成再强也是无源之水;生成模型弱,召回再准也组织不好语言。所以调优要分开看:召回不准就换嵌入模型、调分块策略、加混合检索;答非所问就改提示模板、降温度、换更强的生成模型。
RAG相对纯生成的优势在于知识可实时更新——改文档库即可,不用重训模型;答案能追溯到具体片段,可解释性更好;对垂直领域适配成本低。代价是链路变长,每一环都可能引入误差。
环境准备与依赖安装
原文给的安装命令在新版环境下会出问题。LangChain从0.1版本起做了包拆分,langchain本体不再捆绑各家模型和向量库的集成,OpenAI相关类迁到了langchain-openai,文本分割器迁到了langchain-text-splitters,Weaviate集成在langchain-weaviate。照原文写from langchain.embeddings import OpenAIEmbeddings,新版环境直接抛ModuleNotFoundError。
正确的安装组合:
pip install langchain langchain-openai langchain-weaviate langchain-text-splitters weaviate-client python-dotenv
对应导入路径也要跟着改:OpenAIEmbeddings和ChatOpenAI从langchain_openai导入,CharacterTextSplitter从langchain_text_splitters导入。这一步不改,后面所有代码都跑不起来。
API密钥放在项目根目录的.env文件里,用python-dotenv加载,别硬编码进脚本:
OPENAI_API_KEY="你的key"
文档加载与分块的实际取舍
加载用TextLoader读纯文本,编码参数建议显式指定encoding='utf-8',否则在Windows默认GBK环境下读中文文件会乱码。
分块是整条链路里最容易被低估的环节。原文用CharacterTextSplitter配chunk_size=1024、overlap=128。这个分割器的默认分隔符是换行符\n,对排版规整的英文文档没问题,但中文小说或技术文档经常整段没有换行,结果就是一个块远超1024字符,或者切出大量空块。
更稳的做法是换RecursiveCharacterTextSplitter,它按分隔符优先级递归切分,并且可以传入中文标点:
from langchain_text_splitters import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
 chunk_size=1024,
 chunk_overlap=128,
 separators=["\n\n", "\n", "。", "!", "?", ";", ",", " ", ""]
)
chunks = splitter.split_documents(documents)
overlap保留128字符是为了让跨块的句子不至于被拦腰截断后语义丢失。块太大召回精度下降,块太小上下文不完整,1024这个量级适合问答类场景,摘要类任务可以放大到2048。
向量化与存储
每个块要生成嵌入向量才能做语义检索。用OpenAI的嵌入模型配合Weaviate存储,from_documents会自动完成向量化和写入。
原文用EmbeddedOptions启动嵌入式Weaviate,省去单独部署。这条路在本地试验很方便,但有两个现实问题。一是weaviate-client 4.x版本对嵌入式模式的支持有变化,部分版本组合下启动会报连接超时或端口占用;二是嵌入式实例的数据默认不持久化,进程结束数据就没了,每次重跑都要重新向量化,既费钱又费时。
遇到启动报错,先确认weaviate-client版本,锁定在3.25.x这类与嵌入式模式兼容较好的版本;或者干脆改用Docker起一个Weaviate服务,连接地址指向http://localhost:8080,数据落在挂载卷里,稳定得多。生产环境没有理由用嵌入式模式。
向量化这步会产生API调用费用,文档量大时建议先把分块结果落盘,向量化单独跑一次并持久化,避免调试链路时反复烧钱。
检索器、提示模板与链的组装
数据入库后,as_retriever()把向量库包装成检索器组件,默认按相似度返回top-k个片段,k值可以在调用时传参调整,一般取3到5。
提示模板要明确约束模型只依据上下文作答。原文模板里”如果你不知道答案,就说你不知道”这句不能省,它是抑制模型编造的关键。模板结构上把context和question分开占位,便于后续调试时单独替换。
链的组装用LCEL管道语法,把检索器、提示模板、模型、输出解析器串起来。RunnablePassthrough负责把用户问题原样透传,同时并行触发检索。整条链一次invoke完成召回、拼接、生成、解析。
rag_chain = (
 {"context": retriever, "question": RunnablePassthrough()}
 | prompt
 | llm
 | StrOutputParser()
)
生成模型选gpt-3.5-turbo做原型够用,温度设0保证输出稳定。正式场景建议换gpt-4o-mini或同级别模型,指令遵循和抗干扰能力明显更好,成本也可控。
验证链路是否真的在工作
跑通不等于有效。至少要验证三件事。
第一,检索是否命中。单独调用retriever.invoke("问题"),打印返回的片段,确认里面确实包含答案相关内容。如果召回的全是无关段落,问题出在嵌入或分块,不在生成模型。
第二,答案是否来自上下文。故意问一个文档里不存在的问题,正确行为是模型回答”不知道”。如果它流畅地编了一个答案,说明提示模板约束不够或温度过高。
第三,换问法是否稳定。同一个事实用不同表述提问,答案应当一致。差异过大说明召回不稳定,考虑加大top-k或引入关键词混合检索。
这三步做完,才算把RAG链路从”能跑”推进到”能用”。剩下的调优都是围绕召回精度和提示约束反复迭代,没有一劳永逸的配置。
ID:6639







