OpenAI 把 Pierre Computer Company 收进了口袋。公告措辞很明确:让 Codex 成为团队和 AI 一起造软件的地方,从第一个想法一直管到最终发版。Pierre 那边同步放了个篮球场拍的视频,说产品还会继续做。交易还得过监管这关,交割前两家照旧独立运转。

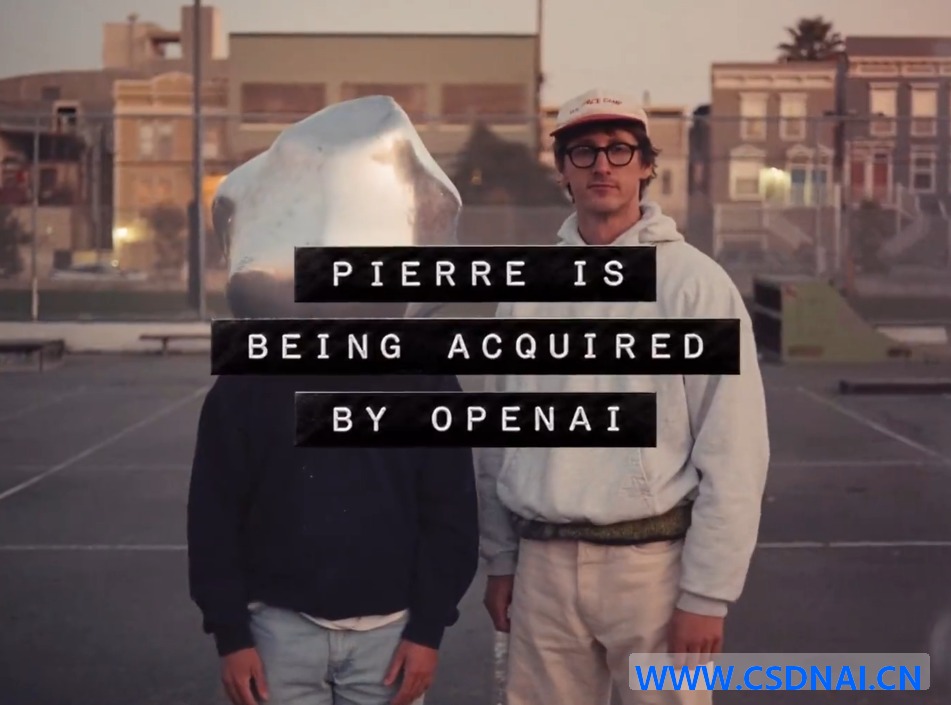
Pierre 这个名字对多数后端同学可能陌生,但提 Jacob Thornton 就不一样了。他是 Bootstrap 的联合作者,那个从 Twitter 内部长出来的 CSS 框架喂饱了一代 Web 开发者。另一位创始人是 Ian Ownbey。公司 2023 年成立,团队十几到几十人,累计融资约 2400 万美元。官网 pierre.computer 复古得像 1996 年的个人主页,公司介绍就一句:为机器工作打造底层、可组合的产品基础设施。
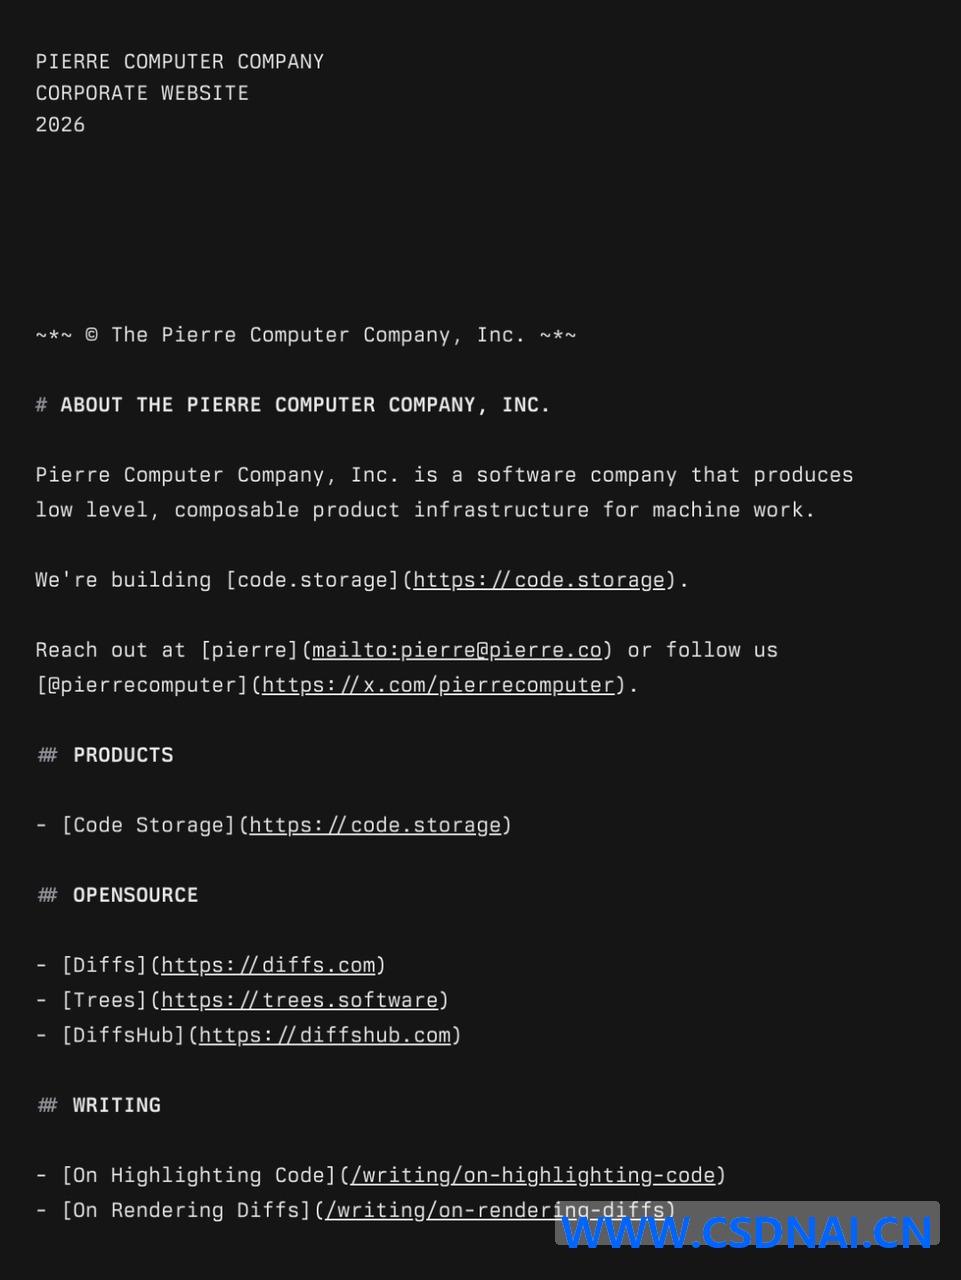
产品线一商业三开源。Code Storage 是吃饭的家伙,定位给 AI 智能体存代码和机器产物;Diffs 管差异渲染,Trees 管文件树浏览,DiffsHub 是基于 Diffs 的开源项目。OpenAI 公告里专门点了 Trees 和 Diffs,说这俩库已经在 Codex 应用里干活,负责文件浏览和 diff 审查界面。
智能体把 Git 的假设打穿了
传统 Git 托管平台的设计前提是人。一个工程师一天提交几次,分支开得克制,读写请求稀疏。限流、权限审批、PR 流程,全是围绕这个节奏搭的。
智能体不吃这套。它一分钟能拉几十个分支,并发读写,中间产物海量生成又迅速废弃。Code Storage 就是冲着这个错位来的:单仓库最高 32TB,仓库数和总存储不设上限,Git 与 API 请求均不限速,实测单仓库每秒 500 次以上 Git 请求、API 峰值每秒 1.5 万次,30 个以上并发写入,99.99% 可用性 SLA。技术上走 Git 三阶段提交协议加辐条式法定多数架构,在扛并发的同时保持久性和一致性。接入方式不逼人改工作流,TypeScript、Python、Go 的 SDK 能直接操作仓库,原生 Git 协议照样 clone 和 push,还能和 GitHub、GitLab、Bitbucket 双向同步。
计费按冷热分层:7 天内碰过的热数据每 GB 每小时 0.005 美元,超过 7 天没访问的冷数据降到 0.0002 美元,差 25 倍。逻辑是智能体生成的代码大多只读一两次就吃灰,分层能让高频生成、低频访问的模式在账面上撑住。
这个模型有它的适用边界,值得提前想清楚。冷热判定看的是访问时间窗口,不是数据价值。如果团队的 CI 流水线习惯对全量历史做浅克隆之外的完整拉取,或者审计流程要求定期回溯旧提交,那些本该躺在冷数据层的对象会被反复唤醒,计费重新落回热档,25 倍的价差就没了。换句话说,分层省钱的前提是访问模式真的稀疏,而不是把冷数据当备份仓库天天扫。上量之前拿一周的真实访问日志跑一遍成本模拟,比事后看账单靠谱。
审查才是卡脖子的地方
代码写出来总得有人看。一个工程师同时指挥几个智能体并行干活,每天要过的 diff 可能是过去的好几倍。写代码的速度早就跑赢了读代码的速度,审查和发版成了真正的瓶颈。
Pierre 的工具被看上,很大程度是因为它们在“让人快速看懂大量代码”上下了功夫。Diffs 有个编辑模式挺实用:审查者在 diff 视图里发现毛病,直接原地改那一行,不用切回编辑器。新出的 Highlights 能在人打字或者智能体流式输出时实时刷语法高亮。Trees 负责在巨型项目里快速定位文件。OpenAI 公告里那句“把企业交付的代码和员工所做的决策联系起来”也值得琢磨——Git 记得住代码怎么变,记不住为什么变。AI 生成比例越高,变更背后的取舍越难追溯,这个缺口只会更大。
想验证一个面向智能体的仓库是不是真健康,别只看厂商给的 QPS 数字。拿 git 原生命令就能做基线:git fsck –full 查对象完整性,git count-objects -v 看松散对象和打包对象的规模分布,再对同一仓库做一次冷 clone 计时,和热 clone 对比。如果 fsck 报 dangling 对象异常多、count-objects 显示松散对象长期不打包,说明写入路径的 gc 策略没跟上高并发节奏,这种仓库在智能体高频建分支的场景下会越跑越慢。判定标准不复杂:clone 耗时随仓库增长应保持近似线性,出现明显超线性拐点就该查打包和引用数量了。
开源承诺与整合节奏
OpenAI 给的承诺是:Pierre 的开源项目继续开源,Code Storage 现有客户继续可用,能力逐步并进 Codex。新产品长什么样没说。监管批准没下来之前,一切整合都是纸面计划。
但方向已经很清楚。过去十几年,代码的存放、追溯、管理被 GitHub 这类平台牢牢占着。现在 OpenAI 买下一家专为 AI 造 Git 基础设施的公司,意图不用猜。AI 编程工具的竞争正在往下一层沉,从补全、对话,沉到代码怎么存、怎么审、怎么发。
留给开发者的问题很实际:如果大部分代码由 AI 写、AI 审、存在 AI 公司的平台上,今天这套以人为中心设计的 GitHub 工作流还够用吗?你所在的团队,准备好让 Codex 接管从第一个分支到上线发布的全流程了吗?
ID:7873