大模型把知识压进参数里,代价是知识被冻结、来源不可见、长尾覆盖稀薄。检索增强生成换了个思路:不逼模型记住,而是在它开口之前,把相关资料递到它眼前。用户提问先走信息检索,从外部库捞出相关片段,再连同问题一起塞进上下文窗口,让模型基于证据作答。
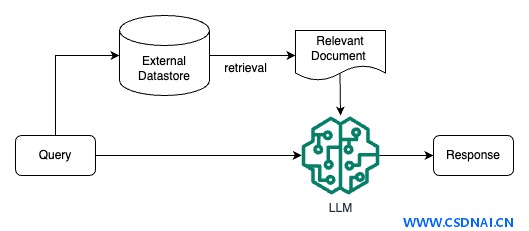
这条路线夹在两种极端之间。搜索引擎只有检索能力,没有生成;纯参数化模型只有记忆,没有实时外挂。RAG 把两者接起来,本质是把外部知识加载进模型单次生成能接受的最大文本输入,也就是工作内存。
四类痛点决定了它存在的理由
长尾知识是第一个。ICML 上有篇论文专门量化过:预训练语料里某领域的文档越多,模型对该领域事实问答的准确率越高,两者强相关。结论很直白——模型对冷门知识的学习能力偏弱。往训练集里灌长尾数据、或者把参数量堆上去,确实有效,但成本不成比例。检索是在推断时补料,性价比高得多。
私有数据是第二个。通用模型预训练用的基本是公开语料,企业内部规章、客户档案这类东西它没见过,问起来要么说不知道,要么编。走预训练或微调把私有数据灌进参数,迭代慢、花钱多,而且已有研究表明特定攻击手法能诱导模型泄漏训练数据,私有信息进了参数就是隐患。把私有数据放在外部库,按需检索,训练成本省了,泄漏面也收窄了。
数据新鲜度是第三个。价格、政策、库存这类高频变动的信息,一旦固化进参数就注定过时。外置成库,更新数据源即可,模型不用重训。
可解释性是第四个。裸模型的输出不给依据,出了错很难定位。检索增强让每条回答都挂着参考片段,来源可追溯,可控性明显提升。
有人会问:上下文窗口越做越长,是不是直接全塞进去就行,检索可以省了?不行。窗口再长也有上限,长上下文里模型对中段信息的利用率会下降,而且全量塞入的 token 成本和延迟都不可接受。检索解决的是“选哪些进去”,不是“能不能装下”。
三个关键模块与检索层的工程细节
数据和索引模块负责把多来源、多格式的外部数据归一成统一的文档对象。文档对象不只有正文,还带元信息,元信息在后期检索和过滤时是硬通货——按时间、按部门、按权限筛,往往比纯向量相似度更可靠。
查询和检索模块决定召回质量。这里有几个绕不开的工程选择。索引结构上,HNSW 召回高、延迟低,但内存占用大,构建慢;IVF 系列靠聚类分桶,内存友好,召回依赖 nprobe 参数,调小了漏、调大了慢。数据量在百万级以内、对延迟敏感的场景,HNSW 通常是默认选项;上亿级别且内存受限,才考虑 IVF 或量化变体。
top-k 和相似度阈值也不能拍脑袋定。k 太小,关键片段可能没进上下文;k 太大,噪声片段稀释信号,还挤占窗口。实践中的做法是先固定一个偏大的 k 做召回,再用重排模型精排取前若干条,同时设一个相似度下限过滤明显不相关的块。判定标准可以这样设:构造一批带标准答案的查询集,观察命中率随 k 的变化曲线,取曲线趋于平缓的拐点。
响应生成模块负责把检索结果和问题拼成提示词。拼接时要注意截断策略——按 token 预算从高相关到低相关依次填充,超预算就丢尾部,别让低分片段挤掉高分片段。另外,检索片段之间要有明确分隔符,否则模型容易把不同来源的内容混成一段。
三种调用模式,对应三种数据诉求
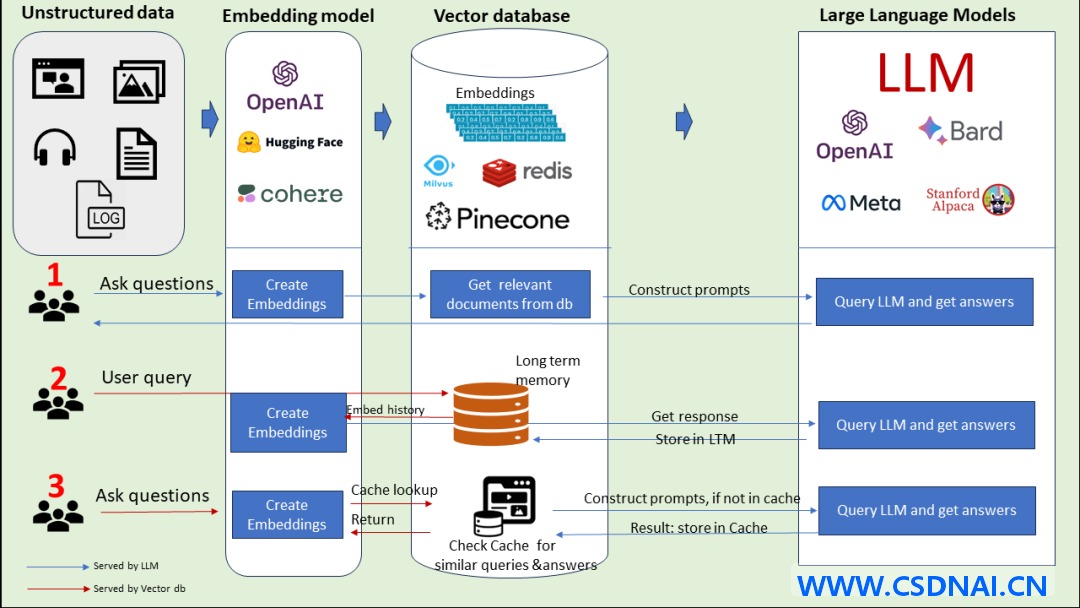
模式一是最经典的离线索引加在线检索。非结构化数据经嵌入模型向量化后入库,查询时构造提示词交给模型,结果直接返回用户。适合知识库问答这类静态为主的场景。
模式二在问答之后多做一步:把问题向量化存进长时记忆库,模型回答完再把答案也写回去。这解决的是跨会话记忆问题,让系统记得之前聊过什么。
模式三引入缓存层。问题向量化后先去缓存里找相似的历史问答,命中就直接返回,没命中才走模型,回答再回填缓存。高频重复提问的场景下,这一层能显著压延迟、降成本。
三种模式不是互斥的,实际系统常常叠着用:缓存挡在前面,记忆库管会话,主库管知识。
和微调比,边界在哪
RAG 和 SFT 常被摆在一起比,但两者解决的不是同一类问题。
数据动态性上,RAG 每次查询都读外部源,信息天然最新,不用重训;SFT 学进去的是相对静态的知识,数据一更新就可能过时,而且不保证记住。
知识来源上,RAG 擅长整合外部结构化或非结构化库;SFT 能把预训练学到的知识对齐到特定任务,但对频繁变动的数据源不实用。
模型定制上,RAG 只管信息检索,改不了模型的语气和写作风格;SFT 恰恰擅长这个,能按特定术语、特定口吻调整行为。
幻觉控制上,RAG 的每个回答都建立在检索证据上,相对不容易编;SFT 靠领域数据压低幻觉,但遇到没见过的输入照样会编。
透明度上,RAG 把生成拆成检索和生成两段,能给出匹配度;SFT 是黑箱,推理过程不透明。
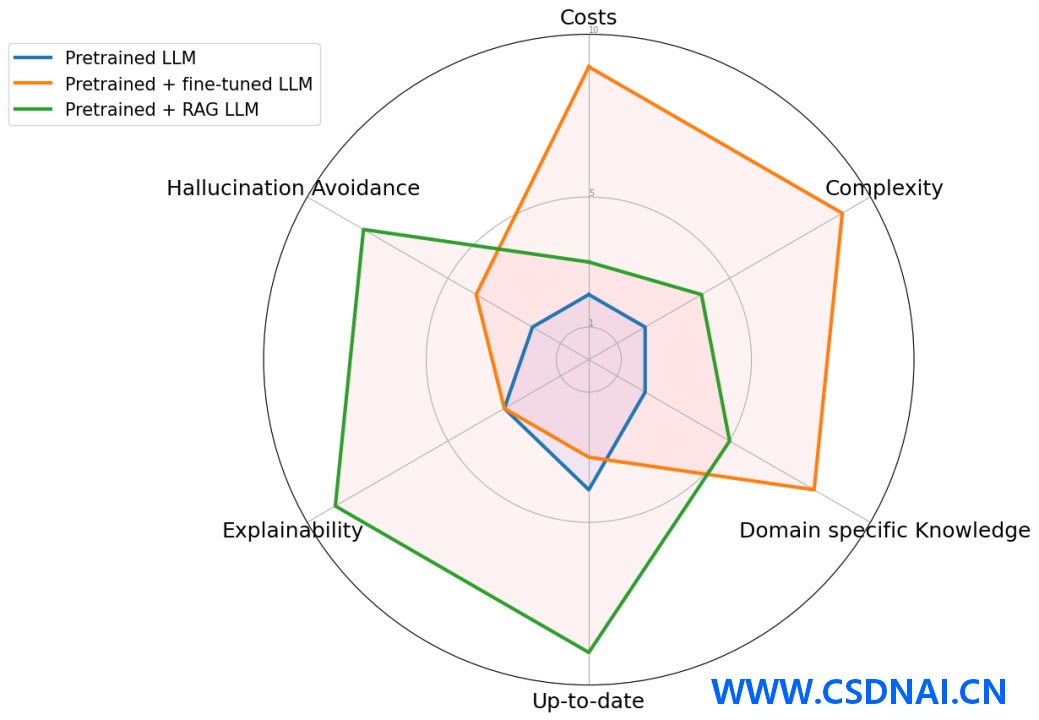
雷达图把预训练、预训练加微调、预训练加 RAG 三种路线摆在一起比,RAG 在成本、时效、可追溯性上占优,在行为定制上吃亏。
这里要补一句原文没展开的:RAG 并非万能。多跳推理类问题——答案需要串起多个分散片段才能得出——单轮检索经常捞不全,得配合查询改写或多轮检索。全局摘要类问题,比如“这批文档整体讲了什么”,向量检索按相似度捞局部片段,天然不适合,这类场景要么换聚类摘要,要么退回长上下文方案。反过来,需要严格统一输出格式、固定话术的场景,SFT 更稳,RAG 管不住风格。
所以真实项目里常见的是混合路线:用 SFT 对齐输出格式和领域语气,用 RAG 兜住事实性知识和时效性数据。两者叠加,各管一段。
选型时先问三个问题:知识变不变、要不要溯源、输出风格要不要锁死。答案清楚了,路线基本就定了。
ID:7088







