C# 的 async/await 从诞生起就是编译器主导的语法变换。你写下 async 关键字,编译器就把方法拆成状态机,await 处切成一个个 case 分支,靠 MoveNext 驱动。这套机制跑了很多年,问题也积累得很清楚。
状态机变换到底损失了什么
编译器处理异步方法时,编译单元是单个方法。它看不到被调用方的实现,所以哪怕 GetValueAsync 只是 return 42,GetDataAsync 依然会被生成完整的状态机和 Task<int>。这是第一层浪费。
更麻烦的是 JIT 的处境。代码交到 JIT 手上时,原始的 A → await B → await C 调用链已经被拆成了状态机、awaiter、continuation 之间的交互。JIT 想跨方法优化,面对的是被拆散的残骸。而 MoveNext 方法体通常很大,JIT 出于体积考虑往往拒绝内联,跨方法优化基本无从谈起。
第三层是分配。每次调用异步方法都可能新建一个 Task。ValueTask 和 IValueTaskSource 缓解了这个问题,但只是缓解。
真正暂停时,这些开销都合理——你确实需要一个对象存结果、存恢复状态。可现实是大量异步方法根本不暂停:调用链只有最里层真正挂起,上层只是传结果;或者异步方法调同步方法、同步方法再调异步方法,整条链实际是同步的。分布式计算系统里这种形态尤其常见。为不暂停的调用付状态机的钱,才是核心痛点。
Green Thread 为什么被放弃
在 Runtime Async 之前,.NET 试过用户态轻量级线程,思路和 goroutine、Java 虚拟线程一致。结论是放弃,原因值得记一下。
轻量不等于免费。一个 Green Thread 仍是完整执行上下文,要存寄存器、调用栈、调度元数据。goroutine 初始栈约 2 KB,这 2 KB 够建几百个 async 状态机了。调度还得在用户态自己实现,和运行时深度耦合,开发者失去控制权。
系统调用是硬伤。Green Thread 不是 OS 线程,真正的 syscall 仍要落到承载它的系统线程上,切换、挂起、恢复一套下来开销可观。.NET 实测在 Green Thread 上做一亿次系统调用,耗时从约 300 ms 涨到约 1800 ms,慢了五倍以上。
还有硬件层面的冲突。Intel CET Shadow Stack 由硬件维护受保护的返回地址栈,函数返回时校验一致性。Green Thread 在用户态自行切换调用栈,运行时必须同步维护 Shadow Stack 状态,集成复杂度陡增,甚至需要 OS 专门支持。线程亲和性同样棘手:GUI、部分 OS API、thread-local 代码都依赖固定系统线程,消息循环每秒上万次调用亲和 API 时,调度开销可能反超系统线程。
最终结果很直接:扔进 ASP.NET Core 压测,RPS 不升反降。实验终止,转向 Runtime Async。
把控制流还给 JIT
Runtime Async 的思路一句话:编译器别动,把原始异步控制流留给 JIT。
运行时引入一套新的调用约定,内部用 MethodImplOptions.Async 标记,用户代码写法不变,仍是 async/await。区别在于 JIT 看到的不再是现成的 MoveNext,而是方法本来的异步控制流,按 async calling convention 编译。
这套约定在普通调用之外多传一个 Continuation。普通调用是 result = B(args),Runtime Async 下变成 (result, continuation) = B(continuation, args)。首次调用传入 null,方法像同步方法一样从头跑。全程没暂停,就直接返回结果,同时返回空 Continuation 表示链路未挂起。某个 await 等不到完成,运行时保存恢复所需状态,返回非空 Continuation 给调用方。等被等待的操作完成,运行时再次进入该方法,把之前保存的 Continuation 传回去,从暂停点续跑。
关键在 ABI 层面:返回值和 Continuation 都是调用约定的一部分,能直接走寄存器,不需要先包成对象。只要目标架构允许,两者都进寄存器。不暂停时,参数走寄存器、返回值走寄存器、Continuation 也走寄存器,每层 async 调用的结果包装对象开销归零。方法签名写着返回 Task<T>,但整条链不暂停时,这个 Task 压根不会被创建,直接返回 T。
JIT 还能看到完整控制流,跨方法优化和内联都成为可能。
反汇编里看到的样子
拿递归斐波那契举例:
class Program
{
 async Task<int> Fib(int n)
 {
 if (n <= 1)
 return n;
 return await Fib(n - 1) + await Fib(n - 2);
 }
}
ILSpy 反编译后只剩原始逻辑加 AsyncHelpers.Await 调用,没有任何状态机。JIT 生成的内部版本签名是 Program:Fib(int):int:this,返回类型已不是 Task<int>。x64 上参数走寄存器:this 进 rdi,Continuation 进 rsi,n 进 edx。
第一次递归调用编译成 lea edx, [rbx-0x01]、xor rsi, rsi(Continuation = null)、call。返回时 eax 是 int 结果,rcx 是 Continuation,两个独立返回通道。调用方 test rcx, rcx 判断是否暂停:rcx 为 null 说明同步完成,eax 即有效结果,直接继续。
rcx 非空则当前方法也得挂起,此时才真正分配 Continuation:call [CORINFO_HELP_ALLOC_CONTINUATION],把恢复时还活着的局部变量写进去(如 mov dword ptr [r12+0x48], ebx 存 n),最后 mov rcx, r12 沿约定返回上一层。这个对象只存几十字节——跨暂停点存活的局部变量、恢复位置、被等待操作的结果或异常状态。相比 Green Thread 的完整上下文,量级完全不同。
Fibonacci 例子里所有调用都同步完成,实际执行路径等价于 var r1 = Fib(n-1); var r2 = Fib(n-2); return r1 + r2;,没有 Task,没有状态机。
那为什么还有 Program:Fib(int):System.Threading.Tasks.Task\1[int]:this?因为外部 C# 调用方看到的签名仍是Task<int> Fib(int)。运行时需要在两种调用约定之间放一个边界,即 async thunk。thunk 先以 null Continuation 调用真正的 Runtime Async 方法,检查返回的 Continuation:为 null 就直接包一个Task<int>` 返回。如果 thunk 能被内联、JIT 又能证明 Task 不逃逸,逃逸分析还能把这次分配也消掉。
启用方式与兼容性边界
Runtime Async 依赖运行时支持,不是改个编译选项就生效。它由运行时配置开关控制(DOTNET_RuntimeAsync 系列配置),需要 .NET 11 及以上的运行时与对应 SDK 配合。目标框架降级到 .NET 10 或更早时,代码照常编译运行,但走的是传统状态机路径,性能特征完全不同——跨版本对比测试时必须确认开关状态,否则数据没有意义。
兼容性上有几处要留意。自定义 [AsyncMethodBuilder] 的异步方法,其构建器语义与 Runtime Async 的调用约定并不重合,这类方法仍按传统路径处理。返回 ValueTask / ValueTask<T> 的方法在 Runtime Async 下同样受益于不暂停路径的零分配,但一旦暂停,IValueTaskSource 的复用逻辑仍由原实现负责,不能指望运行时替你优化。另外,依赖 AsyncLocal<T> 或 ExecutionContext 精确捕获时机的代码,在暂停点语义上与传统模型保持一致,但不要假设 Continuation 的分配时机和状态机对象相同——诊断工具里看到的对象类型和数量会变。
自己验证优化是否生效
别只看基准数字,先确认你的构建真的走了 Runtime Async。用 DOTNET_JitDisasm 指定方法名导出反汇编,看两件事:方法体里是否出现 CORINFO_HELP_ALLOC_CONTINUATION 调用(说明暂停路径存在),以及是否存在独立的 thunk 方法。如果反汇编里是熟悉的 MoveNext 加状态机字段访问,说明开关没生效或该方法不受支持。
运行时分配可以用 dotnet-counters 观察 gen-0 GC 计数和分配速率。对一条确定不暂停的调用链做高频调用,传统 async 下分配率随调用次数线性增长,Runtime Async 下应基本持平在基线水平。这是比微基准更贴近生产的判定方式。
性能数据说明了什么
测试覆盖同步基线、不暂停异步方法、已完成 Task/ValueTask 的 await、Task.Yield 暂停、ThreadPool continuation、TaskCompletionSource continuation、多层状态机链,预热后各跑一亿次,对比 .NET 11 每日构建的 Runtime Async 与 .NET 10 的传统 async。
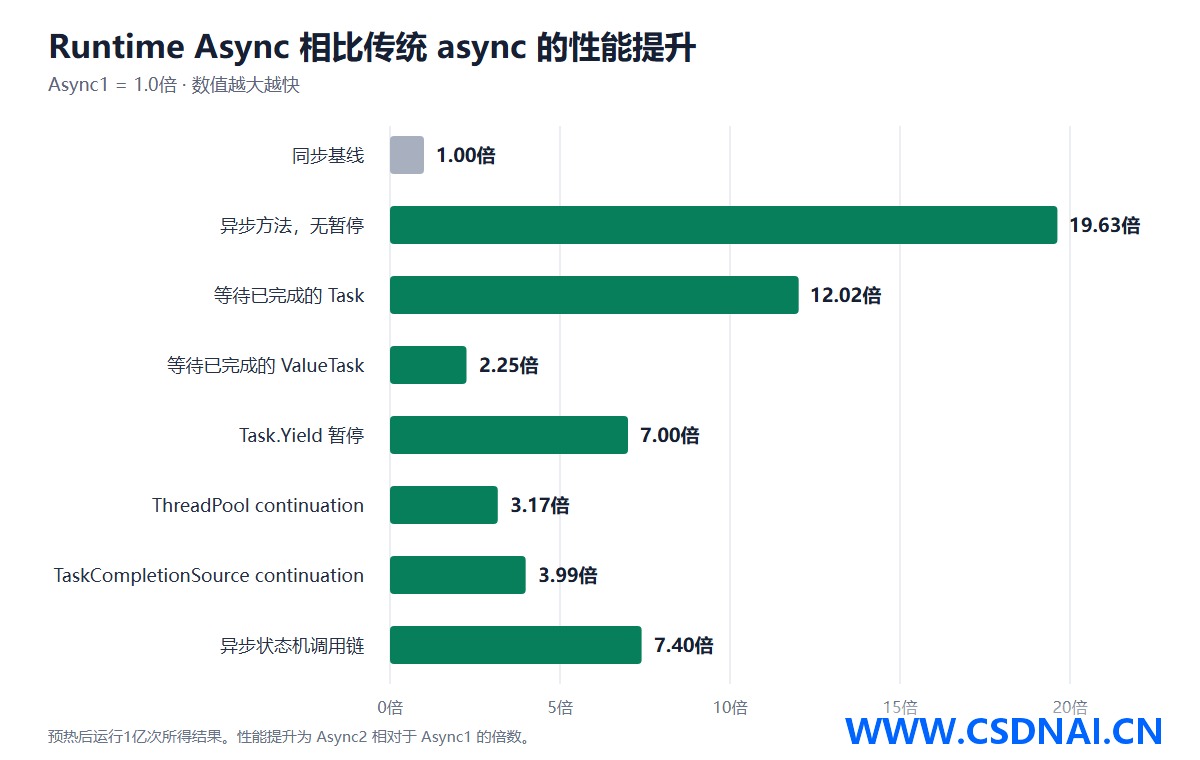
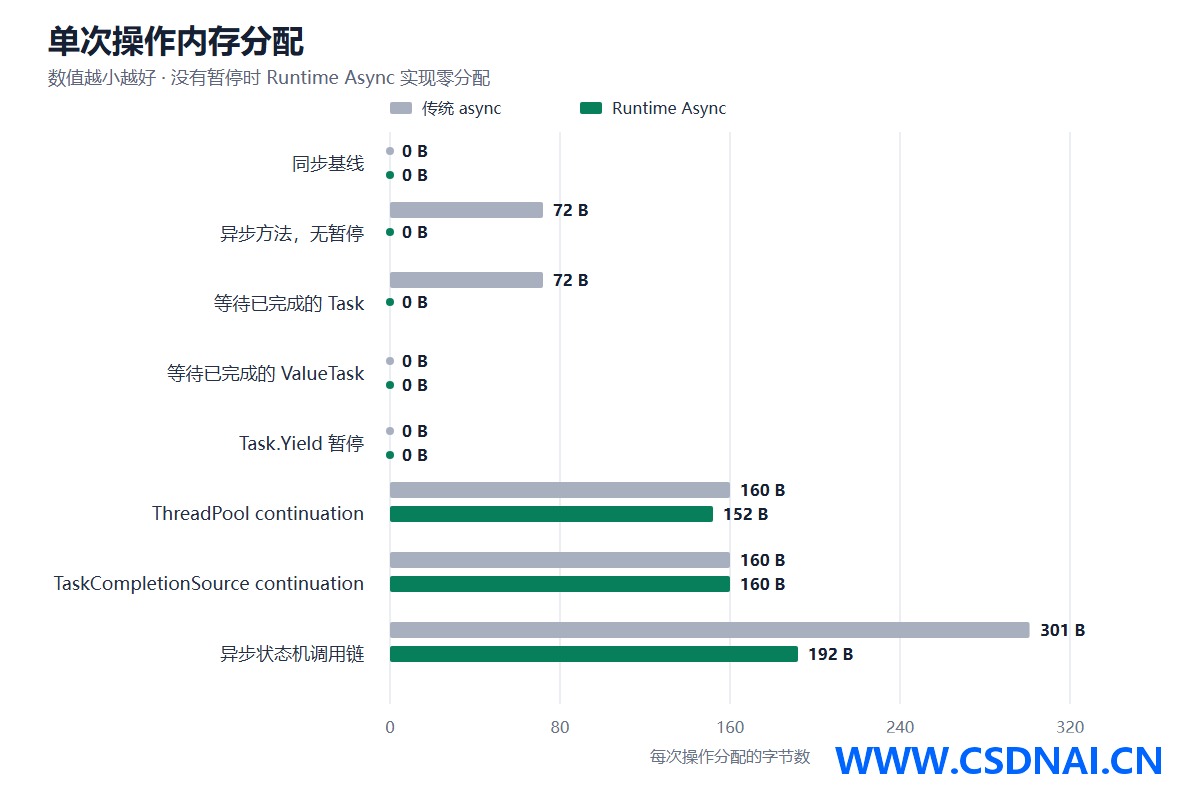
不暂停场景是最大亮点。普通异步方法从 6.58 ns 降到 0.34 ns,约 19.6 倍;等待已完成 Task 从 4.01 ns 降到 0.33 ns,约 12 倍;两者都已贴近 0.33 ns 的同步基线。内存分配从 7.20 GB 直接归零,整个调用链没有 Task、没有状态机。
暂停场景同样有收益。Task.Yield 暂停从 242.89 ns 降到 34.68 ns,7 倍;ThreadPool continuation 从 324.78 ns 降到 102.35 ns,约 3.2 倍;TaskCompletionSource continuation 从 455.50 ns 降到 114.16 ns,约 4 倍。多层状态机链从 678.33 ns 降到 91.68 ns,7.4 倍,且调用链越深收益越大。分配上,状态机链从 30.10 GB 降到 19.20 GB。
这些数字的含义是:异步抽象的代价从”每次调用都付”变成”真正暂停才付”。不暂停时几乎和同步调用无差别,暂停时也只为你实际用到的状态买单。对深调用链和异步模型搭建的分布式系统,这是实打实的吞吐提升。
ID:6919