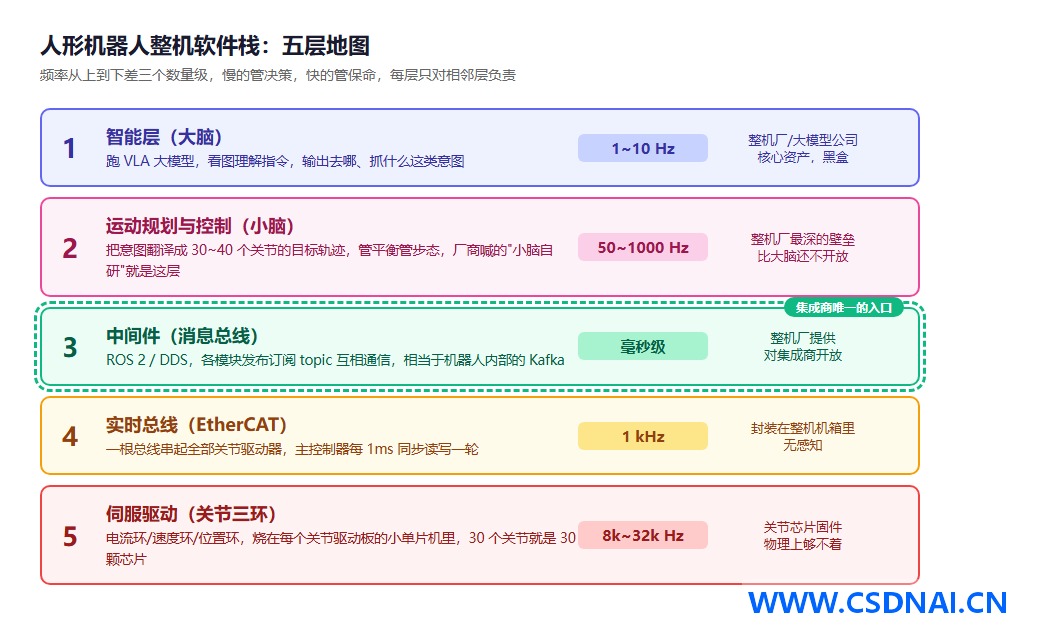
一台人形机器人身上跑着五套软件,工作频率从 10Hz 一路爬到 20kHz,横跨三个数量级。这个频率落差本身就是一道物理分界线:谁跑在哪个频段,谁就守哪块地盘。集成商真正能伸手的只有中间那一层,代码挂上去,价值却长在机器人外面。
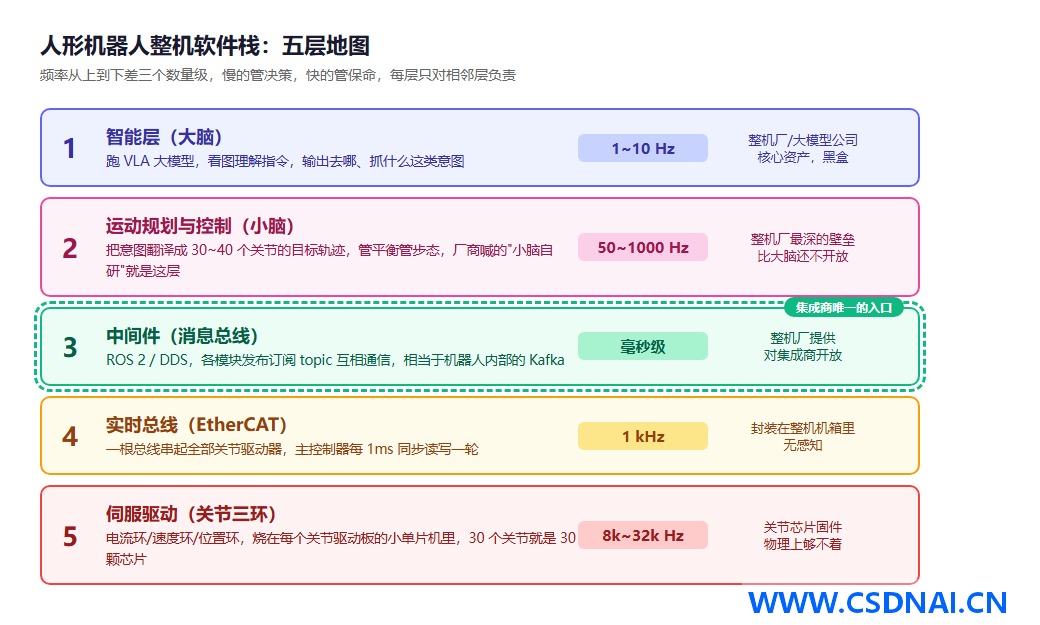
先把归属讲清楚。最上面两层是任务规划与运动规划,整机厂的核心资产,黑盒交付,你只能调它吐出来的任务级接口。最底下两层是实时总线和关节三环控制,焊死在机箱和关节驱动芯片里,日常开发根本感知不到。中间那层中间件,是整机厂主动敞开的口子,也是你唯一的入口。
选型时别盯着谁家步态更稳、谁家总线更快。那些从签合同那天起就与你无关。该比的是中间件暴露了哪些 topic、哪些服务,文档是不是能让人看懂。
中间件的三层结构与替换点
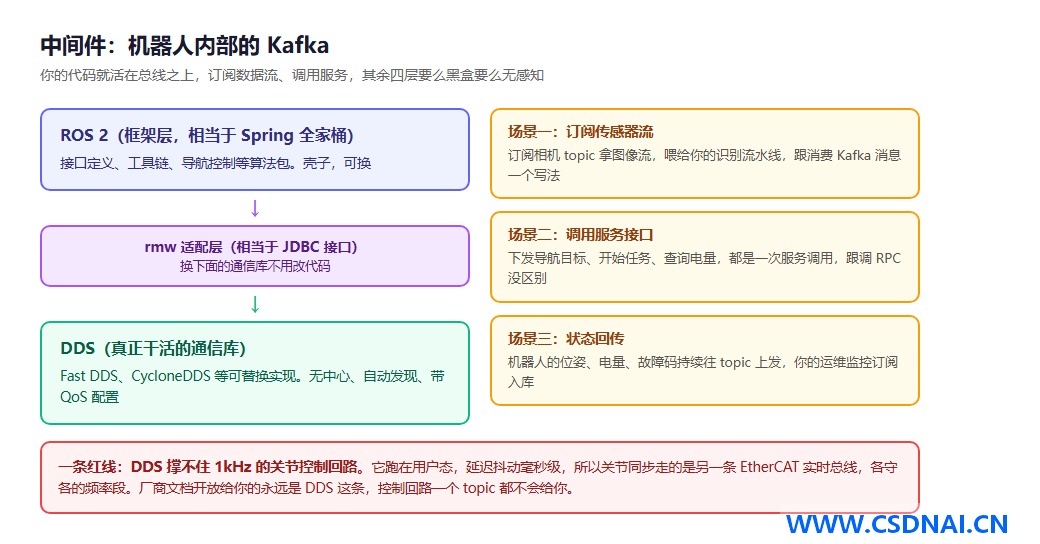
拿企业中间件类比最省事:它就是机器人内部的 Kafka 加 RPC。
结构上三层套着。ROS 2 是开发框架那层壳,地位类似 Spring 全家桶;底下真正搬数据的是 DDS 通信库,Fast DDS、CycloneDDS 都是它的实现,可以整体替换;中间夹一层 rmw 适配层,作用等同 JDBC,换通信库不用动上层代码。厂商给你的接口本质就是 DDS 的 topic 加服务调用,用不用 ROS 2 那层壳随你。
版本这块有实打实的坑。ROS 2 的 LTS 节奏是两年一版,Humble 支持到 2027 年 5 月,Jazzy 到 2029 年 5 月,Kilted 是短期版,2025 年 11 月就 EOL。生产环境别踩短期版。切换 DDS 实现靠环境变量 RMW_IMPLEMENTATION=rmw_cyclonedds_cpp 或 rmw_fastrtps_cpp,改完用 ros2 doctor --report 确认 rmw 实际加载的是哪个,再跑一遍 ros2 topic hz 看频率是否达标。别信配置文件,信运行时输出。
用法上手感和消息队列一模一样。要图像,订阅相机 topic,流持续进来,写法就是消费 Kafka;要机器人干活,调一次导航服务传目标坐标,等同调 RPC;要监控,位姿、电量、故障码一直往 topic 上发,运维系统订阅入库即可。写消费者的经验在这里直接平移。
有条红线得记住。DDS 跑在用户态,延迟抖动在毫秒级,撑不住 1kHz 的关节控制回路,所以关节同步走另一条 EtherCAT 实时总线,各守各的频段。厂商文档开放给你的永远是 DDS 这条,控制回路一个 topic 都不会放出来,看到空白不用意外。
图像流的真实瓶颈与 QoS 调优
巡检场景里最容易翻车的不是控制,是图像。默认 QoS 下,大分辨率图像 topic 一开就丢帧,原因通常是 Reliability 设成 RELIABLE 又没配 History depth,或者单条消息超过 DDS 默认分片阈值。
调优方向:图像流用 BEST_EFFORT 加有限 depth,别追求零丢帧,巡检要的是连续帧率不是每帧必达;单帧超过 1MB 时确认 max_message_size 和分片参数,CycloneDDS 的配置项和 Fast DDS 不通用,换实现要重配。更稳的做法是图像不进 DDS 主通道,走共享内存或单独的视频流通道,DDS 只传元数据和触发信号。这条在变电站这种多相机并发场景里能省掉大量排查时间。
ROS 2 从 Kilted 起把 Zenoh 抬到和 DDS 平级。单机里两者差距不明显,机器人一多,Zenoh 轻量、扛弱网的优势就出来了。但别神化它:强实时、单机小规模、依赖成熟 DDS 工具链的场景,Zenoh 不是更优解,混用两套中间件还会带来桥接延迟和调试复杂度。多机平台选型时再考虑它。
变电站巡检:九成工作在机器人之外
入口清楚了,看真实项目长什么样。变电站巡检结构很固定:机器人按任务自主巡检,到点位用可见光加红外拍摄,识别表计读数和热缺陷,结果回传后台生成报告,最后进客户系统。交付物拆开五块。
做在机器人上的只有一块半。任务与调度,客户说早晚各巡一次、雨天加巡,你的系统翻译成任务队列,调导航服务下发,跟踪状态、失败重派——这半块要碰机器人,但方式只是调接口。点位库,工程师遥控机器人在每台设备前摆位、调云台角度和变焦,点保存,十几个参数存库绑定设备条目——现场工作在机器人上做,成果存在你后端,算半块。
剩下三块半全在软件平台。识别流水线,图像从 topic 进消息队列,采购的模型推理,结果与阈值比对出告警,厂商不管这段。客户系统对接,告警进 PMS、报告按规范出格式,纯工程苦活,但验收卡的就是它。运维监控,组队状态、远程接管、数据回流,加上调度和点位库的服务端部分,全是后端系统。
算下来九成落在机器人外面。一个后端团队加一个懂电力现场的人就能接,控制工程师一个不需要。五块里唯一值得沉淀成资产的是点位库:数据在你服务端,机器人只是无记忆执行器,任务来了逐点下发坐标和云台参数。换机器人、多站部署,点位库跟着你走。
多机协同:平台才是资产
机器人一多,生意就变了。一个站点里轮式守室外平地、四足爬楼梯跨楼层,平台上挂一张统一任务队列,来了巡检任务,调度系统看区域、看空闲、看电量,把任务分下去,状态实时回传。底层用 Zenoh 这类中间件把几十台机器人连成一张网,地图和点位库全平台共享。
这套东西的价值在于跟形态无关、跟厂商无关。轮式、四足、人形,宇树的、云深处的,接进同一个平台。机器人三年一换代,点位库、任务数据、调度规则不换。单台机器人是耗材,平台是资产。
场景也现成。变电站面积大设备多,一台巡完要仨小时,三台分区并行一小时收工;电厂有室外设备区、室内配电房、地下管廊,一种形态跑不全,轮式四足混编才覆盖得住;一个地市公司下面几十个站,任务统一排期、机器人统一调度、告警统一归口,这就是一张网管一个 fleet 的合同。
把账收拢:五层软件栈,上下四层归整机厂,你从中间件进去;进去发现九成交付在机器人外面,任务调度、点位库、识别流水线、客户对接、运维监控,全是企业软件的老本行;机器人多了再加一块多机协同平台,形态无关、可沉淀。运动控制是整机厂的事,你通过中间件接入,集成商的价值长在机器人之外,用企业软件的方法论做行业软件的生意。
ID:6914