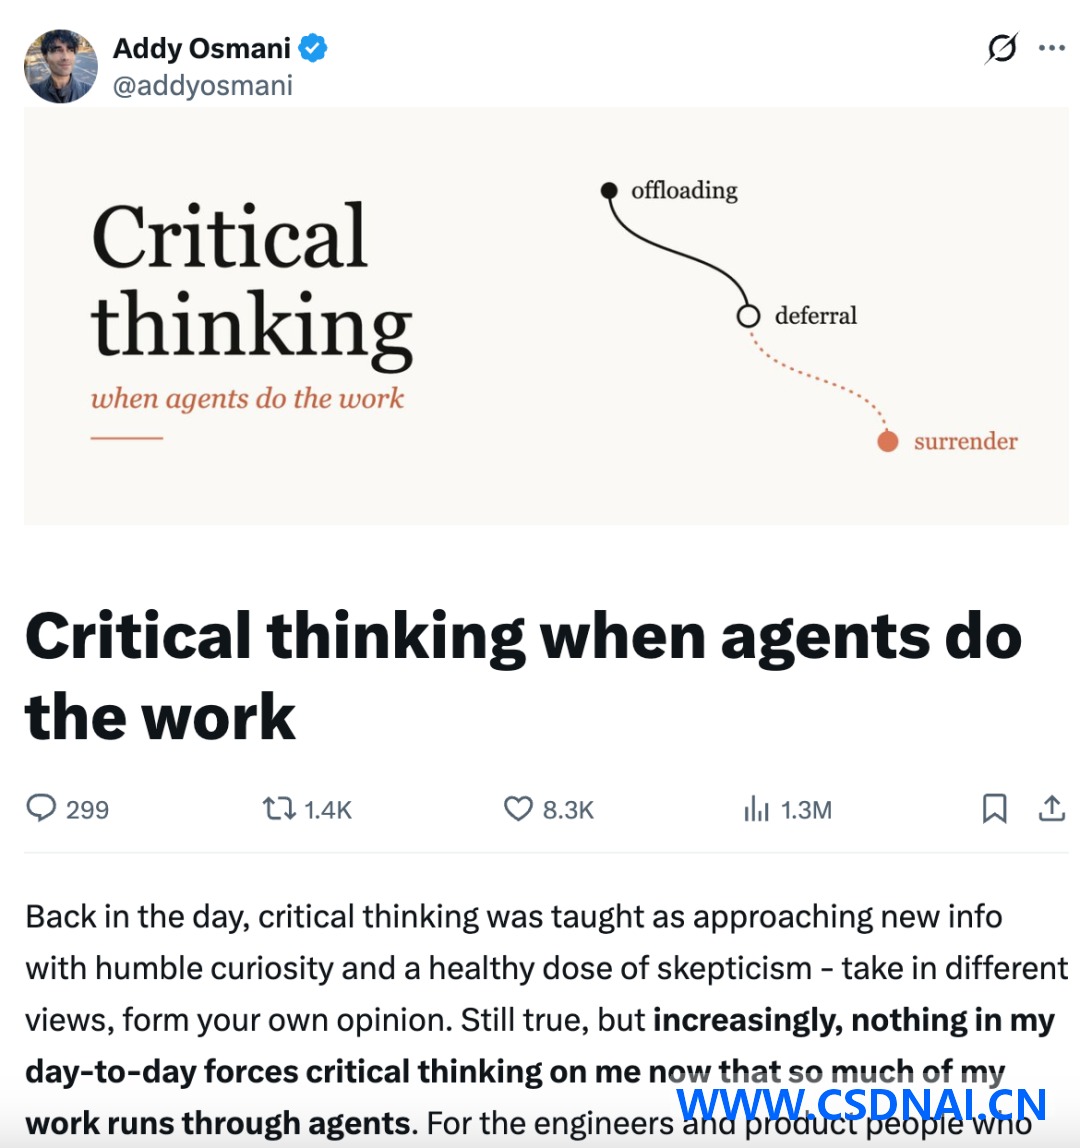
Addy Osmani在Anthropic参与Claude Code的开发,之前他在Google待了十四年,Chrome DevTools和Lighthouse都有他的手笔。这人写教程出了名地勤快,Agent工作流、代码审查、Claude Code技巧轮着来。这次他盯上的是一个不太好受的话题:AI越靠谱,人越容易停止思考。
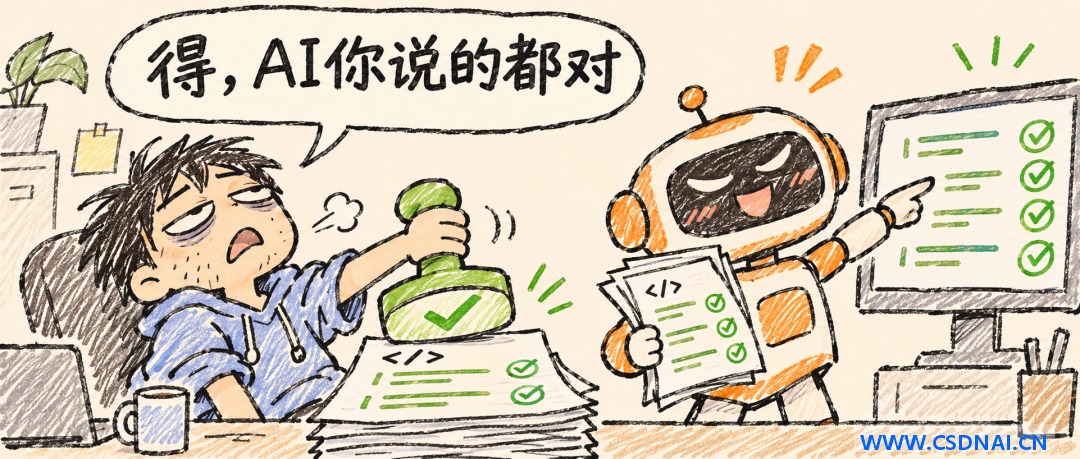
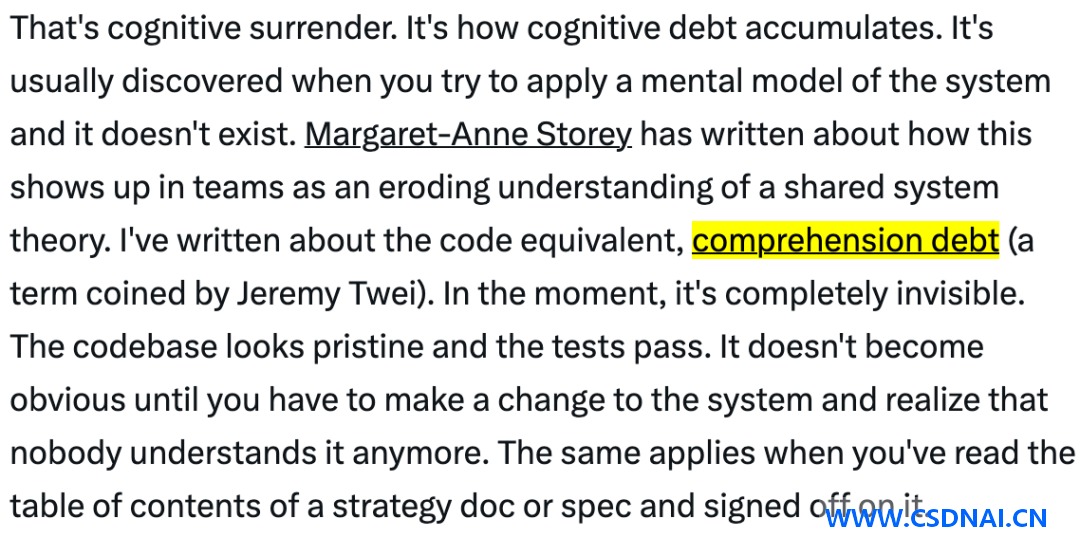
他把这个滑坡拆成三段。第一段叫认知卸载,活交给AI干,但自己仍然清楚任务是什么、结果对不对。第二段是判断让渡,AI的答案慢慢变成下一步工作的默认前提。第三段才是认知投降——连本该自己做的判断也一并交出去了。代码能跑、测试全绿,手一挥批准,等有人问起这段逻辑为什么这么写,答不上来。
六百行PR里藏着的理解债
一个典型场景:Agent一口气提了六百行的PR,结构清爽,测试通过,合并。但它在某个不起眼的位置调换了事务处理顺序,或者挪了一个边界条件。当时不报错,等线上出问题,开发者连这段代码为什么这样跑都解释不清。
这类欠账会累积。Addy给它起了个名字,理解债(Comprehension Debt)。代码量在涨,系统复杂度在涨,开发者对代码的理解没跟上。等到要改某个功能,才发现这座楼盖起来了,内部结构没人摸得清。
不是说每行AI生成的代码都得逐字读完。Claude Code团队自己也不要求工程师背下整个代码库,需要改某块时借Claude重新理解就行。前提是你得清楚自己懂什么、哪里还没懂。分不清这条线,写得越快,欠得越多。
把考官的位置让给Agent
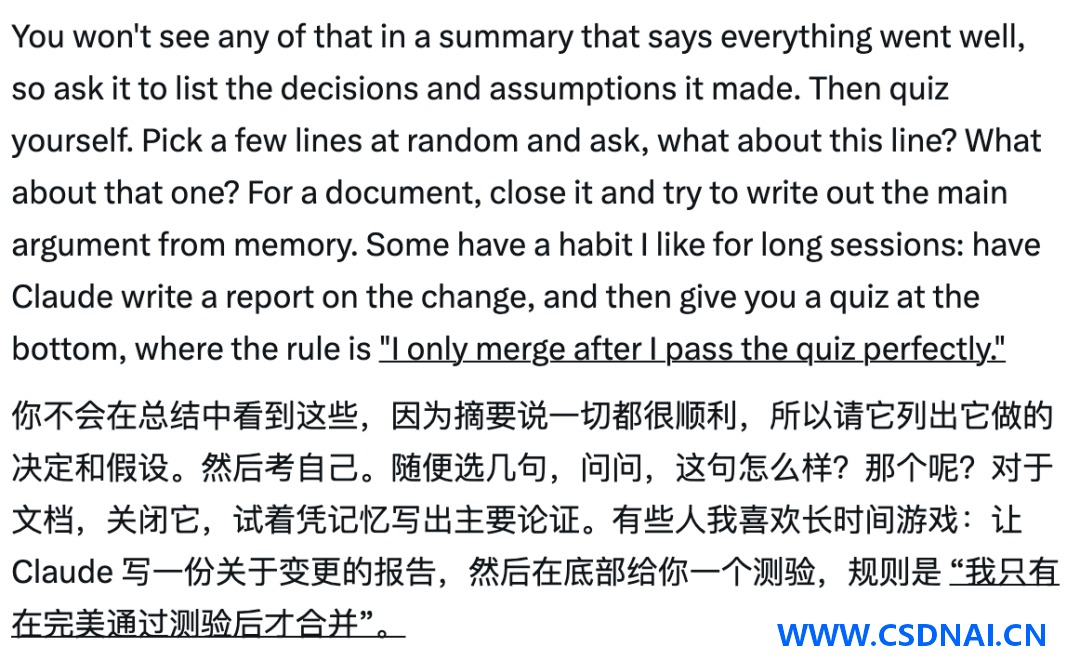
Addy最实用的一招是反转角色。Claude刚完成一次大改,先别点通过。让它总结改了哪些地方、为什么这么改,再根据改动内容给你出几道题,立一条硬规矩:测验全对,代码才能合并。
这招要实现,光靠口头约定不够。Claude Code支持在项目根目录放一个CLAUDE.md,把规则写进去,每次会话自动加载。比如约定:涉及事务、并发、边界条件的改动,提交前必须附一份自测题清单,开发者作答通过后才允许进入合并流程。权限模式上可以配合使用,把合并类操作设为需确认,避免Agent自己把闸门放开。
意图债:Prompt之前先自己列清单
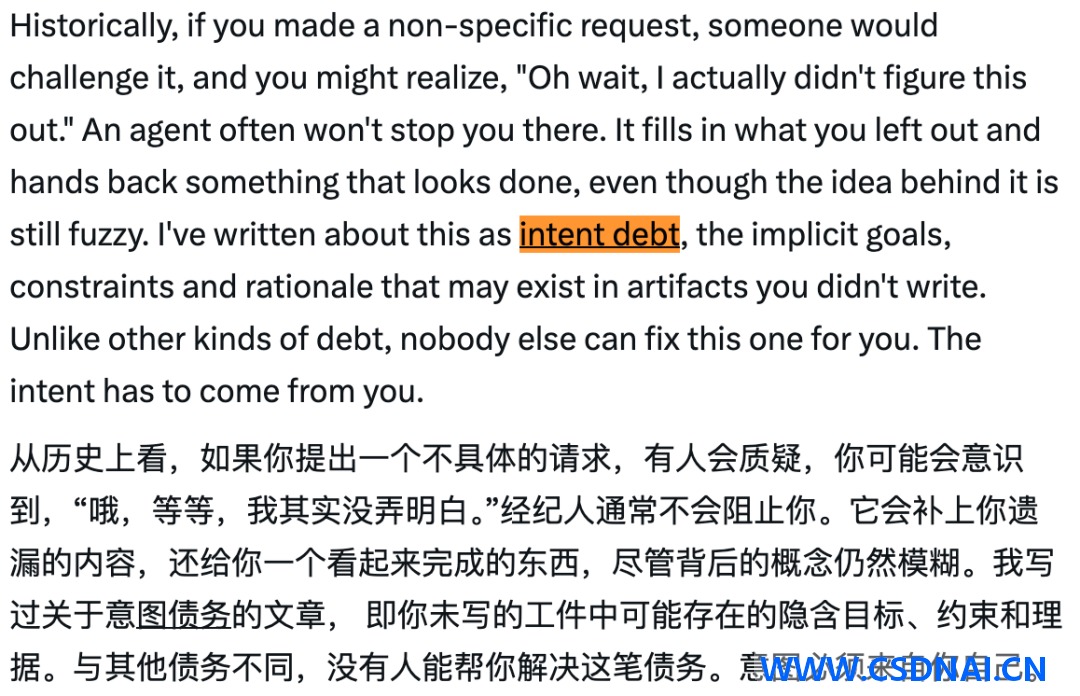
Agent太擅长补全需求了。你还没想明白要什么,它已经交出一份像模像样的东西。问题在于,需求里那些没说清的目标、限制和取舍,被它替你决定了。Addy管这叫意图债(Intent Debt)。
对策是动手前先用自己的话写一份简短说明:面向谁、解决什么问题、哪些不做、做到什么程度算完。有个经验判据——连续两轮调整Prompt还拿不到想要的结果,就该回头重梳需求,而不是继续往上堆提示词。堆提示词本质是在让Agent猜你的意图,猜出来的东西迟早要还。
追问它没告诉你的事
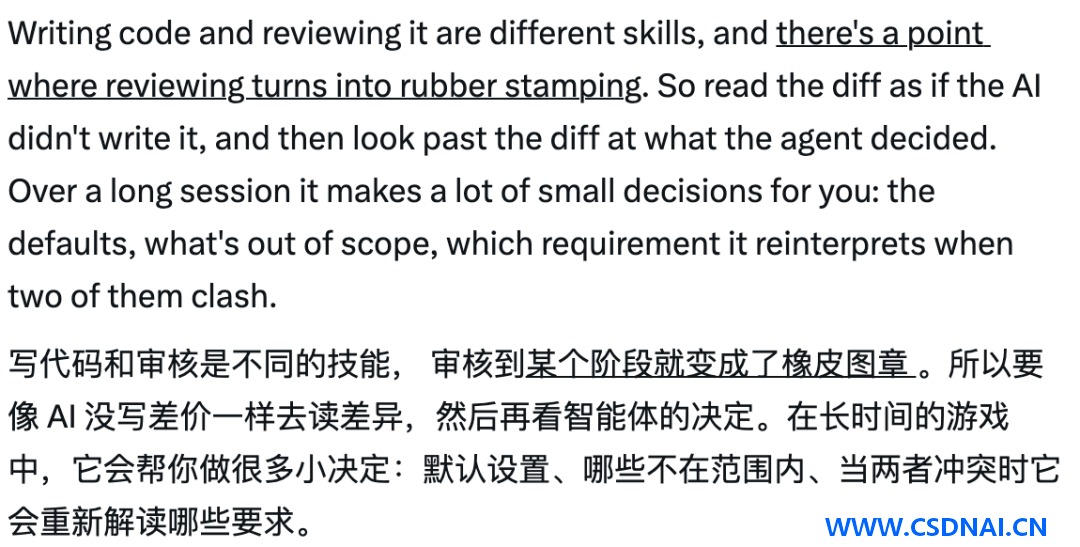
长任务尤其需要这一手。Agent执行过程中会自行选默认参数、调整实现范围、在需求冲突时做取舍。这些决定未必写进最终总结,甚至自然到它自己不觉得是个决定。
所以别只问“完成了吗”。接着追问:你做了哪些我没有明确授权的决定?哪些地方依赖了假设?还有什么没验证?哪些改动可能影响其他功能?
问完之后拿代码和测试结果逐条核对它的交代。这一步的价值在于把隐性决策显性化,你能看到它在哪里替你做了主。
绿色测试只证明它测过的东西
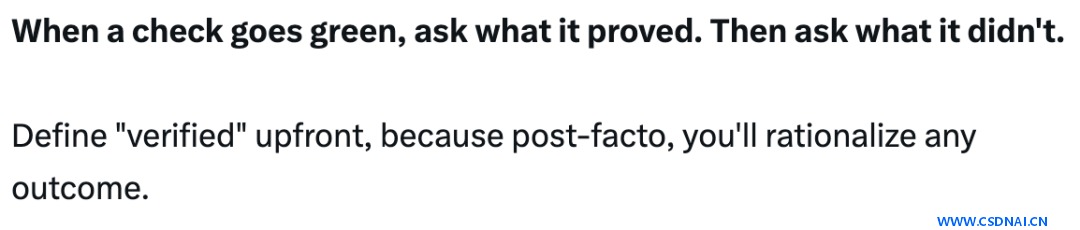
测试全绿只说明覆盖到的条件通过了。边界情况没写进测试,Agent照样能交出一份漂亮的报告。所以顺序要反过来:先看实际执行了哪些测试、返回了什么,再去读AI生成的总结。总结是叙事,测试记录是事实。
高风险改动加一道独立检查,让另一个Agent从不同角度找问题。这里有个容易踩的坑:审查Agent和被审Agent用同一套上下文,容易同向盲区。给审查方喂原始diff和需求说明,别喂前一个Agent的总结。
多Agent接力会稀释原始信息
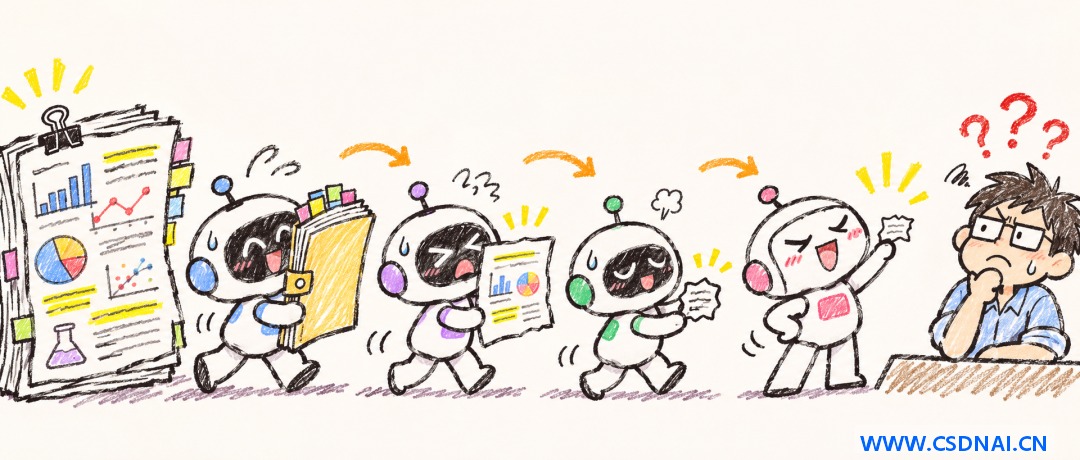
同时指挥几个Agent,一个写前端、一个改后端、一个跑测试,效率确实起飞。但Agent之间的传话有损耗,一个的总结直接成为下一个的输入,传几轮之后离原始资料越来越远,关键细节在半路丢了。
重要任务必须保留原始材料和验证依据。已经多到审不过来的任务,要么补自动化检查,要么先减并行数量。这里给一个可操作的判据:统计每周待审PR数量和实际完成审查的数量,前者持续大于后者,说明并行度已经超过审查吞吐能力,该回退。
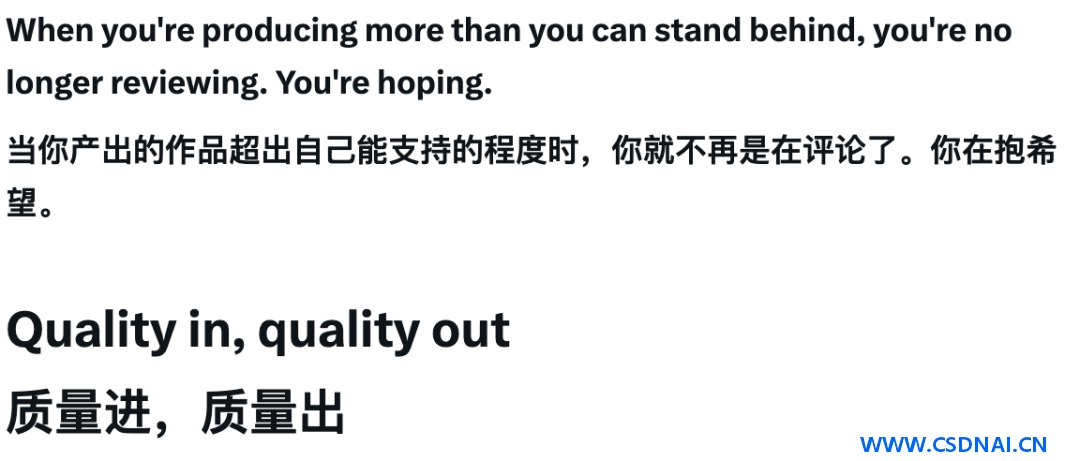
一个粗略的校验办法是看合并队列的滞留时间,用 git log --merges --since="7 days ago" --pretty=format:"%h %ci %s" 拉出近一周的合并记录,对照PR创建时间算平均滞留。滞留持续拉长而合并量没降,基本就是审查在空转。这时候继续加Agent,只是把待审内容堆得更高。Addy那句话说得挺狠:生成的内容多到你无法负责时,你做的不是审查,是在赌它没问题。
每周留一次不碰Agent的编码
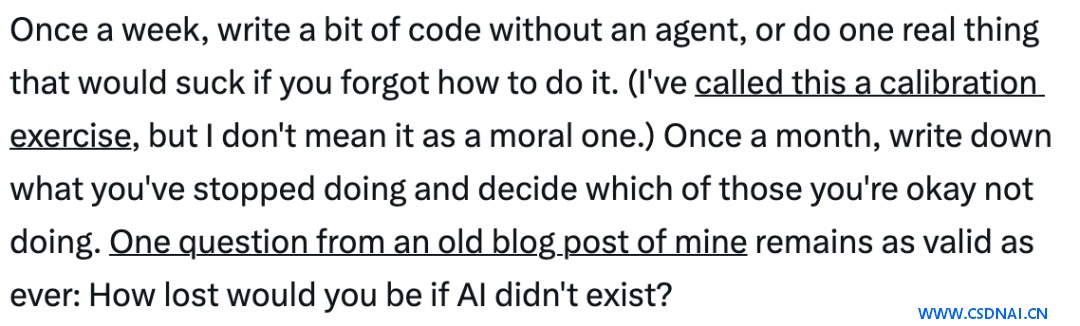
都这个年头了,Claude的工程师劝你偶尔别用Claude。理由很直白:长期不用的技能会退化,脱离Agent独立完成任务能校准你当前的真实水平。他建议每周至少安排一次不依赖Agent的编码练习,每月盘一次账——哪些技能已经交出去了,哪些能放心外包,哪些必须自己握着。
这个练习要有效果,得有验证手段,不然容易变成自我感觉良好。做法是开一个隔离分支,关掉所有Agent辅助,独立实现一个小功能或修一个已知bug,然后和Agent版本做对比。判定标准看三项:实现路径是否等价、边界条件处理是否一致、你能否不看代码讲清每一处改动的原因。第三项答不上来,说明这块的理解债还没还。
提问前先写下你的预期
Addy最后给了一个极简的自测:每次向Agent提问前,先写下你预期会发生什么。等它交卷,再试着找出一件它可能没检查到的事。两个动作加起来,至少保证脑子跟着转了两圈。
这个习惯成本很低,但能拦住不少认知投降的瞬间。写预期的时候你会发现自己其实没想清楚,找漏检的时候你会被迫真正读一遍输出。
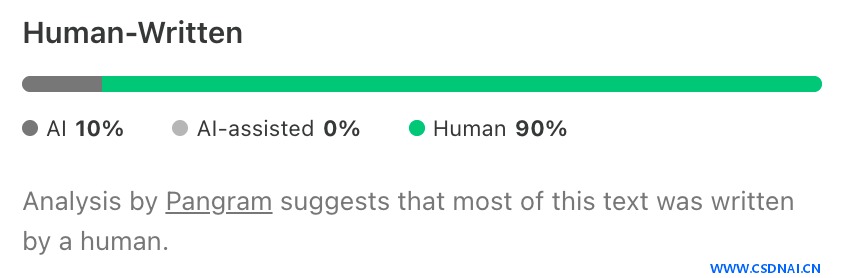
文章末尾他晒了张Pangram检测报告:人类撰写90%,AI生成10%,AI辅助0%。劝人动脑的文章,自己确实动了脑。知行合一这件事,在AI时代反而成了需要专门证明的东西。
回到那个问题:明天AI集体罢工,你能撑几天。答案不重要,重要的是你现在还知不知道自己的边界在哪。
ID:7890







