Agent不是新概念,但2024年这波热度把它从实验室推到了工程现场。想真正把智能体跑起来,光看架构图不够,得把框架、检索、微调、部署这几段链路串成一条线。下面按工程实现的顺序拆。
先想清楚Agent到底解决什么问题
传统API调用是单次请求、单次响应,逻辑写死在代码里。Agent的不同在于它自己决定下一步做什么:调哪个工具、查哪份资料、要不要再问一轮。客服分流、自动化决策、资料检索这类场景,任务边界模糊、步骤不固定,正是Agent的用武之地。
反过来,流程完全确定、每步都能穷举的业务,硬上Agent只会增加不确定性和调试成本。这一点在选型阶段就要判断清楚。
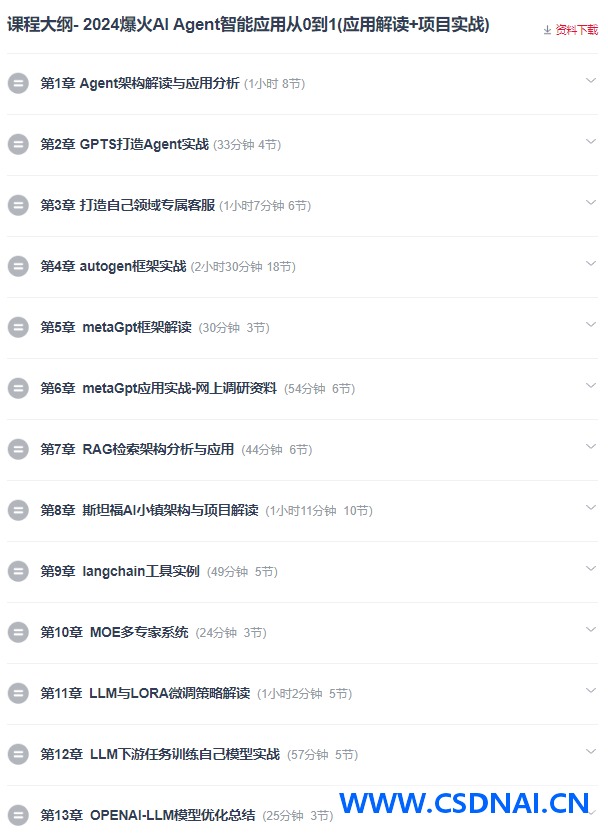
轻量智能体的起点:GPT接口定制
入门阶段不必上重框架。用GPT系列API加一层函数调用(function calling)就能拼出最小可用的智能体:定义工具描述、解析模型返回的调用意图、执行后把结果回填进对话。核心是把”模型输出”翻译成”可执行动作”。
这条路径的优点是链路短、可控性强,适合任务种类少、工具集固定的场景。缺点是编排逻辑要自己写,工具一多,状态管理和异常分支会迅速膨胀。到这一步就该考虑引入多智能体框架了。
多智能体协作:AutoGen的实战要点
AutoGen的价值在于把多个角色(规划者、执行者、审查者)的对话流转抽象成可配置的通信机制。复杂任务拆解、多轮协商、结果汇总,都能用角色对话的方式表达,比手写状态机清晰。
这里有个版本坑必须提前说。AutoGen 0.4对核心API做了重构,ConversableAgent、GroupChat 这套旧接口与新版 autogen-agentchat 的调用方式差异明显,网上大量教程仍基于0.2/0.3写法。直接照抄会在导入和初始化阶段报错。迁移时优先锁定依赖版本,或在虚拟环境里固定 pyautogen 的版本号,别让环境漂移毁掉一个能跑的demo。
多智能体还有个隐性成本:对话轮次越多,token消耗和延迟越难控。给每个角色设终止条件和最大轮数,是上线前的必做项。
源码级框架:MetaGPT的流程自动化思路
MetaGPT把软件公司的角色分工搬进框架,产品经理、架构师、工程师各司其职,按SOP产出文档和代码。读它的源码,重点不在背API,而在看它如何用结构化输出约束每个角色的产出格式——这是让多智能体协作不跑偏的关键手段。
拿它做资料检索和流程自动化时,要接受它的强约束:流程固定带来稳定性,也带来灵活性损失。业务步骤经常变动的场景,改造成本不低。
RAG:知识库问答的性能优化与验证
检索增强解决的是模型知识过期和幻觉问题。工程上分三段:文档切分与向量化、召回、重排后拼进上下文。优化点集中在切分粒度和召回策略。
只调参数不看效果等于盲调。验证方法很直接:准备一批标注好标准答案的问题集,跑检索链路,统计Top-K召回率——即标准答案所在文档块是否出现在前K个结果里。召回率不达标,先查切分是否把关键信息切断、embedding模型是否与语种匹配;召回够但回答差,问题多半在重排和提示词组织。这套校验跑通,优化才有依据。
仿真环境与多模块协同
斯坦福AI小镇那套设计值得拆的是模块解耦:记忆、反思、规划各自独立,通过消息传递协同。仿真环境里智能体行为可复现、可观测,这对调试复杂交互极有价值。把这套思路搬到生产,就是给每个模块留日志和状态快照,出问题能回放。
LoRA微调:下游任务定制的性价比之选
全量微调成本高,LoRA用低秩矩阵旁路更新,显存占用和训练时间都大幅下降,适合领域术语多、输出格式要求严的任务。流程是:准备指令数据集、配置秩和缩放系数、训练适配器、合并或独立加载。
注意LoRA擅长的是风格和格式对齐,指望它灌入大量新知识,效果不如RAG。两者组合——检索供事实、微调管表达——才是常见实现方案。
项目串起来看
领域客服系统练的是意图识别加知识检索;多专家决策系统练的是角色分工与结果聚合。六个实战案例覆盖的其实是同一条链路的不同切面:架构选型、框架编排、检索优化、模型定制、部署观测。按这条线走,知识不会碎成一地。
代码模板能省起步时间,但真正拉开差距的是对失败路径的理解——版本冲突、召回不足、轮次失控,这些才是工程现场的主战场。
ID:6542







