RAG 的本质可以用一句话概括:把外部知识塞进提示词,让模型基于可验证的资料作答,而不是靠参数里的记忆硬编。检索增强生成(Retrieval-Augmented Generation)在生成答案之前,先从结构化或非结构化知识库里动态拉取相关信息,再把这些内容作为上下文喂给生成模型。
这么做换来四件事:答案更准、信息更新、来源可查、可信度更高。大模型的幻觉问题没法根治,但引入可验证的外部知识源后,知识密集型任务的可靠性会明显上一个台阶。
一个直观的类比:RAG ≈ 搜索引擎 + 大语言模型。
三阶段管道:检索、增强、生成
RAG 系统通常按三阶段协同管道组织。
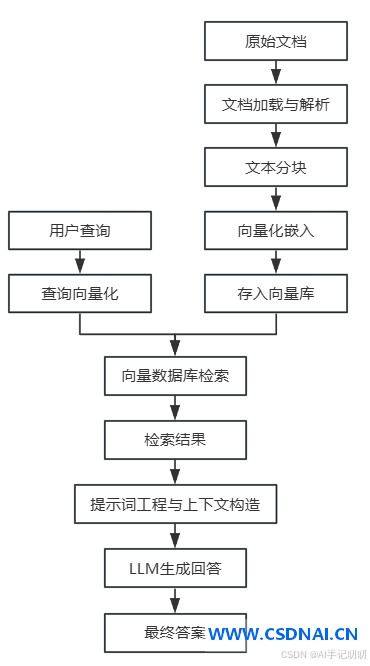
检索阶段要解决的是“从知识库里快速定位相关内容”。落地时拆成三步:文档分块(按段落、语义或固定长度切分)、文本向量化(用嵌入模型把文本转成向量)、相似度检索(基于向量找出最相关的文本块)。
增强阶段负责把检索结果和用户查询揉到一起。常见操作包括结果重排序、去重与过滤、提示工程。提示模板可以长这样:
模板里那句“如上下文未提供相关信息,请明确说明”很关键。少了它,模型在检索不到内容时照样会编。
生成阶段基于增强后的上下文产出自然、准确、有据可依的回答。对模型的要求是上下文理解能力强、文本流畅连贯、支持引用标注与溯源输出。
什么时候用 RAG,什么时候该微调
这两条路线不是互斥的,但选型逻辑完全不同。
RAG 的核心机制是外部检索加上下文提示,模型参数保持不动;微调则是调整模型内部权重,去适配特定任务分布。知识来源上,前者是可动态更新的外部知识库,后者固化在模型参数里。
知识更新成本差距最大。RAG 只需更新知识库,微调要重新训练或增量训练。
优势对比也很清楚。RAG 知识实时性强、可溯源、没有灾难性遗忘;微调输出风格可控、推理延迟低、对复杂模式建模能力强。挑战方面,RAG 依赖检索质量、受上下文长度限制、提示工程复杂;微调需要大量标注数据、计算成本高、容易过拟合。
适用场景上,动态知识问答、事实核查、多文档推理走 RAG;风格化文本生成、代码生成、领域术语适应走微调。
两者还能协同:对生成模型做轻量微调,优化它基于检索上下文的指令遵循与生成能力,搭出“RAG + 微调”的复合系统。
评估不能只看答案对不对
RAG 的评估要分四层看,混在一起测容易得出错误结论。
检索效果看查全率(Recall,是否检索到所有相关内容)和查准率(Precision,检索结果中相关内容的占比)。这两个指标直接决定后续生成的上限。
生成质量看忠实度(Faithfulness,回答是否严格基于检索内容)、相关性(Relevance,是否直接完整回答问题)、流畅性(Fluency,语言是否自然通顺)。忠实度是 RAG 特有的指标,普通文本生成评估里没有这一项。
系统性能看响应速度(端到端延迟是否满足实时性)、并发能力(高并发下的稳定性与吞吐量)、可扩展性(知识库与用户规模能否平滑扩展)。
端到端评估看答案正确率(Accuracy)、用户满意度(User Satisfaction)、溯源准确率(Citation Accuracy)。
这里有个坑:检索指标好不代表端到端效果好。检索召回的内容如果排序靠后,或者提示模板没组织好,生成质量照样拉胯。评估要分层定位瓶颈。
搭第一个 RAG 系统的四步
准备知识库。收集 PDF、Word、HTML、Markdown 等文档,做清洗与格式化,去除无关内容,统一编码与格式。推荐工具:LangChain、LlamaIndex、Unstructured。
文本向量化。用嵌入模型把文本转成向量。轻量高效选 all-MiniLM-L6-v2;中文优化选 BGE-M3、text2vec-large-chinese;商业服务选 OpenAI text-embedding-3-small、Cohere Embed。
搭建检索系统。根据数据规模与性能需求选向量数据库。轻量级用 Chroma、FAISS;生产级用 Weaviate、Pinecone、Qdrant。
集成与优化。设计高效的提示模板,选择生成模型(如 GPT-4、Claude、Llama 3、DeepSeek 等),实现引用溯源与置信度展示,做端到端测试与迭代优化。
实操中容易踩的一个坑:文档分块策略和嵌入模型必须匹配。用中文嵌入模型却按英文语义切块,检索质量会明显下降。分块大小也不是越小越好,块太小会丢失上下文,块太大则检索精度下降。
局限性与演进方向
RAG 不是万能药,四个局限绕不开。
检索质量敏感,检索结果的质量直接影响最终生成效果。上下文长度限制,受模型上下文窗口约束,难以处理超长或多源文档。复杂推理支持有限,需要多步逻辑推理的问题处理能力仍待提升。提示工程依赖,生成效果受提示设计与上下文组织方式影响较大。
演进方向有几条线在推进。端到端可微检索,如 DPR、RAG-end2end 等联合训练检索与生成模块。多模态 RAG,支持图像、表格、语音等多源信息的检索与生成。复杂推理与多跳检索,增强多步逻辑推理能力。自适应检索与生成,根据查询复杂度动态调整检索广度与生成深度。评估标准化与自动化,推动行业评估基准与工具的统一与普及。
应用场景速览
企业智能方向,内部知识库问答、技术支持、员工助手,价值在于快速接入企业文档、降低培训与运维成本。
专业服务方向,法律条文查询、医疗诊断辅助、金融分析,提供准确可追溯的专业建议与决策支持。
教育科研方向,学术问答、个性化学习推荐、研究辅助,基于最新文献生成解释与总结。
公众服务方向,政务咨询、实时新闻解读、市场情报分析,实时更新信息避免滞后。
这些场景的共同点是:知识更新频繁、答案需要可溯源、领域专业性强。三条里占两条以上,RAG 就值得上。



