视觉智能体做完一次作业,能不能把管用的流程留下来,下次直接调用?北京航空航天大学、香港中文大学和新加坡国立大学联合发布的 Omni Harness 就是冲这个问题去的。它的做法不复杂:让智能体主动出题练习、检查结果,再把验证通过的流程抽象成可复用策略。模型参数不动,可调用的方法随实践更新。
先看成绩单,再拆机制。
成绩单:创意作业95%,但别只看这一个数
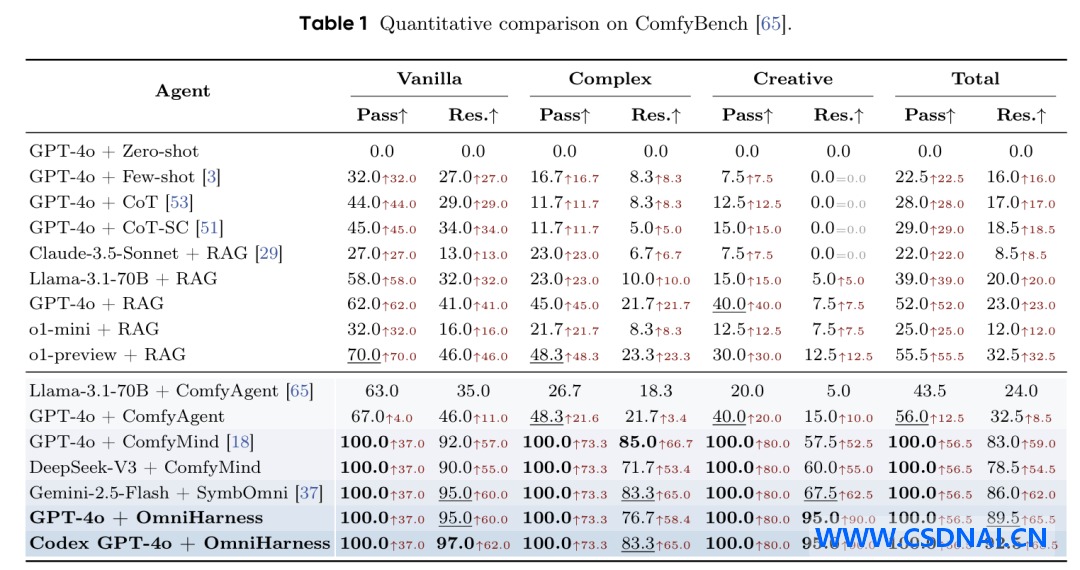
Comfy Bench 创意作业上,Omni Harness 达到 95%,比表中最佳对照 Symb Omni 高出 27.5 个百分点。换成 Codex GPT-4o 设定时,总体解决率 92.5%。
表里有两个指标要分清:Pass 看链路能否跑通,Resolve 看输出是否满足作业要求。Omni Harness 两种设定的 Pass 都是 100%,Comfy Mind 和 Symb Omni 也做到了。真正拉开差距的是可运转链路交出了多少合格成效。
推理骨干同为 GPT-4o 时,Omni Harness 总体 89.5%,Comfy Mind 83%;创意作业上两者分别是 95% 和 57.5%。这说明经验怎么被调用、工具怎么被组织,是模型能力之外的独立变量。
用 Codex 规划后,总体从 89.5% 升到 92.5%,复杂作业从 76.7% 升到 83.3%。不同规划设定对应不同的多步任务表现。
短板也在这里:复杂作业的 83.3% 仍没超过 Comfy Mind 的 85%,不是所有子集都领先。
作业长什么样:从涂鸦到餐桌编辑
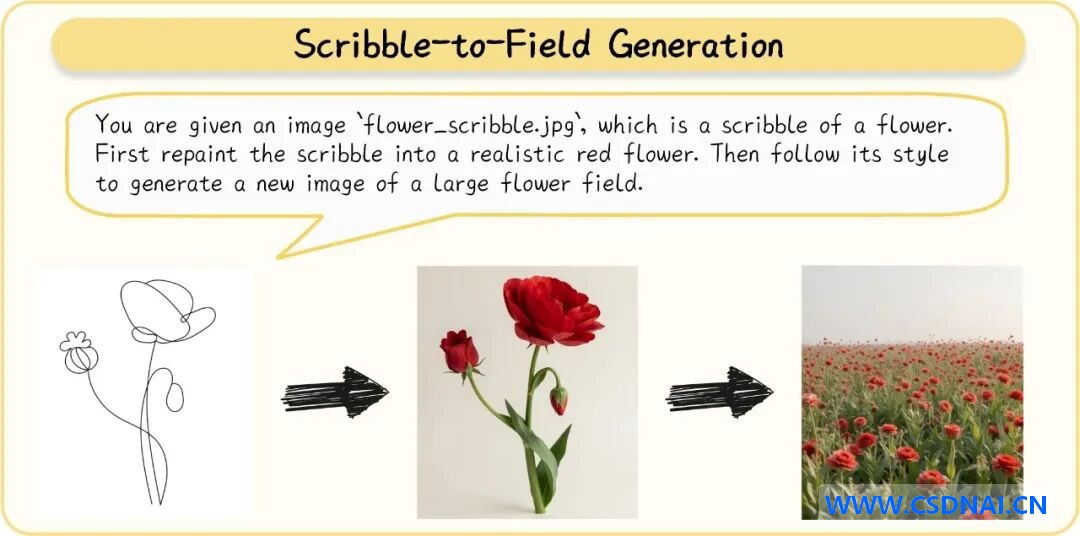
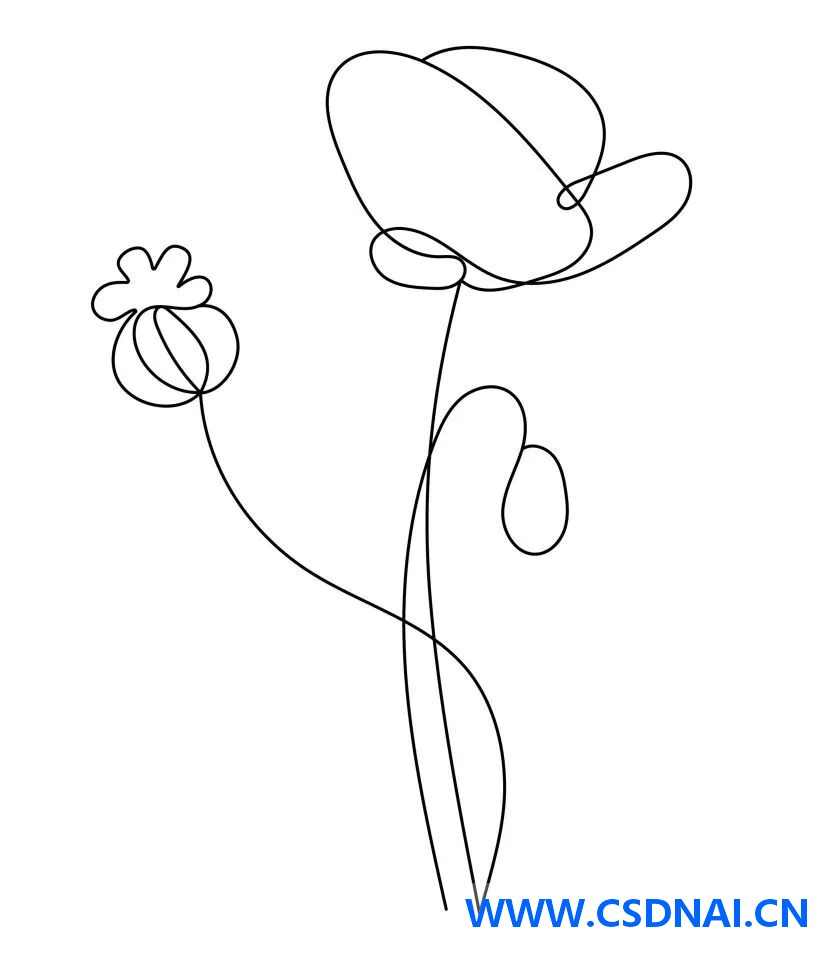
输入可以简单到一张花朵涂鸦。
涂鸦被重绘为写实红花,其风格又被用来产出一片花田。两次产出通过中间图像连了起来。
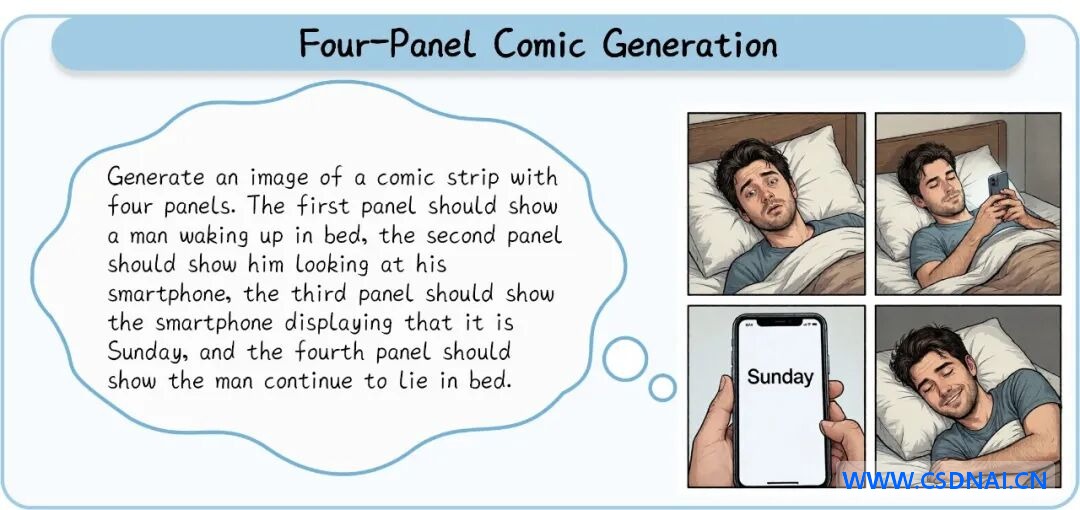
换成四格漫画,作业变成讲完整个周日早晨:醒来、看手机、发现是周日,继续躺平。动作与文字都要支撑剧情。
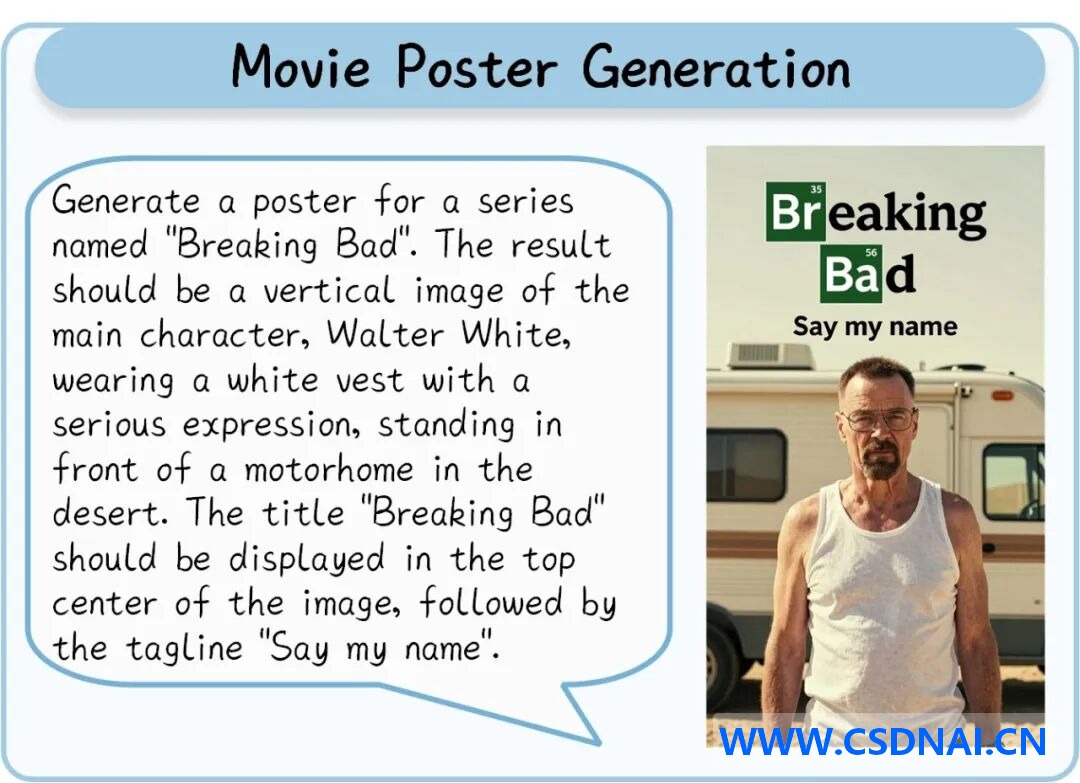
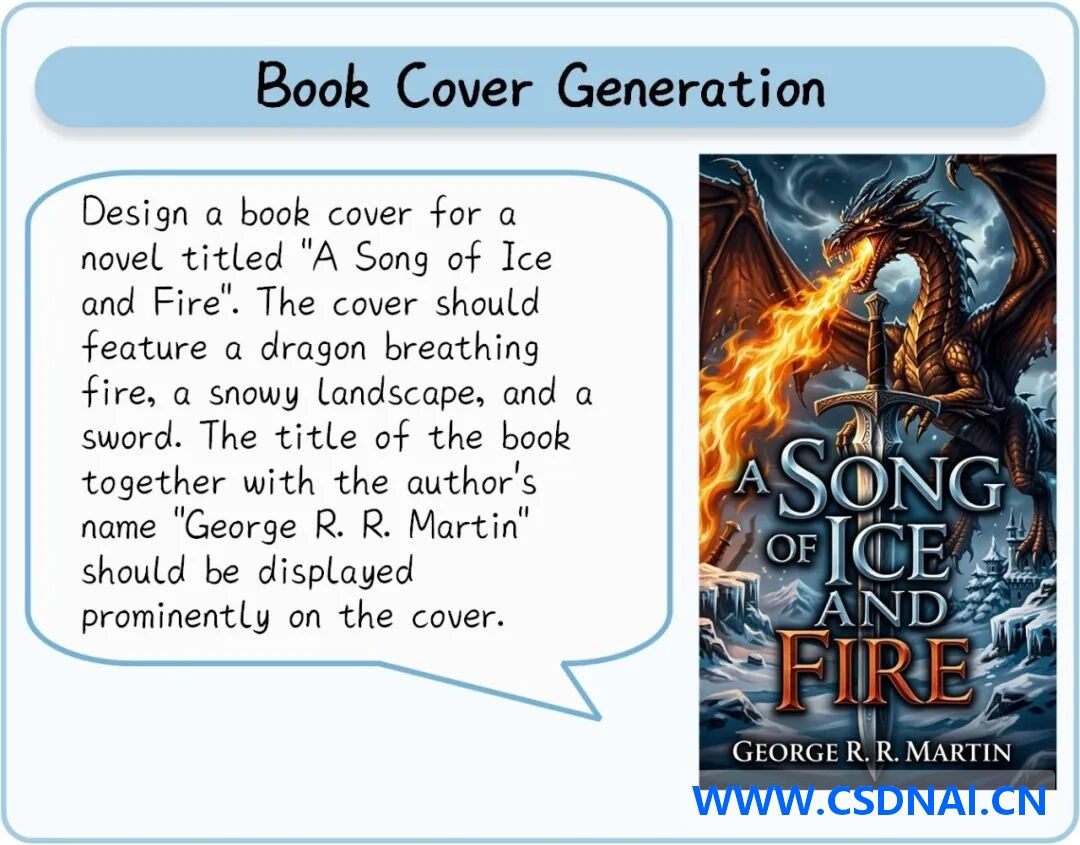
换成海报和书封,主题、标题、版式又组成一组需要同时满足的要求。
餐桌编辑更细:叉子要移除,或替换成勺子,旁边的食物、杯子与桌面布局还得尽量保留。改好目标,也要顾及周围。
经验怎么留:策略库的抽象与调用
创作需求总在变。红花可能换成别的对象,重绘之后还要调布局。一次成功怎么帮到下一次?
Omni Harness 用符号策略来钻研,把验证成功的流程整理成适用于一类作业的策略。以花田作业为例:花朵与颜色可以替换,而先重绘草图、再借参考产出新画面的连接方式,可以沉淀成可调整的方法。
保存的策略包含工作流模板、适用条件和资源依赖,当前图片、细化描述这类实例输入则被抽离出去。后续调用先检查是否适用,再绑定新输入,按需调整流程或组合多条策略。
三步循环:出题、检查、积累
第一步,把练习选在值得研究的地方。自主练习发生在下游作业明确之前。只做熟悉的题补不齐空缺,难点太远又缺少方法支撑。系统结合练习记录与现有能力,让探索有迹可循。
每轮默认生成 10 道候选题,以新颖性和能力边界评分的乘积决定练哪一道。同类情境练得越多,新颖性得分越低:记录任务所需能力对应的情境—能力练习次数,图生图以源图区分情境,文生图共享一个标记。得分按所需能力取均值,避免能力项列得多就自然占优。
每项能力由可用、未停用流程中的最高安全性支撑;可靠性用 95% Wilson 置信区间下界估计。整道题的能力估计取其中最低值——先看短板,大部分步骤熟练、一处缺少安全方法,仍会拖累全局。
随后把能力估计转成选题分数:中间区间得分最高,趋近 0 或 1 都会下降,练习因此偏向有基础但仍有难点的作业。这套评分是选题启发式,表达能力支持级别。
第二步,让检查跟上每次落实。系统安排流程和依赖,将代码编译成 ComfyUI 事务流,再检查流程能否运行、各步效果及最终目标是否达成。
以花田作业解释:假如红花已偏离要求,下一步继续沿用,偏差也可能进入新画面。失败后系统锚定问题并局部复原,尽量保留已验证部分;需要时请子智能体协助,在重试预算内再次检查。
第三步,让成败都变成下一次的依据。校验成功的流程被抽象入库,失败则记录证据、缘由与修正方法。等价流程会合并,可靠性随触发更新,经验继续影响选题和落实。策略还要接受后续检验,新的成败记录持续左右它的可靠性与调用优先级。
这里有个工程上的坑:策略库不是只增不减的日志。等价流程合并、可靠性随触发更新,意味着你必须给策略条目设计可撤销、可降权的机制,否则一条早期偶然成功的流程会长期污染选题分布。
换个采用者还管用吗:冻结策略库的迁移
团队把自主练习后的策略库冻结,再适配到其他智能体的知识 API。宿主保留原有控制链路,模型也不微调。交付内容既有成功链路模板,也有失败证据与修正方案,其他智能体通过自身的检索、规划和执行机制采用它们。
同一份经验让三个系统的总体解决率都提高了:Comfy Agent 从 32.5% 升到 57.0%,Comfy Mind 从 83.0% 升到 88.0%,Symb Omni 从 86.0% 升到 89.0%。对应创意作业增幅依次为 27.5、17.5 和 10 个百分点。创意作业的抬升都超过各自总体增幅,面对新要求,已有流程和纠错经验仍能帮到不同系统。
还有一层迁移:只练过图像任务的冻结策略库,被用来处理视频事务流。视频总体解决率 85.9%,高于表中最佳对照 5.1 个百分点;视频到视频达到 80.0%,高出 13.3 个百分点。图像策略负责内容构建、参考保持等运维,时序处理仍交给视频专用组件,二者需要适配与组合。
适用边界与验证方法
这套路线不是免费的。自主练习、多轮校验和修复都会增加计算开销,检索效率与推理预算仍有优化空间。
什么场景适合用?下游任务形态相对稳定、有明确可判定的成功标准、且允许离线跑练习的流水线,收益最直接。反过来,任务目标每次都在变、成功与否只能靠人主观打分的场景,策略库的可靠性估计会失真,不建议直接照搬。
验证策略库是否真的在起作用,可以按这个顺序查:先确认 Pass 是否为 100%,排除链路本身跑不通的干扰;再看 Resolve 在创意作业子集上的增幅是否高于总体增幅,如果总体涨、子集不涨,说明策略只覆盖了简单任务;最后冻结策略库跨系统复测,若换宿主后增幅归零,问题多半出在适配层而非策略本身。
一次作业结束,经验的采用才开始
Omni Harness 呈现了一种积累方法:模型参数不变,可调用的方法随实践更新。今天留下的经验,有机会变成明天处理新诉求的起点。
:张燕妮
来源:新智元