从1989年Tim Berners-Lee在CERN写下那份提案,到2022年HTTP/3.0正式发布,这套协议走过了三十多年。它承载的不只是网页,而是今天几乎所有联网设备的远程通信。
协议到底是什么
计算机网络里的协议(protocol),本质是让设备之间能互相通信的一套规则(rules)。它规定了参与方的行为约定和规范。
HTTP全称Hyper Text Transfer Protocol,是超文本无状态协议。它基于请求与响应模型,工作在应用层,是互联网上应用最广泛的网络协议。
先拆解两个关键词。
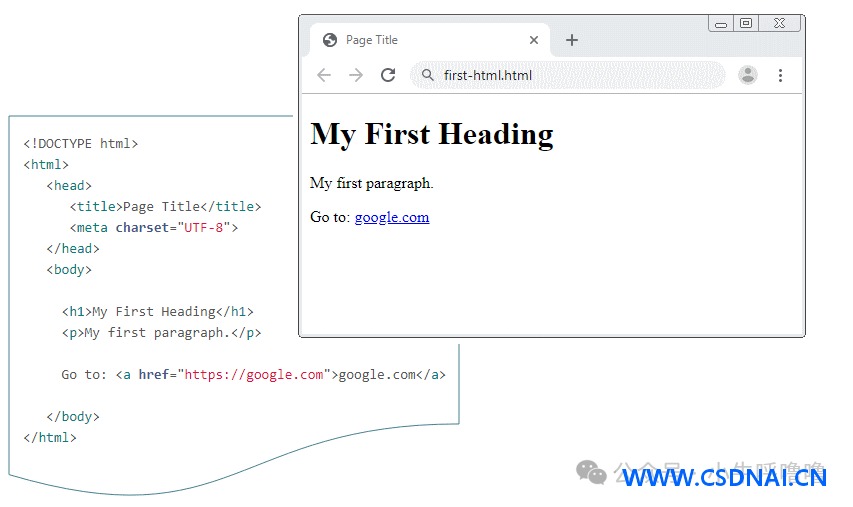
超文本(Hyper Text)不只指文字。它涵盖图片、视频等多媒体内容,特指含有指向其他资源链接(超链接Hyper Link)的文本。最常见的超文本就是网页HTML。HTML本身是纯文本,但经过浏览器内核识别处理后,能呈现文字、图片、音频、视频混合的丰富内容。
无状态(stateless)是为了快速处理海量事务、提升效率。协议对发送过的请求或响应不做持久化处理。
这两个特性贯穿了HTTP的整个演进过程。
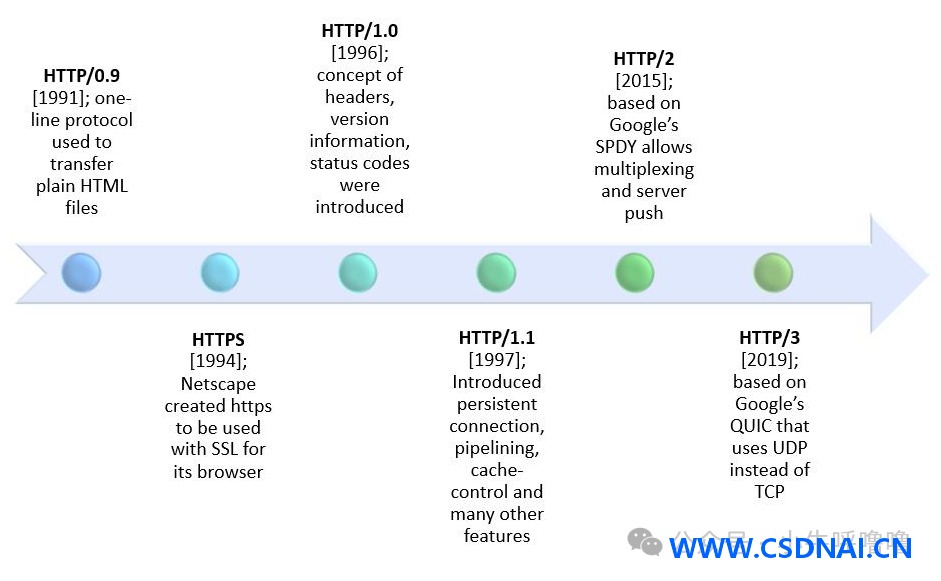
版本时间线
| 版本 | 推出年份 | 当前状态 |
|---|---|---|
| HTTP/0.9 | 1991年 | 已过时 |
| HTTP/1.0 | 1996年 | 已过时 |
| HTTP/1.1 | 1997年 | 标准 |
| HTTP/2.0 | 2015年 | 标准 |
| HTTP/3.0 | 2019年 | 标准 |
时间回到1989年。当时互联网还只是少数人的玩具。在欧洲核子研究组织(CERN)工作的Tim Berners-Lee博士写了一份提案,要搭建一个通过互联网传输超文本的全新系统,包含四个组成部分:
一个用于说明超文本的文本格式,即HTML。
一个用于交换超文本的简便协议,即HTTP。
一个展现超文本的客户端,即第一个浏览器World Wide Web。
一个支撑器用来提供可访问的说明,即httpd的前身。
早期互联网的诉求极其纯粹:把另一台电脑里的纯文本拿过来看一眼,满足大学和研究所科学家之间分享资料的需求。但Berners-Lee的野心不止于此,他想搭建一个全球化的信息交互体系,秉持开放、平等、协同、迅速、共享的信念。
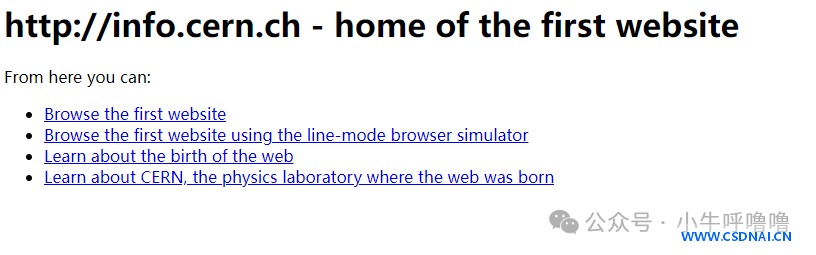
1990年工程执行期间更名为万维网(WWW),取自第一个浏览器World Wide Web的名称。info.cern.ch是世界上第一个网站和服务器地址,运行在CERN的NeXT计算机上。
HTTP/0.9:只有一行的协议
HTTP早期版本依托已有的TCP/IP协议之上搭建,没有版本号,后来被统称为HTTP/0.9。
它极其简单,不涉及数据包传输,通过请求和响应的交换达成通信。请求由单行指令组成,因此也叫单行协议。请求方式只有GET一种,后面跟目标资源的路径。它没有成为正式标准。
请求长这样:
GET /index.html
响应就是直接返回HTML内容:
Hello World
HTTP/0.9最大的局限:只能传输简单的HTML格式字符串,无法传输其他类型的文件。没有状态码,没有错误代码,一旦出问题就返回一段HTML描述信息。服务器响应完毕后立即关闭TCP连接。
几年后,IETF和W3C开始协调开发早期的HTTP征求意见稿(RFC),事务随后移交给了IETF。
HTTP/1.0:正式成为标准
HTTP/0.9只能传HTML文件,应用范围太窄。1996年HTTP/1.0发布,HTTP正式成为标准协议。
这一版新增了请求头(request header)和响应头(response header)的概念,都以Key-Value键值对形式保存。无论请求还是响应,都需要先返回头信息。
内容格式不再受限。请求头中新增Content-Type来说明提交内容的类型,协议变得灵活且可扩展。相比HTTP/0.9只能传HTML,HTTP/1.0能传输图片、音频、视频、二进制等文件。
请求方法也丰富了,增加POST、PUT、PATCH、HEAD、OPTIONS、DELETE。请求行后可以追加协议版本号,比如GET / HTTP/1.0。
HTTP/1.0还引入了缓存(Cache)机制,用于缓存已下载过的资源。客户端在设定时间内访问同一网页时,可以直接使用缓存,减轻服务器压力。
这里有个容易被忽略的点:HTTP/1.0的状态码还很不全,后面的协议版本才不断补充。常见状态码分五类:
1xx:信息,服务器收到请求,需要请求者继续执行操作。
2xx:成功,操作被成功接收并处理。
3xx:重定向,需要进一步的操作以完成请求。
4xx:客户端错误,请求含语法错误或无法完成请求。
5xx:服务器错误,服务器在处理请求过程中发生错误。
来看HTTP/1.0的请求和响应示例。
请求:
GET / HTTP/1.0
User-Agent: NCSA_Mosaic/2.0 (Windows 3.1)
Accept: */*
响应:
HTTP/1.0 200 OK
Content-Type: text/plain
Content-Length: 137582
Expires: Thu, 05 Dec 1997 16:00:00 GMT
Last-Modified: Wed, 5 August 1996 15:55:28 GMT
Server: Apache 0.84

Hello World
HTTP/1.0的无连接之痛
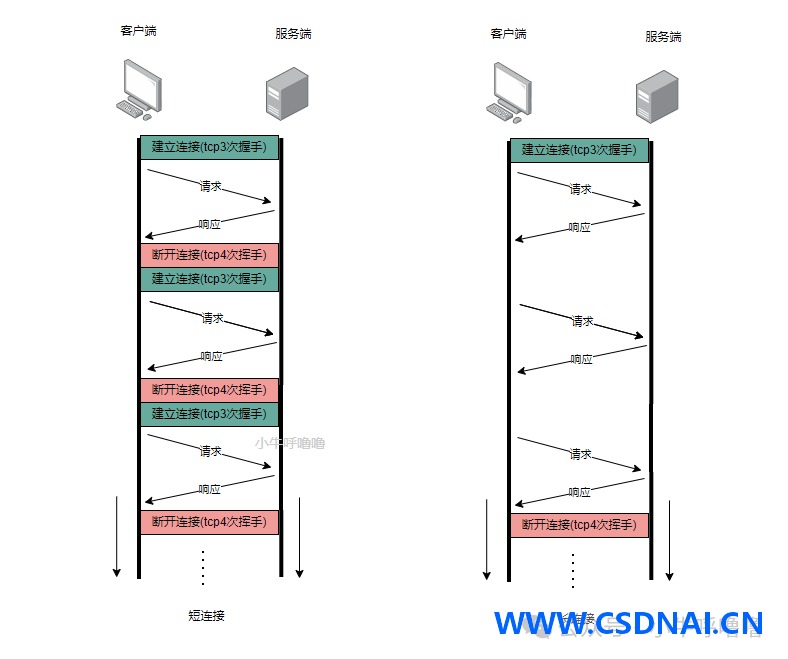
HTTP/1.0是无状态且无连接的应用层协议。为了快速处理海量事务、提升效率,它规定客户端和服务器维持短连接。
浏览器每次请求都需要建立TCP连接,服务器处理完毕后立即断开。服务器不跟踪也不记录每个客户端的历史请求。
这带来两个明显缺陷。
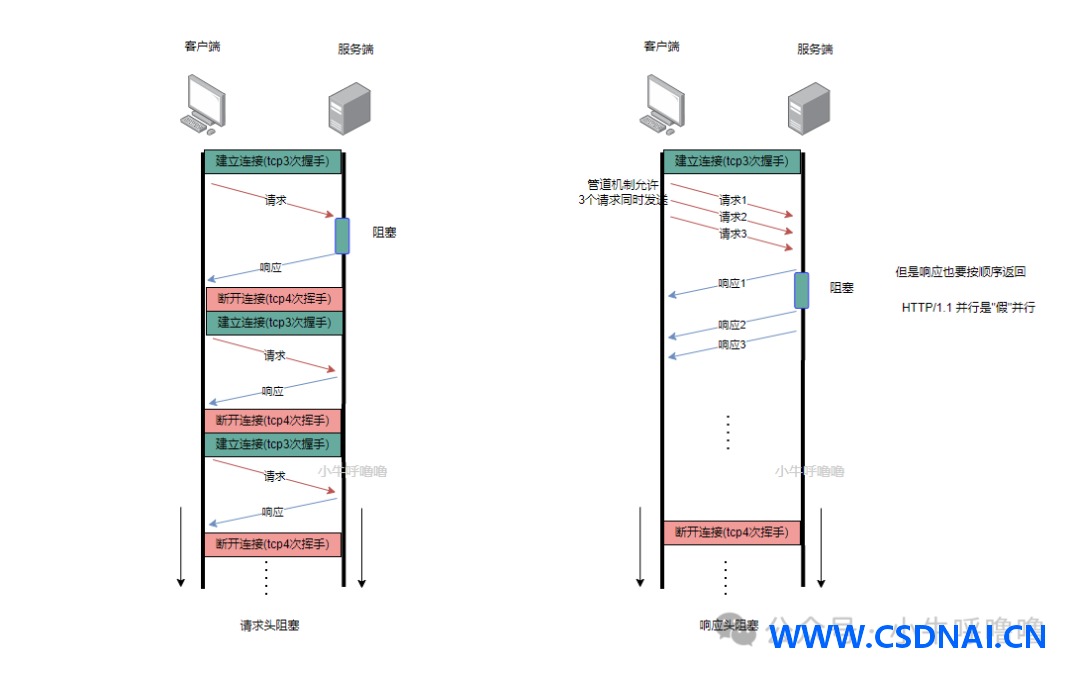
连接无法复用。每个TCP连接只能发送一个请求,数据发送完就关闭。要请求其他资源,必须重新建立连接。TCP每次建连都需要三次握手和四次挥手,频繁建连的开销很高,网络通过率低。
队头阻塞。HTTP/1.0规定下一个请求必须在前一个请求响应到达之前才能发送。假设一个请求因网络波动丢包或乱序,响应始终不到达,下一个请求就发不出去,后面的请求全被阻塞。
HTTP/1.1:缝缝补补又一年
随着浏览器普及,网页上的图片视频越来越多,一个页面甚至能含成千上万个超链接资源文件。HTTP/1.0每下载一个文件都要重新建连、传输、断开,无连接特性导致的连接无法复用和队头阻塞问题越来越严重。
1997年HTTP/1.1正式发布。
长连接
HTTP/1.1正式支持长连接。请求头上新增Connection字段,设置为Connection: keep-alive即可维持连接不断开。当然你不用手动设置,这是默认开启的。一个连接可以被多个请求复用。
如果不想开启长连接,可以在请求头中加上Connection: close。
Chrome浏览器对同一个域名默认允许建立6个TCP长连接。
管道机制
HTTP/1.1加入管道机制(pipelining),试图让多个请求可以“并行”,无需等待上一个请求返回。前提是HTTP/1.1具有长连接。
但管道仅在理想情况下能提升收发效率。响应的顺序仍然必须依据请求的顺序返回,只有这样才能确保客户端区分出每次请求的响应内容(浏览器取得HTML必须在获取CSS前面,否则没有意义)。
也就是说,某个先发的请求阻塞,后继报文即使已让处理也无法发出,队头阻塞依然存在。
Firefox、Chrome都做过管线化试验,最终都因各种原因放弃了。
所以HTTP/1.1无法解决队头阻塞,只能缓解,主要靠两种方法:
浏览器厂商允许打开多个TCP会话。RFC 2616明确约束每个客户端最多并发2个连接。但实践证明这个数字太小,众多浏览器“无视”标准,把上限提升到4~6。后来RFC 7230取消了“最多并发2个连接”的约束。
域名分片。多个域名可以同时指向同一台服务器(前提是HTTP新增了请求头Host字段)。
Host字段
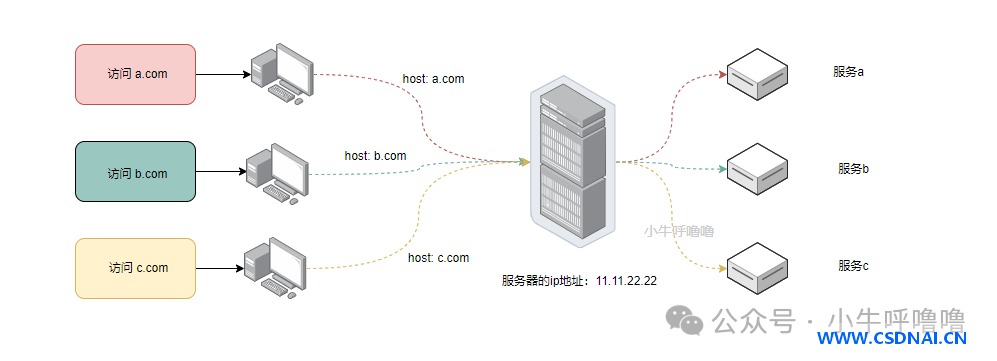
HTTP/1.0不支持Web服务器在同一个IP地址和端口号上设置多个虚拟站点,所以一个服务器只能支持一个域名。
HTTP/1.1增加请求头Host字段用于说明当前域名地址。浏览器可以用Host来明确表示要访问服务器上的哪个Web站点,服务器也可以依据不同的Host值做不同处理。
这样每个虚拟站点有自己的独立域名时,这些域名可以公用同一个IP地址。
HTTP/1.1还带来了与身份认证、状态管理和缓存等机制相关的请求头和响应头,新增了PUT、PATCH、OPTIONS、DELETE等请求方法。
来看HTTP/1.1的请求和响应示例。
请求:
GET /static/img/header-background.png HTTP/1.1
Host: developer.mozilla.org
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10.9; rv:50.0) Gecko/20100101 Firefox/50.0
Accept: */*
Accept-Language: en-US,en;q=0.5
Accept-Encoding: gzip, deflate, br
Referer: https://developer.mozilla.org/
响应:
200 OK
Age: 9578461
Cache-Control: public, max-age=315360000
Connection: keep-alive
Content-Length: 3077
Content-Type: image/png
Date: Thu, 31 Mar 2016 13:34:46 GMT
Last-Modified: Wed, 21 Oct 2015 18:27:50 GMT
Server: Apache

(image content of 3077 bytes)
断点续传与分块传输
HTTP/1.1支持文件的断点续传。文件在网络传输过程中经常会遇到网络中断,上传到中途网断了,文件又大,重新上传非常浪费时间。
HTTP/1.1的解决方案:客户端发请求时依托新增Header里的Range参数,服务器端响应时对应Content-Range。再配合新引入的分块传输(Chunk transfer),服务器把数据分割成若干个任意大小的数据块,每个数据块发送时附上上个数据块的长度。
当客户端再次发起续传请求时,URL对应的服务器资源文件可能已经出现变化。HTTP/1.1还新增Last-Modified标识文件的最后修改时间,用来判断续传时文件是否已改动。同时定义了ETag头,可以用它放置文件的唯一标识。
Range和Content-Range的格式:
Range: bytes=0-499 // 第0-499字节的内容
Range: bytes=500-999 // 第500-999字节的内容
Range: bytes=-500 // 最后500字节的内容
Range: bytes=500- // 从第500字节开始到文件结束
Range: bytes=0-0,-1 // 第一个和最后一个字节
Range: bytes=500-600,601-999 // 同时指定几个范围

Content-Range: bytes 0-499/22400 // 0-499是当前发送的数据范围,22400是文件总大小
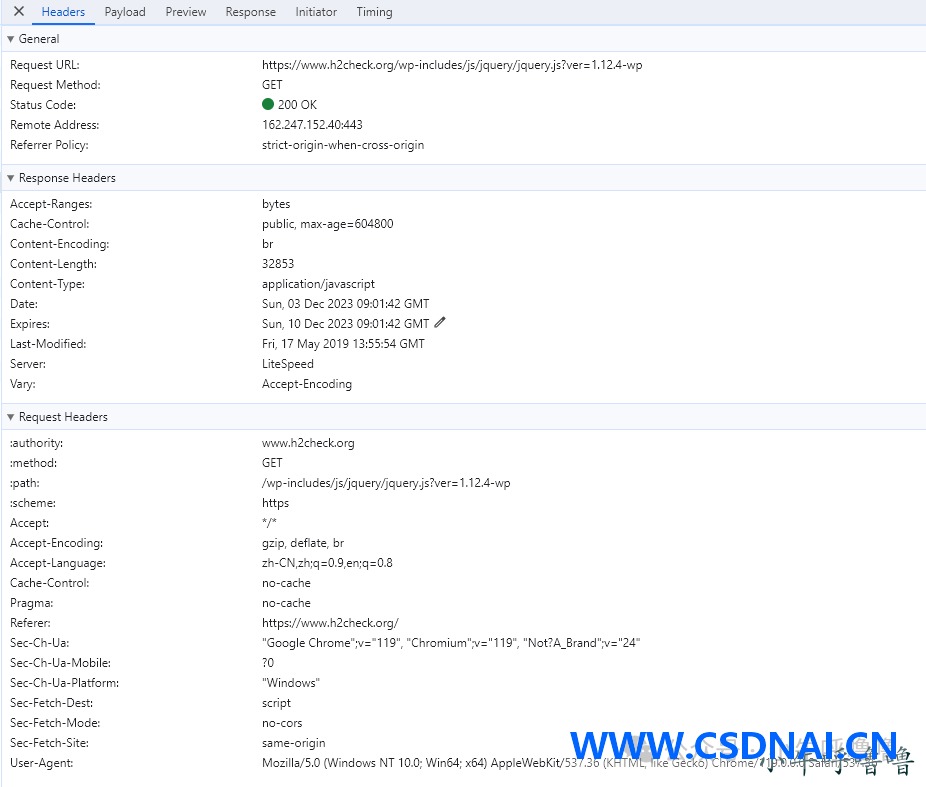
响应完成后,返回的响应头内容也不同:
HTTP/1.1 200 OK (不使用断点续传)
HTTP/1.1 206 Partial Content (使用断点续传)
这里是运维排查时容易踩的坑:如果CDN或反向代理没有透传Range头,断点续传就会静默退化成200全量返回。验证方法是curl加-H “Range: bytes=0-499″,看返回码是206还是200。
无状态的缺陷与Cookie的引入
HTTP/1.1是2015年前使用最广泛的HTTP版本,到2023年还有海量设备在使用。HTTP协议的可扩展性使得创建新头部和方法很轻松。
无状态的好处是不需要额外资源记录状态信息,压缩服务器压力,快速处理海量事务。但随着网络应用场景越来越丰富,HTTP没有记忆功能就成了问题。
用户登录购物、租房、打车、支付网站,跳转对应网站的其他页面时,需要延续维持登录状态和部分个人信息。
所以HTTP/1.1引入了Cookie技术。请求头新增Cookie字段,响应头新增Set-Cookie字段。Cookie让依托无状态的HTTP协议可以记录稳定的状态信息。
Cookie是服务器发送到用户浏览器并保存到本地的一小块数据。浏览器下次向同一服务器再发起请求时携带并一起发送到服务器上。一般用来告知服务器两个请求是否来自同一浏览器,如维持用户的登录状态。
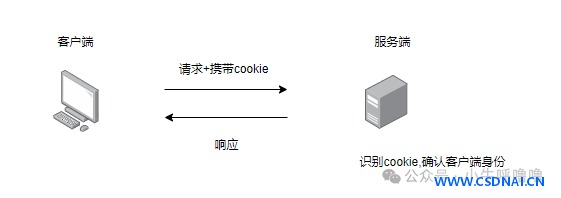
Cookie的使用场景一般有:会话状态管理(用户登录状态、购物车、游戏分数等)、个性化设置(用户自定义设置、主题等)、浏览器行为跟踪。
不过各个基座滥用Cookie来存储数据,带来了性能和安全问题。再加上当下浏览器陆续具有各种各样的存储方式,Cookie的使用也在被逐步规范。
SSL与HTTPS
HTTP/1.1是明文传输的。早期Web和网络主要用来学术资料的传输与共享,但随着Web流行于全球,使用者越来越鱼龙混杂,所有经过HTTP传输的信息都能被抓包等手段看得清清楚楚,这是最大的安全问题。
网景公司在HTTP协议依赖的TCP/IP协议栈基础上,创建了一个额外的加密传输层:SSL协议,后来发展为TLS,时间在1994年。
HTTP + SSL/TLS = HTTPS(超文本传输安全协议)。HTTPS并不是一个新协议。HTTP默认端口号是80,HTTPS默认端口号是443。
HTTPS连接建立时,需要TCP三次握手之后,还需进行SSL/TLS的握手流程。
SSL/TLS协议确保传输通道安全性主要靠三个手段:
混合加密:所有请求内容加密后再传播,防止第三方窃听。混合加密就是使用非对称密钥加密对称密钥,确保传输对称密钥的安全性;之后的通信都用对称密钥进行加解密,保证通信效率。
认证:公钥是暴露在外的,需要配备CA证书,确保公钥是服务器的公钥,而不是第三方冒充的。
完整性保证:提供报文摘要功能(通过哈希逻辑产生哈希值),报文一旦被篡改,通信双方会立刻发现。即便被篡改也很难通过哈希值反推出报文摘要。
HTTP/2.0:里程碑式突破
HTTP/2.0在2015年正式发布,相较于HTTP/1.1不仅仅是更新,更是里程碑式的突破。
二进制分帧
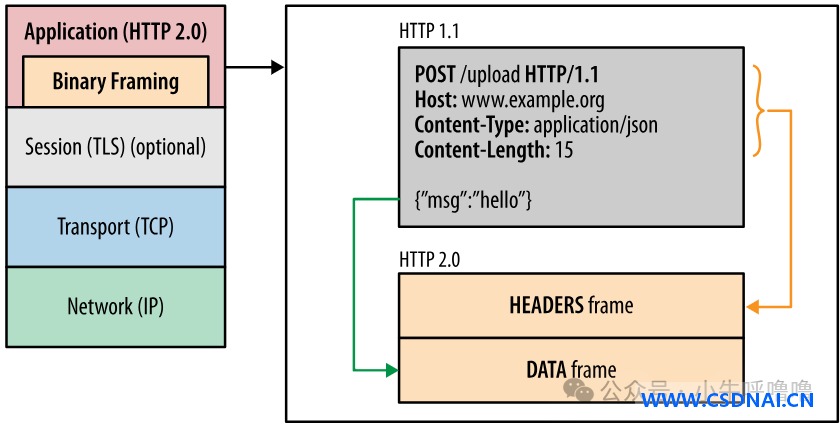
HTTP/1.x头信息是文本(ASCII编码),数据体可以是文本也可以是二进制。HTTP/2.0则彻底是二进制协议。它在应用层和传输层之间增加一个二进制分帧层,来解决HTTP/1.1的性能约束,改善传输性能,实现低延迟和高吞吐量。
为什么用二进制?
计算机天生就能看懂二进制,服务器和客户端解析数据时不需要额外进行文本到二进制的转换。二进制占用更少的空间,代表传输的数据量更少。二进制的结构更适合多路复用,轻松传输多个数据流。此外二进制比文本更适合压缩。
引入二进制分帧层,在不改动HTTP/1.x的语义、方法、状态码、URI与首部字段的情况下,重新构建了编码机制。它将所有传输信息分割为更小的帧(frame),并进行二进制编码封装。帧是基本单位。
帧分为头信息帧(Headers Frame)和数据帧(Data Frame)。HTTP/1.x中的头信息header封装到Headers帧中,数据体body封装到Data帧中。
多路复用
HTTP/1.1引入管道机制,但服务器必须按顺序逐个响应,响应端仍存在队头阻塞。
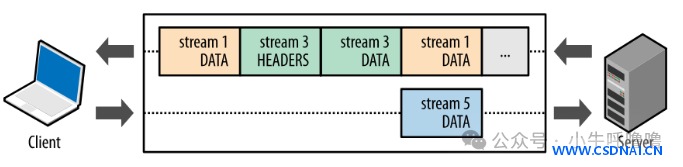
HTTP/2.0采用多路复用,代替原来的序列和阻塞机制。多路复用就是在单一的HTTP/2.0连接中,允许同时发起多重请求。每个请求及该请求的响应不需要等待其他请求。
在二进制分帧前提下,HTTP/2.0不再依赖建立多个TCP连接去实现多流并行。每个数据流都拆分成很多相互独立的帧,这些帧可以无序传输,也可以按优先级,最后在另一端根据帧首部的流标识符重新组装成完整消息。
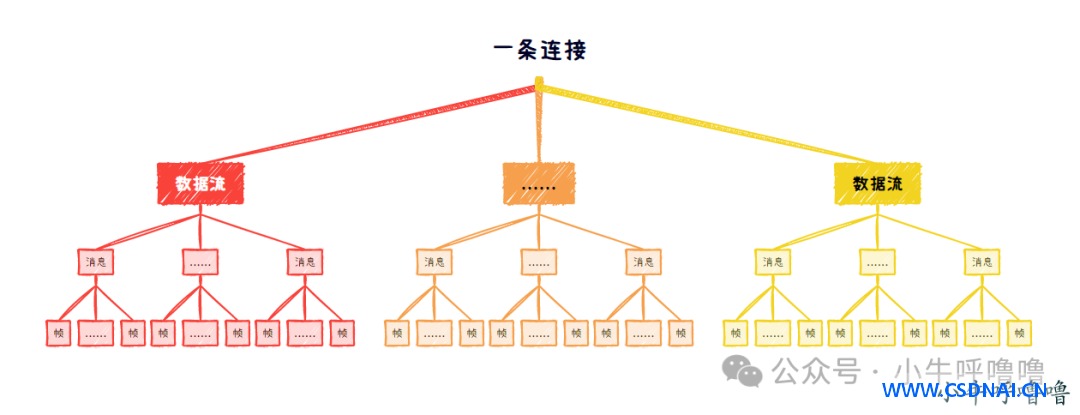
这里有几个层级概念需要理清:
连接(Connection):1个TCP连接,含有一个或多个Stream。
数据流(Stream):一个双向通讯数据流,含有一条或多条Message。
消息(Message):对应HTTP/1中的请求或响应,含有一条或多条Frame。
数据帧(Frame):最小单位,以二进制压缩格式存放HTTP/1.1中的内容,含有类型Type、长度Length、标记Flags、流标识Stream和frame payload有效载荷。
它们之间是分层级和一对多的关系。
每个请求/响应组成一个数据流,每个数据流可以拆分成许多二进制帧。这些二进制数据帧通过stream id来区分自己属于哪个数据流,这样就能把不同数据流的帧混在同一个连接里双向传输。
只需要通过单个TCP连接就可以高速传输所有请求数据,避免了队头堵塞。这才是真正实现TCP连接的并行,其实是依托数据流来实现会话的串行传输。这样可以绕过浏览器限制同一域名下的请求数目,充分利用TCP带宽。
HTTP/2.0基于帧的消息通信流程:
头部压缩
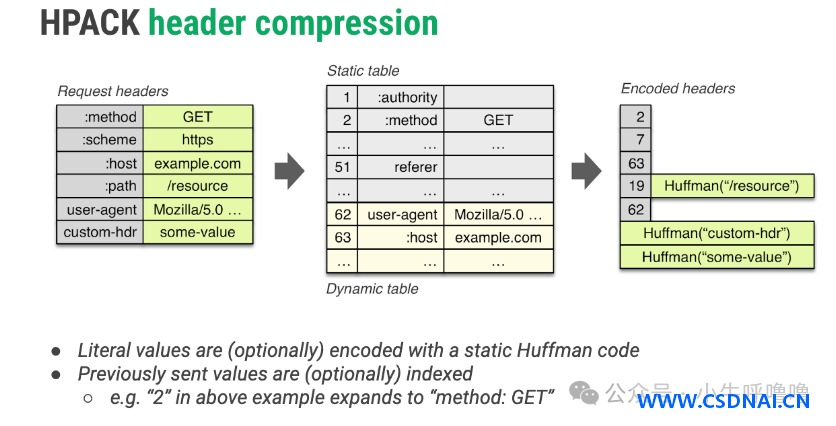
HTTP协议是无状态协议,每次请求都必须附上所有信息。头信息通常是相似的,许多字段重复,比如Cookie和User Agent。同时发出多个请求时,这些重复字段就被反复传输。
HTTP/2.0采用HPACK算法。客户端和服务器同时维护一张头信息表,所有字段存入这个静态表,生成一个索引号,以后就不发送同样字段了,只发送索引号。头信息还延续采用gzip或compress压缩后再发送。
服务端推送
HTTP/2.0允许服务器未经请求主动向客户端发送资源,也就是在客户端请求之前发送,即服务器推送(server push)。
当一个网页有许多静态资源,HTTP/1.x客户端收到网页后,解析HTML源码,再逐个请求资源。而HTTP/2.0服务器如果提前预知客户端需要哪些资源,可以提前把这些静态资源和网页一起推送。
HTTP/2.0在一定程度上转变了老牌的“请求-应答”模型,服务器不再完全被动地响应请求,也可以新建“流”主动向客户端发送消息。
与基于HTTP/1.1实现的WebSocket协议类似,服务器都能主动给客户端发消息。但不同的是,HTTP/2.0允许服务器主动推送资源到客户端缓存,并没有允许推送数据到客户端应用本身。服务器推送只是由浏览器来处理,并不会使应用代码介入,客户端也有权利选择是否接收。
如果服务器推送的资源早已被浏览器缓存过,客户端可以通过发送RST_STREAM帧来拒收。服务器不能随便将第三方资源推送给客户端,必须是经过双方确认才行,即遵守同源策略。
这里有个实践中的坑:Nginx从1.25.1版本开始默认关闭http2_push,因为服务端推送的实际命中率低,反而浪费带宽。如果要在生产环境用推送,建议先做A/B测试验证收益。
HTTP/3.0:换掉TCP
HTTP/2.0解决了HTTP这一层次的队头阻塞,但所有传输数据的压力并没有消失,反而转移到底层依赖的一个TCP连接之上。
TCP是面向连接、可靠的传输层协议。TCP建立连接时的三次握手耗时仍然较长,而且TCP依旧存在队头阻塞问题。
以谷歌为首的大型科技公司不满足于HTTP/2.0的性能。要想进一步提高HTTP性能,必须调优其依赖的底层协议。TCP很成熟,说明改造难度很大。
谷歌倾向于基于UDP来开发全新一代HTTP协议。HTTP/3.0也叫QUIC协议(Quick UDP Internet Connections)。
对比一下TCP和UDP:
TCP面向连接、安全、确保数据对路性、保证数据顺序,有队头阻塞问题。
UDP无连接、不安全、不确保数据对路性(可能丢包)、不保证数据顺序,无队头阻塞问题,开销较低。
解决队头阻塞问题
HTTP/2.0只解决HTTP这一层次的队头阻塞,TCP层依旧存在队头阻塞问题。这其实不能怪TCP,它是无辜的。
比如在传输过程中,一旦丢包,会触发TCP重传机制。这个时候一个TCP连接中的其他所有请求都必须等待,直到丢的包被重传回来。这就出现因丢包而阻塞整个连接的请求。
QUIC从根上算是重写了HTTP协议。UDP没有队头阻塞问题,使用UDP来替换TCP。
QUIC也实现了安全传输,确保数据必定可以抵达目的地,还引入了类似HTTP/2.0的数据流和多路复用。QUIC每个数据流独立互不影响,并为每个流独立实现数据包丢失检测和重传,协议可以同时运行多个数据流。
当某个数据流丢包时,只会阻塞这个数据流,其他数据流不受影响。
缩短建立连接的耗时
QUIC在传输层实现了0-RTT和1-RTT的连接建立。对于曾经连接过的客户端,可以在第一个数据包中就携带应用数据,实现0-RTT。这比TCP+TLS的握手流程少了很多往返。
实测这样更稳:在弱网环境下,HTTP/3.0的收益最明显。如果内网延迟低、丢包少,HTTP/3.0相比HTTP/2.0的优势并不显著。不建议在缺乏UDP调优经验的团队里盲目上HTTP/3.0,因为运营商和企业防火墙对UDP的QoS策略往往比TCP更严格,可能反而导致性能下降。
部署HTTP/3.0时常见的报错:客户端报ERR_QUIC_PROTOCOL_ERROR,根因通常是中间设备(防火墙、负载均衡)拦截了UDP 443端口。解决方案是确认UDP 443放行,并在Alt-Svc响应头中正确宣告h3支持。
验证方法:用curl –http3 DevTools的Network面板查看Protocol列是否显示h3。
连接迁移
QUIC还支持连接迁移。TCP连接由四元组(源IP、源端口、目的IP、目的端口)标识,当客户端从WiFi切换到4G时,IP地址变化,TCP连接就断了,需要重新建立。
QUIC使用连接ID来标识连接,不依赖IP地址。客户端网络切换时,只要连接ID不变,连接就可以继续使用,不需要重新握手。
这对移动端体验的提升很直接。用户在地铁里刷视频,进出隧道时网络切换,HTTP/3.0能保持连接不中断。
各版本关键差异速查
从运维和测试角度看,几个关键差异需要记住:
HTTP/1.0:短连接,每次请求新建TCP连接。无Host头,一个IP只能一个域名。
HTTP/1.1:默认长连接(Connection: keep-alive)。有Host头,支持虚拟主机。支持断点续传(Range/Content-Range)。支持管道化但实际被废弃。
HTTP/2.0:二进制分帧,多路复用,头部压缩(HPACK),服务端推送。单TCP连接承载所有流。
HTTP/3.0:基于UDP的QUIC协议。解决TCP层队头阻塞。支持0-RTT连接建立和连接迁移。
排查HTTP版本问题时,一个实用命令是:
curl -I -v https://example.com 2>&1 | grep -i "HTTP/"
看输出的协议版本号,再结合Alt-Svc头判断服务端是否宣告了h3支持。如果服务端返回Alt-Svc: h3=”:443″,说明支持HTTP/3.0,但客户端未必已经用上。
从HTTP/0.9到HTTP/3.0,三十多年的演进核心逻辑其实只有一条:在保证可靠传输的前提下,不断降低延迟、提升吞吐。每一代协议都在解决上一代的瓶颈,同时引入新的权衡。理解这些权衡,比记住版本号更有价值。







