为什么要把 Claude Code 塞进无人值守链路
PR 审查这件事,本质是用团队规范对代码做安全、质量与覆盖率的验收。AI 让代码产出量成倍上涨,原来那条人工审查链路立刻变成瓶颈:审查者面对数倍代码,质量下滑,漏洞和性能隐患容易漏进主干;被审查者频繁切上下文,等待时间被拉长。
解法不是让人审得更快,而是把审查从会话里搬出来,做成一条可编程的流水线。用 harness 的思路引入 Claude Code:围绕模型,把输入、授权、输出、开销提前框死,让它输出结构化审查报告,工程师只处理真正需要判断的部分。
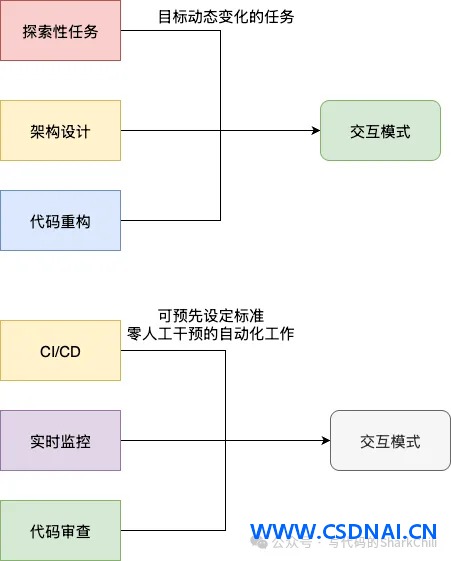
这就是 headless 模式的价值:把模糊的人力决策步骤前置,对作业输入输出、开销、授权做基准化限制,然后嵌进定时任务、CI/CD 流水线、批处理这些无人化链路。
交互模式与 headless 的六个结构差异
headless 不是简单地把问答模式改成自动执行。从架构层看,两种模式在六个维度上完全不同。
用户界面:交互模式用 TUI 终端图形界面,实时渲染;headless 无界面。
输入方式:交互模式是多轮实时对话;headless 是一次性 prompt 或 stdin 管道。
输出方式:交互模式流式渲染;headless 可以是纯文本、JSON、流式 JSON。
授权确认:交互模式弹提示让人确认;headless 无人应答,权限请求默认被拒绝。
会话持久化:交互模式自动保存,支持 resume;headless 同样保存会话,通过 –continue 或 –resume 续接指定会话。
开销控制:交互模式靠人观察和 Ctrl+C 中断;headless 必须预先用 –max-turns / –max-budget-usd 做硬约束。
这背后是三个角色整体缺席:授权核准者、质量检测者、链路控制者。体系必须在运行前把所有规范预设好——哪些工具授权触发、最多几轮对话、成本上限多少、输出用什么格式便于下游解析。
-p 只是入口,真正的差异在参数体系
让 claude 以非交互方式触发,只需要 -p 或 –print,执行完直接输出结果并退出,不等待任何用户输入。
拿一段有拆箱空指针的代码举例,isZero 实现如下:
/*
 * 判断数字是否为0
 *
 * @param num
 * @return
 */
public boolean isZero(Integer num) {
    return num == 0;
}
键入下面这条命令,Claude Code 就会在非交互模式下完成全自动审查并输出:
claude -p "分析 Head Less Example 存在哪些缺陷"
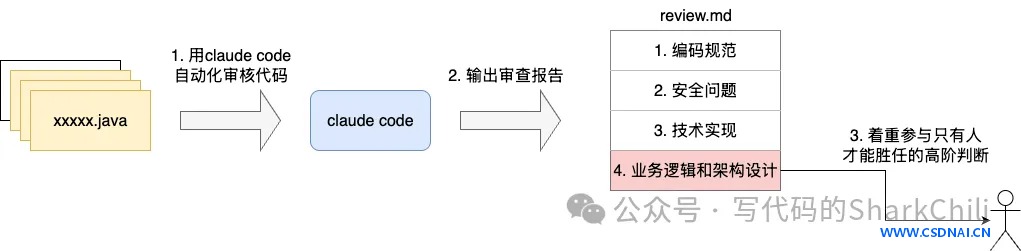
但 -p 只是入口。任何一次产出层级的无人值守触发,都要严格按四个角度做量化和设定:输出格式、成本控制、安全边界、执行控制。
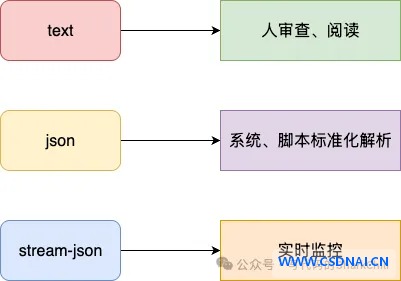
输出格式:text、JSON、stream-json 怎么选
输出格式决定下游怎么解析消息,Claude Code 大体分三种核心格式。
text 是最简单的纯文本输出,适合呈现摘要供人决策,比如上面那个代码审查示例。
JSON 格式以一个完整严格的 JSON 对象输出,不仅含作业结果,还封装了一系列元数据:
claude -p "分析 Head Less Example 存在哪些缺陷" --output-format json
输出节选如下(// 注释为笔者所加,非原样输出):
{
  //......
  "num_turns": 5, //本次执行的轮次
  "result": "核心缺陷 1 个。应改入参为 P0,或 P1 / 先判空。", //处理结果
  //......
  "total_cost_usd": 1.131573, //消耗总成本
  "usage": {
    "input_tokens": 18,
    "cache_creation_input_tokens": 169898,
    "cache_read_input_tokens": 65061, //缓存命中情况
    "output_tokens": 1246, //......
  },
  "modelUsage": {
    "qwen3.8-max": {
      //......
    }
  },
  ...
}
无人化运维和开销调优要重点盯三个字段。total_cost_usd 是本次运行总开销,注意它是客户端侧估算值,可能和真实账单有偏差,适合做预算观测而非精确计费。cache_read_input_tokens 反映缓存命中情况,频繁命中相同提示词或基础代码库时该值越高。num_turns 映射模型的交互深度,也能在一定程度上判断执行效率。
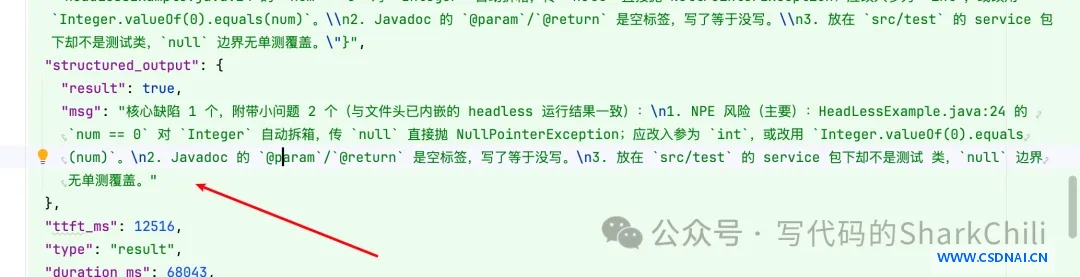
除了基准 JSON,Claude Code 还支持指定 JSON Schema 输出。比如希望审查结果按 result:bool、msg:string 的结构输出:
claude -p "分析 Head Less Example 存在哪些缺陷" \
  --output-format json \
  --json-schema '{"type":"object","properties":{"result":{"type":"boolean"},"msg":{"type":"string","required":["result","msg"]}'
若输出不符合 schema,claude 会自动重试修正,超过重试上限则整个运行以错误结束,JSON 输出中的 subtype 为 error_max_structured_output_retries。
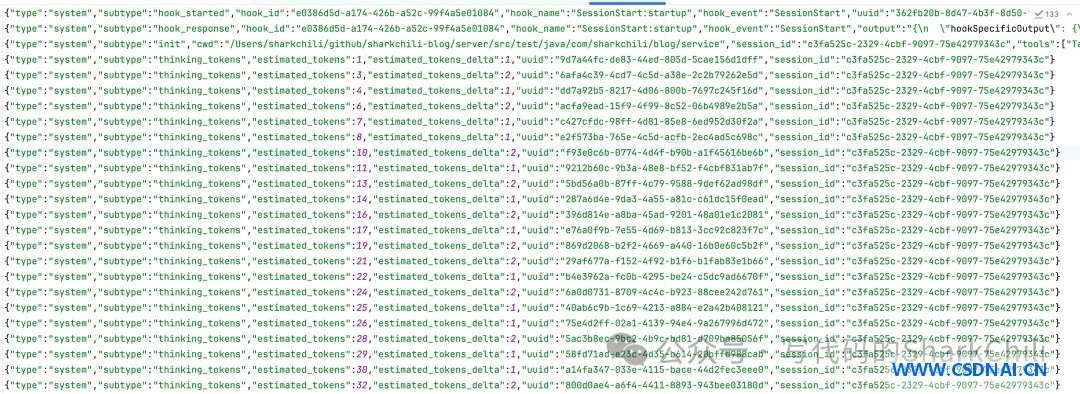
stream-json 是实时输出流,即 NDJSON 格式,按行输出多个独立 JSON 对象,每一次工具调用都实时输出到标准输出流:
claude -p "分析 Head Less Example 存在哪些缺陷" --output-format stream-json --verbose
每一轮的工具调用和思考都会实时输出到基准流,重点看第一轮响应,它会通过 tools、mcp_servers、model 等字段说明本次调用用到的工具、MCP 与模型信息。
选型建议很直接:需要人审查阅读用 text;需要基准化界定、让下游精准消费用 JSON;需要对链路实时观测的长作业用 stream-json。
成本控制:两个硬熔断参数
交互模式下可以随时 /cost 查看、Ctrl+C 中断。headless 没有这种人力熔断机制,必须靠 –max-turns 和 –max-budget-usd 在轮次和额度两个角度预设。
–max-turns 限制最大轮次,比如最多执行一轮:
claude -p "分析 Head Less Example 存在哪些缺陷" --max-turns 1
轮次超限时输出:
Error: Reached max turns (1)
这段报错文案为实测所得,随版本迭代可能变化。官方口径是抵达轮次上限即以错误结束、进程以非零退出码退出,脚本可据此通过 $? 分支处理。
–max-budget-usd 在开销上约束,比如控制在 $0.1:
claude -p "分析 Head Less Example 存在哪些缺陷" --max-budget-usd 0.1
额度触顶时执行立即停止,JSON 输出的 subtype 为 error_max_budget_usd,进程同样以非零退出码退出。
两者可以叠加,开销敏感的场景建议组合使用:
claude -p "分析 Head Less Example 存在哪些缺陷" --max-budget-usd 0.1 --max-turns 1
安全边界:白名单比黑名单更稳
交互模式下 Claude Code 会在会话中询问工具授权。headless 下无人应答,这类授权请求会被直接拒绝,所以权限必须预先设置。
allowedTools 是封闭世界假设,白名单内的工具免提示直接执行,白名单外的工具在无人值守下触发权限请求时会被直接拒绝,效果上近似把 claude 封闭在预设权限范围内工作。该参数本义是免提示清单,要显式收紧可用工具集合需用 –tools 参数。比如代码审查只需要文件阅读权限:
claude -p "分析 Head Less Example 存在哪些缺陷" --allowedTools "Read"
该参数支持授权规范式匹配语法:Bash(git log:*) 说明免提示执行所有以 git log 开头的命令(前缀匹配)。官方特别提醒冒号前的空格不能省——Bash(git log) 会连 git log-index 这类命令一并匹配。
disallowedTools 是开放世界假设,黑名单式设计,除明确禁止的工具外其余所有工具均可使用,命中的工具调用会被直接拒绝。例如禁止使用 Read 工具做代码审查:
claude -p "分析 Head Less Example 存在哪些缺陷" --disallowedTools "Read"
从安全视角看,白名单方式能非常明确地限定 claude 可操作的工具边界——白名单外的授权请求在无人值守下默认被拒。生产环境更推荐用 allowedTools 设定可操作边界,避免黑名单操作带来的误操作隐患。
另有一个激进的 –dangerously-skip-permissions 参数会跳过所有授权检查,除非作业运行在严格隔离的镜像中,否则不要在 CI 等无人值守环境使用。
执行控制:模型选择与系统提示词
模型选择上,不同模型在思考深度、开销和响应速度上各有差别。出于近期 claude 原厂对国内用户的封控,笔者主要采用 qwen3.8-max 或 glm5.3、deepseek-flash 等国产模型作为主力模型。做一些简单的基准化代码审查时,推荐用 deepseek-flash:
claude -p "分析 Head Less Example 存在哪些缺陷" --model deepseek-flash

现有模型经常超载或不可用,为保证自动化可靠性,推荐通过 –fallback-model 指定降级模型:
claude -p "代码审查: 分析 Head Less Example 存在哪些缺陷" --model deepseek-flash --fallback-model qwen3.8-max
系统提示词方面,–system-prompt 会全量覆盖 Claude Code 内置提示词(覆盖后 claude 不再掌握内置工具的正确用法),以完全自定义的规范指导 claude 工作。–append-system-prompt 不覆盖内置提示词,以追加形式补充角色定义和规范。
从软件复用角度看,内置提示词经过大量生产打磨和调优,包含很多优秀设计。做系统提示词设计时更推荐用 –append-system-prompt 追加规范,在既有优秀设计观念下补充个人诉求:
claude -p "分析 Head Less Example 存在哪些缺陷" --append-system-prompt "你是通读《Effective Java》的专家,只会以这书中条目标准来审查代码"
管道流组合:把 claude 当成 Unix 工具
与 Unix 管道无缝衔接是 Claude Code 一个优雅的设计。Unix 的构建理念是工具单一职责,用管道符把数据流依次传递。
把文件内容当作上下文输入:
cat HeadLessExample.java | claude -p "分析这段代码存在的缺陷"
面向线上环境做定时观测分析:
curl -s http://127.0.0.1:9345/actuator/metrics/jvm.memory.used | claude -p "分析当前堆内存使用情况"
这里有个坑:metrics 端点默认不在 Web 暴露清单里,需要在 Spring Boot 配置 management.endpoints.web.exposure.include 显式放开(本文示例服务已包含 health,metrics)。指向自己的服务前先确认端点可访问。另外管道输入上限为 10MB,超限 claude 会直接报错退出。
headless 同样可以把产出结果做基准化输出:
claude -p "分析 Head Less Example 存在哪些缺陷" > review.md
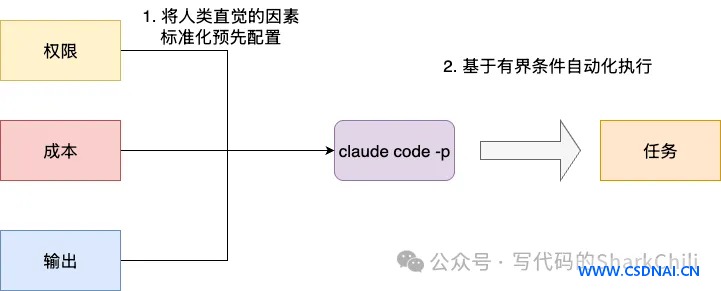
Unix 命令擅长基准化精确运算,不擅长复杂文本语义分析。把 Claude Code 这个内置强大 LLM 的 agent 整合进 Unix 上下文,是为了让它处理标准化链路中动态变化的那一块。
落地:定时采集 JVM 指标 + 结构化告警
传统自动化运维观测是用预设度量阈值让程序做无人化查询比对,超限就预警。它解决了观测这一环,但止血这一环一直比较弱。
目标是把 Claude Code 以脚本方式整合进定时任务,提高异常预警的止血效率。处理逻辑:系统定时任务触发 Spring actuator API 作为基准输入;执行 claude -p 对指标、代码上下文做动态分析;根据分析决策,若存在异常则企微预警并简要解释情况和止血策略;开发接入后据此快速止血。
策略和结构由开发者先行确认,繁琐的实现交给 AI 执行。
#!/usr/bin/env bash
demo:定时采集 JVM 堆指标 → claude -p 按 jsonschema 结构化分析 → health=false 时企微 + 邮件告警
Linux 上线配置(crontab -e 添加,stdout 重定向即日志):

*/5 * * * * cd /home/sharkchili/blog/scripts && ./jvm-health-alert-demo.sh >> /var/log/jvm-alert.log 2>&1

依赖:curl、jq、claude CLI(已登录)。demo 只打印预警等价命令,不真发。
set -euo pipefail
BASE_URL="${BASE_URL:-http://127.0.0.1:9345}"
THRESHOLD="${THRESHOLD:-80}"
SCHEMA='{"type":"object","properties":{"health":{"type":"boolean"},"msg":{"type":"string","description":"health=false时的问题摘要"},"advice":{"type":"string","description":"按流程的止血处置文字","required":["health","msg","advice"]}'

# 1) 采集:堆已用/上限(actuator 返回科学计数法字节数,用 awk 算百分比)
used=$(curl -sf "$BASE_URL/actuator/metrics/jvm.memory.used?tag=area:heap" | jq -r '.measurements[0].value')
max=$(curl -sf "$BASE_URL/actuator/metrics/jvm.memory.max?tag=area:heap" | jq -r '.measurements[0].value')
# 已知约束: curl -sf 失败(服务不可达/5xx)时脚本因 set -e 直接退出,
# 最该预警的场景反而静默, 生产使用需用 trap ERR 兜底
pct=$(awk -v u="$used" -v m="$max" 'BEGIN{printf "%.1f", u/m*100}')

# 2) 分析:指标+判定规范交给 claude,jsonschema 固化输出结构
out=$(claude -p "Spring Boot 服务 JVM 堆内存:已用 ${used} 字节,上限 ${max} 字节,使用率 ${pct}%。判定规范:使用率>=阈值则 health=false,否则 true。health=false 时 msg 给一两句问题摘要、advice 给编号流程的快速止血建议;true 时 msg 简述当前状态、advice 写无需处理。" \
  --output-format json \
  --json-schema "$SCHEMA")
health=$(jq -r .structured_output.health <<<"$out"); msg=$(jq -r .structured_output.msg <<<"$out"); advice=$(jq -r .structured_output.advice <<<"$out")
echo "[$(date '+%F %T')] health=${health} | msg=${msg} | advice=${advice}"

# 3) 告警:health=false → 企微推摘要 + 邮件给 sharkchili(demo 打印等价命令)
if [ "$health" = "false" ]; then
  content=$'【JVM堆内存预警】\n> '"${msg}"$'\n> \n> 处置流程\n> '"${advice}"$'\n> 时间: '"$(date '+%F %T')"
  payload=$(jq -n --arg c "$content" '{msgtype:"markdown",markdown:{content:$c')
  echo "[企微] curl -s -H 'Content-Type: application/json' -d '${payload}' 'https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=xxx'"
  echo "[邮件] echo '${msg}' | mail -s '【JVM预警】堆使用率${pct}%' sharkchili"
fi
脚本里那个 set -e 的坑值得单独说:curl -sf 失败时脚本直接退出,最该预警的服务不可达场景反而静默。生产使用要用 trap ERR 兜底。
小结:四个角度把 claude 变成可编程组件
从工程结构看,通过 -p 入口和四个角度的参数界定,Claude Code 从交互式助手变成各类自动化工程的基准可编程组件。
-p 指令是入口,将 claude 从交互模式转为 headless 自动化运行。–output-format 约束输出格式,确保下游能标准解析。–max-budget-usd 与 –max-turns 设定成本上限,避免无人值守环境下资源失控。–allowedTools 预置免提示放行的工具白名单,白名单外的权限请求在无人值守下默认被拒绝。–model 与 –append-system-prompt 预设模型与行为规范,预先约束执行路径。
headless 的实质就是把模糊的人力决策步骤前置,对作业输入输出、开销、授权做基准化限制。理解这套结构的构建和界定,再按自身需要从四个角度把 headless 植入日常开发的无人化项目,就能把产研效能抬上去。







