你上周跟 Codex 说过“这个库用 pnpm”,这周它又踩了一遍。打开记忆开关,以为问题解决了。但 Codex 的记忆不是一本笔记本——它是一条两阶段流水线:一个模型从旧会话里抽取值得留下的东西,另一个模型把它们归并成一份手册,中间夹着租约、排行榜、淘汰窗口和 git 基线。
更反直觉的是分工:模型担责语义,代码负责生命周期。记什么由模型判断,何时忘、能不能忘,是 Rust 和 SQLite 敲定的。下面按四层结构拆开:指令、历史、工作上下文、长期记忆,然后走一遍记忆从诞生到被遗忘的完整路线。
四层结构混在一起,就会把锅甩给模型
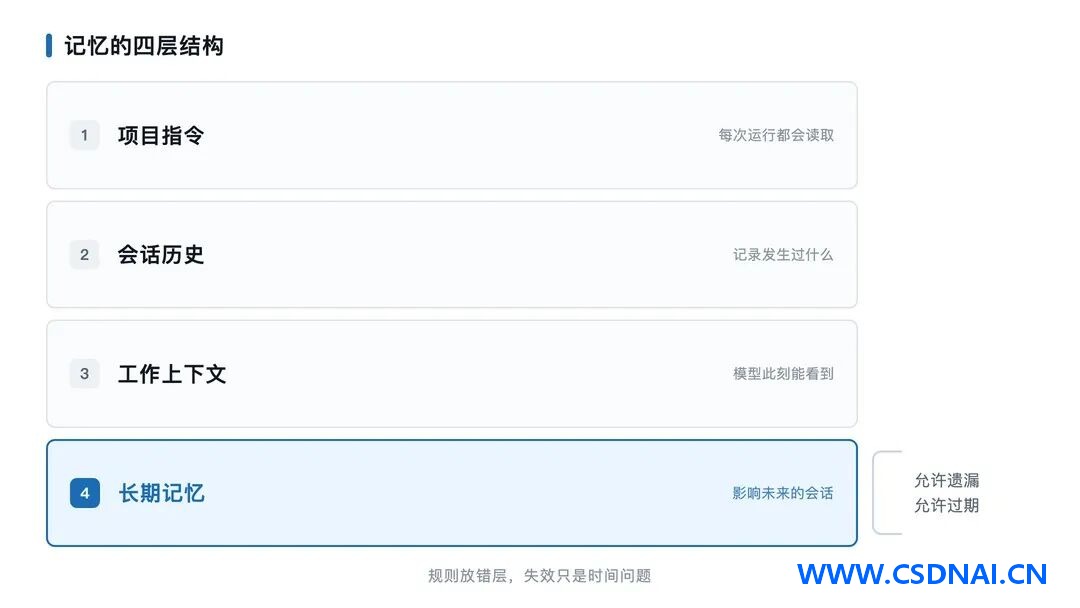
把“上下文”当成一个东西,是大多数误判的起点。它其实是四层:
指令决定行为该被什么约束,AGENTS.md 属于这层。历史记录出现过什么,也就是会话记录。工作上下文是模型此刻能看到的内容,受上下文窗口约束。长期记忆是被筛选出来、要影响未来会话的心得。
Codex 四层齐全。对照一下就能看出差别:Open Code 核心实现了前三层,长期记忆这一层没有后台策略——它的指令靠显式编辑,历史靠会话持久化。
| 体系 | 谁决定记忆运维 | 遗忘机制 |
|---|---|---|
| Codex | 运行时管线里的后台抽取与归并模型 | 模型改写 + 确定性的保留与重置 |
| Open Code 核心 | 用户或当前 agent 改指令文件 | 无通用跨会话遗忘策略 |
| Claude Code 自助记忆 | 会话中的模型自己写 | 模型自己编辑或删除 |
| Mem0 / LangMem | 抽取管线对比新旧消息 | LLM 挑选新增、更新、删除 |
| Graphiti / Zep | 摄取管线抽实体与时效关联 | 被覆盖的事实失效但保留历史 |
放错层的代价很具体。把“禁止改数据库结构”写进偏好,它可能在某次会话里没被注入;把“用 pnpm”交给记忆,它会在 30 天没被引用之后失去合并资格。规则类信息一旦进了会被淘汰的层,失效只是时间问题。
一条记忆的完整生命周期
先立个定义。Codex 管一次会话的完整记录叫 rollout:用户消息、模型回复、工具调用与输出、轮次边界、会话元数据,整体当作单个文件落在会话目录里。它是记忆管线的原料。
触发比“会话启动”更精确。管线只在根会话启动时跑,且必须同时满足:会话不是临时的、记忆功能已开启、不是子 agent 会话、状态数据库可用。实际派发的时机更靠后——要等一个带用户输入的新轮次成功启动、且主环境设定做完之后。任何一条不满足,后台 worker 直接返回,什么都不做。
第一阶段做逐会话抽取。它从状态数据库里按启动认领规则挑出候选:来源必须是允许的交互式会话、在设定的年龄窗口内、空闲够久、没有被另一个在跑的 worker 认领、且落在本次启动的扫描上限内。然后将这些 rollout 的内容先过滤成“与记忆相关的模型输入”,再并行发给抽取模型,并发有固定上限。
每个抽取作业产出一份结构化结果:详细的 P0、精简的 P1,以及可选的 P2。产出的字段会做密钥脱敏,然后写回数据库。整个并发控制靠数据库里的租约:每个作业处理前先认领,避免多个启动进程重复干活;失败的标记退避重试,而不是原地热循环。结果只有三种:成功产出记忆、成功但没产出(管线运转但没东西值得留)、失败。
第二阶段做全局归并,而且是串行的。它先取一个全局租约锁才敢碰记忆目录,锁带所有权令牌和心跳,worker 崩了也能靠租约过期释放。然后:它按 P0 优先、接着按最近 P1、再次按来源新鲜度排序,选出有界的一批第一阶段输出;没有采用记录的,回退用产出时间,这样新记忆也能被选中。超出 P0 窗口的条目直接失去资格。
接着同步产物到磁盘。P0 按线程 ID 稳定升序排列,避免排名抖动导致无价值的 diff;每个被选中的 rollout 各写一份 P0 文件。并且剪掉不再被选中的旧摘要,与过期的扩容资源文件。记忆目录本身被初始化成一个 git 基线库,用于算出“上一次成功归并到当前工作区”的差异,落成 P0。
如果没有变化,第二阶段到此结束,不调模型。有变化才拉起一个内部归并 agent,将工作区差异文件指给它。这个 agent 的限制很硬:审批策略设为 P0、禁用协同(防止递归委派)、禁用运用与组件与 MCP、禁用记忆递归、只允许写记忆根目录,在 Codex 托管授权档下还没有网。跑完之后重置 git 基线,并在重置前删掉差异文件,免得被删内容留在产物或不可达的 git 对象里。磁盘上最终长这样:
~/.codex/memories/ ├── MEMORY.md # 面向检索的手册 ├── memory_summary.md # 注入未来会话的紧凑索引 ├── raw_memories.md # 合并后的原始抽取(升序稳定) ├── rollout_summaries/ # 每个被选中的 rollout 一份 ├── skills/ # 学到的可复用流程 └── extensions/ # 扩展贡献的记忆与临时笔记
1.
记忆的两阶段流水线:认领与空闲门槛、并行抽取、串行归并、无变化直接退出、遗忘分支。
谁决定记什么:模型管语义,代码管生命周期
第一阶段提示词里最值得看的是认知纪律。它明确要求:用户消息是偏好最强的来源,工具输出和校验证据是库事实最强的来源。助手的提议不得悄悄变成长久事实,密钥要脱敏,临时度量要跳过。如果将来 agent 不会因为这条记忆而行动得更好,那就宁可不写。它甚至专门写了反过度泛化的例子:
如果用户说“这次改之前先给我看计划”,你可以写“对方期望在编辑前先呈现计划”,但不能写成“用户偏好 agent 在编辑前先展示计划”。
一句话的差别,决定了这条记忆会不会在未来污染所有作业。
第二阶段的提示词则承担改写职责:增量归并新证据、更新互相矛盾的指引、校验不清时保留不确定性、现有材料仍对路时尽量少动。agent 只移除失去支撑的说法,仍有其他证据的事实要保留。它还界定了遗忘——被删的 rollout 摘要和扩容资源构成待清理队列。
检索方法也很克制:不是向量 RAG,是渐进披露。被注入的只有一份有界的 P0;模型需要时再去搜索 P0,必要时打开一到两份摘要或技能文件。注入的提示词里写得很直白:只有当某份摘要的额外证据、措辞、时间顺序或不确定性可能改变答案时才去读,否则不要为了“看看”而检索。
最后是使用回流。模型如果在回答里引用了某份摘要,要在回复末尾附一个引用块,带上文件路径、行号和 rollout UUID。运行时解析这些引用,给对应的第一阶段记录累加采用次数和时间戳——而第二阶段的排序又优先使用次数高的。被用过的记忆活得更久,这是整套机制里唯一一条自我强化的回路。
遗忘不是一次删除,是七条独立路线
把“忘掉”理解成删一条记录,会看不懂它的行为。实际上有七条:
其一,改写成空即删除。如果这次抽取判定“没有值得留的”,之前那条抽取会被删掉,同一个 rollout 重新产出后。“没产出”不只是不创建,它可以是删除信号。
其二,掉出挑选集。排名掉出 top-N 的 rollout 摘要会被剪掉。
其三,归并时移除。agent 只移除失去证据支撑的指引,其余保留。
其四,按时间剪枝。超出 P0 的数据库行失去资格并被清理。
其五,扩容资源过期。扩容产出的资源文件超过保留窗口后被剪掉。
其六,跟随线程删除。会话被删,挂在它上面的记忆一并忘记。
其七,全局重置。库里有 P0 子命令的验证(P1),行为是重置状态并删除记忆目录。
编排参数就是这七条路线的边界:
| 旋钮 | 作用 | 官方说明写的默认 | 库 HEAD 源码常量 |
|---|---|---|---|
| min_rollout_idle_hours | 空闲多久才算候选 | 6 | 6(源码注释建议 > 12) |
| max_rollout_age_days | 多旧不算 | 30 | 10 |
| max_rollouts_per_startup | 每次启动认领上限 | 16 | 2 |
| max_raw_memories_for_consolidation | 参与归并的原始上限 | 256(上限 4096) | 256 |
| max_unused_days | 多久没用就失去资格 | 30 | 30 |
| min_rate_limit_remaining_percent | 额度低于多少就跳过 | 25 | 25 |
中间两行不是笔误。我在 2026-09-15 核对时,官方配置参考写的是 30 和 16,而仓库里 codex-rs/config/src/types.rs 的常量写的是 10 和 2。随 CLI 发布的 config.schema.json 只给取值范围、不给默认值,所以默认值的事实来源是 Rust 常量。
结论很实用:把默认值当成版本化行为。你关心的值就显式写进配置,升级后回来对一遍。
代价与边界:这套机制换来了什么,又让渡了什么
它换来的是跨会话的连续性和一套可推理的遗忘策略:你不再需要每次开局解释上一个会话,pipeline 会自己挑出值得留下的经验。它让渡的是信任面。旧对话内容由后台模型转换成未来的 developer 上下文,这条链路上有四个必须知道的边界。
第一,注入前会先做清洗。抽取之前,sanitizer 会丢掉 developer 消息、被标记的 AGENTS.md 与 skill 注入、以及压缩记录。这也解释了为什么它不会被过去的注入指令轻易带偏。
第二,外部上下文默认可以进记忆。disable_on_external_context 默认是 false,也就是用过 MCP 工具调用、网页搜索、工具搜索的会话默认仍可成为记忆生成的输入。对客户数据、内部资料,这是要在开启之前拍板的开关,不是事后补的。
第三,注入的提示词自己给记忆定了位。它写着:记忆是历史上下文,不是当前行为的证据;对重要或可能变化的说法要判断漂移、验证成本与危害,必要时去读真正的来源;引用记忆不在 pull request 里做;只在用户明确要求时才更新记忆。
第四,用户纠正走的是追加式旁路。当你明确说“记住 / 忘掉 / 更正”时,Codex 不直接改生成好的记忆文件,而是在 extensions/ad_hoc/notes/ 下追加一条小 note,由下一次合并来解释并落实。源码里这条路径的写入用的是 create_new(true),文件已存在会直接报错——它是追加日志,不是覆盖。
再加上那句官方提醒:必须始终生效的规则要放在 AGENTS.md 或签入仓库的文档里,记忆只是一个有帮助的回忆层。这不是套话,是架构事实:记忆这一层允许遗漏、允许过期、允许被模型重新判断。
今天就能做的配置与检查
本地记忆默认关闭。要开就在 P0 里:
[features] memories = true [memories] generate_memories = true use_memories = true dedicated_tools = true # 暴露原生的列表 / 搜索 / 读取 / 记笔记工具 disable_on_external_context = false # 接了 MCP 或联网搜索,按保密要求决定是否改成 true min_rollout_idle_hours = 12 # 源码注释建议 > 12h,避免抽取进行中的工作 max_rollout_age_days = 30 # 显式写死,别依赖默认值 max_rollouts_per_startup = 8 max_unused_days = 90 # 跨月回访的项目,30 天太短
1.
然后在交互式会话里用 P0 控制当前这个 chat:能不能使用已有记忆、能不能变成将来记忆的输入。这个选择只影响当前 chat,不动全局设置。
检查清单四步走:
先接受它不即时。下午五点刚结束的作业,晚上九点开新会话可能还没有记忆——它要等空闲够久,并且一次启动可能只跑完抽取、跳过归并。这是机制,不是异常。
再确认你关心的规范在哪一层。团队规范和硬限制搬进 P0,个人偏好和工程环境留给记忆,一次长作业里的假设与失败尝试交给工作上下文。用这条命令校验指令链是否真的加载:在库根目录跑 P0,它应该按优先级顺序复述。
然后打开目录看一眼。P0 里你的 P1 和 P2 写了什么,决定了未来每一次会话的起点。把 P0 分享给别人之前,这一步是必须的。
收尾,把记忆当资料而不是命令。不要在记忆文件里试图写指令——注入的提示词明确要求把记忆内容当资料看,写进去也只会被当成需要校验的历史。校验方法很直接:挑一条你反复交代的偏好写进 P0,开新会话看它是否还违反;再挑一条不涉及团队规范的个人习惯交给记忆,等它空闲过一轮后回来问它。两件事分开校验,你就知道每层各自的边界在哪。
参考来源:
OpenAI:Memories(官方说明与整体配置项)
OpenAI:Configuration Reference
OpenAI:Custom instructions with AGENTS.md
openai/codex:memories 机制说明(README)
openai/codex:memories 配置默认值
Daniel Vaughan:Codex Built-In Memory Deep Dive(两阶段流水线拆解)
J.C. Zhu:Codex Memory Internals(谁决定记忆,与 Open Code 对照)
Oleh Vanin:How I use Codex Memories(0.145.0 的实操配置)
:庞桂玉
来源:肥喵学AI Codex上下文项目AI记忆体系