一次脱敏脚本把 OGG 抽取进程打挂了。脚本涉及 40 多张表,开发要求一次成功,所有 DML 攒到最后统一提交,于是产生了一个体量惊人的事务。这套开发库挂着 OGG 同步,部署方式是 Downstream 集成捕获,抽取进程 EXTUAT1 直接 ABENDING。
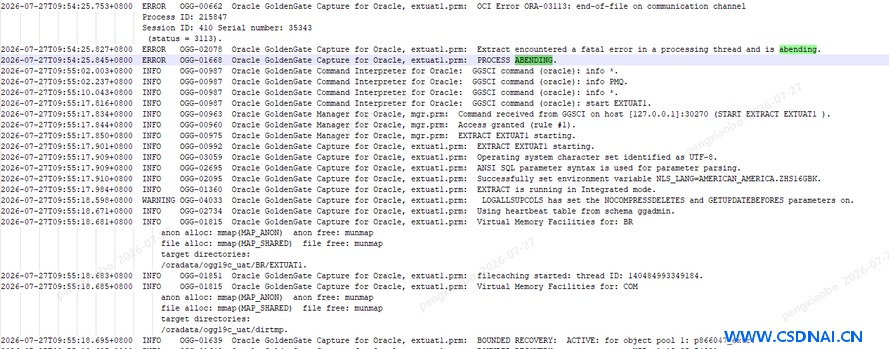
报错很典型:
2026-07-27T09:54:25.753+0800 ERROR OGG-00662 Oracle GoldenGate Capture for Oracle, extuat1.prm: OCI Error ORA-03113: end-of-file on communication channel Process ID: 215847 Session ID: 410 Serial number: 35343(status = 3113).
2026-07-27T09:54:25.827+0800 ERROR OGG-02078 Oracle GoldenGate Capture for Oracle, extuat1.prm: Extract encountered a fatal error in a processing thread and is abending.
2026-07-27T09:54:25.845+0800 ERROR OGG-01668 Oracle GoldenGate Capture for Oracle, extuat1.prm: PROCESS ABENDING.
ORA-03113 是会话被对端掐断,不是 OGG 自己退出的。结合大事务背景,问题指向下游挖掘库的 LogMiner 内核缓冲区被撑爆。
两层缓存,别混为一谈
Downstream 集成捕获的数据流是串行的,顺序不可逆:
源库 redo → 下游挖掘库 LogMiner(streams_pool / MAX_SGA_SIZE)→ OGG Extract 进程 → CACHEMGR(内存优先,可落盘)→ trail 文件。
第一层是数据库内核内存。LogMiner 解析未提交事务时,所有 redo 变更必须驻留在 SGA 的 streams_pool 里,这块内存没有磁盘 swap 机制。填满之后 LogMiner 无法继续缓存,Oracle 内核直接杀掉挖掘会话,Extract 收到 ORA-03113 后 abend。
第二层是 OGG 用户态缓存。CACHEMGR 管的是 Extract 进程自己的内存,超限可以溢出到 CACHEDIRECTORY 指定的本地目录。
顺序决定了因果:LogMiner 这关过不去,OGG 侧的磁盘缓存根本没机会生效。很多现场把 CACHEMGR 调得很大仍然崩,就是卡在第一层。
先判断瓶颈落在哪一层
别急着改参数,先定位。故障复现期间在下游挖掘库执行:
select component, current_size/1024/1024 mb, min_size, max_size
from v$memory_dynamic_components
where component like '%STREAMS%';
观察 streams_pool 的 current_size 是否逼近上限并持续上涨。同时查 LogMiner 会话:
select sid, serial#, status, event
from v$session
where module like '%LOGMINER%' or program like '%MS%';
如果会话在等待 streams 相关内存事件、随后消失,配合告警日志里的 ORA-04031,基本可以确认瓶颈在 LogMiner 层。Extract 日志里若出现 OGG-02051 或 ORA-03113 组合,同样指向这一层。
反过来,如果 Extract 报的是 OGG-02074(Large transaction exceeds cache limits)或 OGG-01668 且伴随 CACHEMGR 相关提示,说明事务已经解析出来,卡在 OGG 进程缓存,这时才轮到 CACHEMGR 磁盘溢出。
治本:让事务别长成巨兽
最有效的办法不在数据库参数里。只要事务及时 commit,LogMiner 立刻释放该事务占用的 streams_pool 内存,不会持续累积。40 多张表的脱敏脚本改成分批提交,每批几十万行以内,问题从根上消失。没有任何参数能替代这一条。
数据库侧扩容与参数配比
确认内存层不足后,先扩下游挖掘库的 streams_pool:
alter system set streams_pool_size=6G scope=spfile;
重启生效。然后同步上调 Extract 的 MAX_SGA_SIZE:
TRANLOGOPTIONS INTEGRATEDPARAMS (MAX_SGA_SIZE 4096,PARALLELISM 4,DOWNSTREAM_REAL_TIME_MINE Y)
这里有个容易翻车的配比问题。MAX_SGA_SIZE 是单个 Extract 向 streams_pool 申请的上限,如果它超过 streams_pool 实际可用内存,Extract 启动阶段就会报 OGG-02050 直接失败,连 abend 的机会都没有。调整前用上面那条 v$memory_dynamic_components 查询核对 streams_pool 的 max_size,保证所有 Extract 的 MAX_SGA_SIZE 之和留出余量。单进程不建议超过 4G,还要看主机物理内存和 SGA 整体分配。
另外 DOWNSTREAM_REAL_TIME_MINE Y 开启实时挖掘时,内存压力比归档挖掘更大,需要预留更多 streams_pool。如果业务允许延迟,关掉实时挖掘能缓解一部分压力。
OGG 进程侧的第二道防线
LogMiner 正常解析出事务之后,巨型事务会转而在 Extract 进程内存里堆积。这时启用 CACHEMGR 磁盘溢出:
CACHEMGR CACHESIZE 2048M
CACHEMGR CACHEDIRECTORY /ogg/tmp
CACHESIZE 是优先使用的内存上限,CACHEDIRECTORY 是内存满后事务临时实现的目录。注意这条配置救不了 MAX_SGA_SIZE 不足导致的会话被杀,它只保护解析成功之后的阶段。目录要提前建好并确认 ogg 用户有写权限,磁盘空间按最大事务体量预留。
应急组合配置
把上面几层拼起来,可直接套用:
EXTRACT extuat1
USERIDALIAS ogg_mining
TRANLOGOPTIONS MININGUSERALIAS ogg_mining
TRANLOGOPTIONS INTEGRATEDPARAMS (MAX_SGA_SIZE 4096,PARALLELISM 4,DOWNSTREAM_REAL_TIME_MINE Y)
CACHEMGR CACHESIZE 2048M
CACHEMGR CACHEDIRECTORY /ogg/tmp
WARNLONGTRANS 1H, CHECKINTERVAL 5M
LOGALLSUPCOLS
UPDATERECORDFORMAT COMPACT
EXTTRAIL /ogg/dirdat/lt
TABLE src.*;
WARNLONGTRANS 配合 CHECKINTERVAL 能提前在日志里暴露长事务,别等进程挂了才发现。
LogMiner 能不能落盘
不能。原生 Oracle LogMiner(集成捕获)不支持把未提交事务的 redo 溢出到磁盘,这是内核设计约束,没有 swap 机制。
Classic Extract 是另一回事。它由 OGG 进程直接读 redo,事务缓存全部交给 CACHEMGR 管理,可以落盘。这就是 Downstream 集成模式处理大事务天生更脆弱的原因:第一道关卡在数据库内核里,参数调不动它的落盘行为。
硬件到顶后的架构退路
如果业务持续产生超大事务,SGA 怎么扩都扛不住,可以考虑放弃 Downstream,切回 Classic Extract。它不依赖 LogMiner,不占下游库 streams_pool,事务缓存由 OGG 进程接管,支持磁盘溢出。代价是源库要部署 OGG 软件,源库压力上升,部署和维护复杂度都增加。
几个高频误区
配了 CACHEMGR 磁盘目录就以为能解决 MAX_SGA_SIZE 不足,实际瓶颈在数据库内核阶段,根本走不到 OGG 缓存。
把 MAX_SGA_SIZE 调到超过 streams_pool 可用内存,触发 OGG-02050,Extract 启动即失败。
以为实时挖掘和归档挖掘内存压力一样,实际实时挖掘压力更大,需要更多 streams_pool 余量。
处理路径按优先级排:拆分事务 > 扩容 streams_pool 并同步调整 MAX_SGA_SIZE > 启用 CACHEMGR 磁盘缓存兜底 > 硬件到顶后切换 Classic Extract。
ID:8022