Pretext 用 TypeScript 写了一个不碰 DOM 的多行文本测量与布局引擎。它不读 offsetHeight,不写样式,不触发 reflow,输出却要和浏览器字体引擎在 CJK、阿拉伯文、希伯来文、emoji、混合 bidi 下逐像素对齐。刚发布,势头很猛。
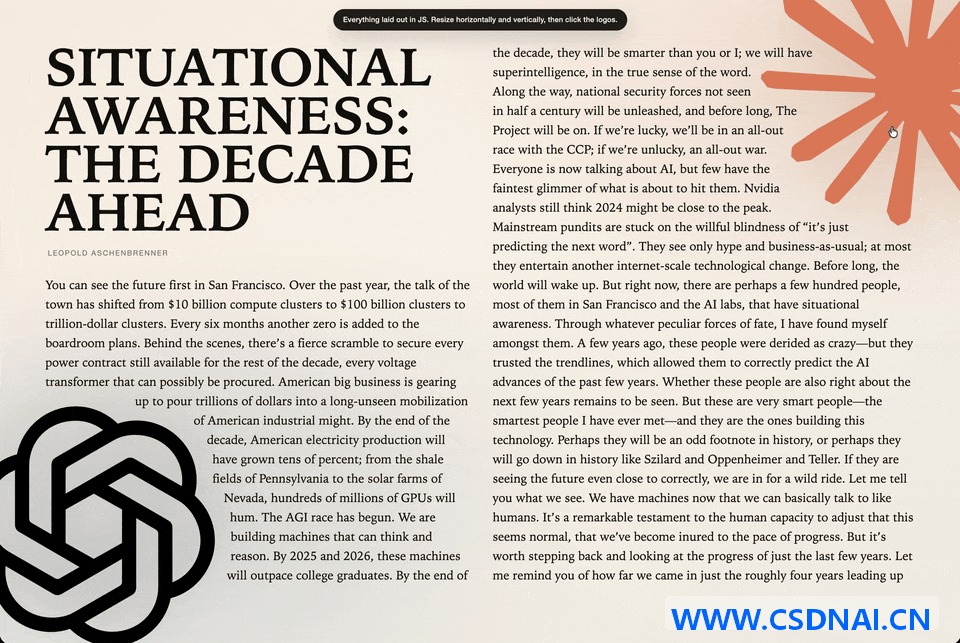
先说它拆掉的那颗雷。网页里任何动态文本——聊天流、文章卡片、虚拟列表、自动换行输入框、响应式排版——都要回答一个问题:这段文字塞进给定宽度的容器,到底占多高。传统做法是扔进 DOM,读 getBoundingClientRect,再写回样式。这一读一写就是一次强制同步布局。长列表滚动、窗口 resize、AI 内容流式吐字时,测量循环会把主线程压垮。工程上的妥协无非是批量测量、估算缓存、牺牲精度,代价是滚动抖动、CLS、虚拟化高度猜不准、Canvas 文字和 CSS 文字对不上。
Pretext 的思路是把测量前置。一次 prepare 做完全部重活,之后 layout 只剩数组索引和加减法,毫秒级返回,跨浏览器结果一致。整个库打包后只有几 KB。
两套 API 的分工
绝大多数业务场景只需要高度,用简单那套:
import { prepare, layout } from '@chenglou/pretext'
const prepared = prepare('AGI 春天到了. بدأت الرحلة 🚀', '16px Inter')
const { height, lineCount } = layout(prepared, 300, 24)
prepare 内部做空白规范化、按语义切段、套用换行规则、用 Canvas 逐段测宽并缓存,返回一个不透明句柄。layout 接收最大宽度和行高,直接吐高度与行数。font 字符串必须和 CSS 里的 font 声明完全一致,字号、字重、family 一个都不能差,行高也要对齐,否则精度会飘。
textarea 这类需要保留空格、tab、硬换行的场景,加选项:
const prepared = prepare(textareaValue, '16px Inter', { whiteSpace: 'pre-wrap' })
官方基准里,500 条混合文本 prepare 约 19ms,layout 同一批只要 0.09ms。组件 mount 时 prepare 一次,resize 时只跑 layout,帧率立刻不一样。把 1000 条动态高度消息列表从 DOM 测量加 rAF 节流换过来,虚拟化逻辑退化成线性遍历高度缓存,120fps 很稳。
高级 API 面向 Canvas、SVG、WebGL 和服务端渲染:
import { prepareWithSegments, layoutWithLines, walkLineRanges, layoutNextLine } from '@chenglou/pretext'
const prepared = prepareWithSegments(text, '18px "Helvetica Neue"')
const { lines } = layoutWithLines(prepared, 400, 28)
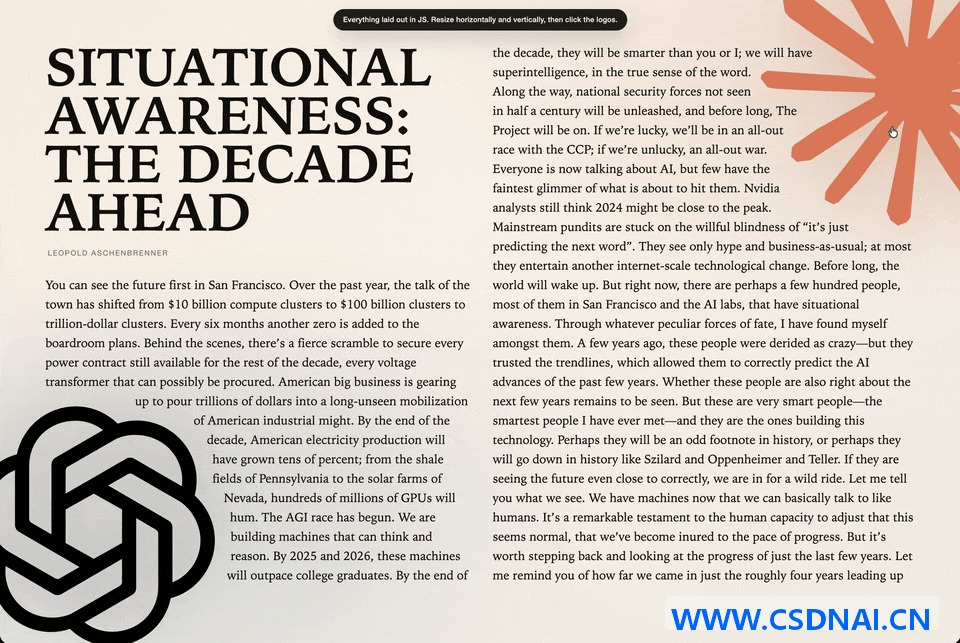
layoutWithLines 给出每行完整文本和宽度,直接喂给 ctx.fillText。walkLineRanges 更底层,只返回宽度和光标位置,不拼字符串,适合二分搜索最优容器宽度,比如聊天气泡的 shrinkwrap。layoutNextLine 是迭代器,能处理变宽场景——文字绕图、杂志多栏、浮动元素:
let cursor = { segmentIndex: 0, graphemeIndex: 0 }
let y = 0
while (true) {
 const width = (y < imageBottom) ? columnWidth - imageWidth : columnWidth
 const line = layoutNextLine(prepared, cursor, width)
 if (!line) break
 // 渲染 line.text
 cursor = line.end
 y += lineHeight
}
文本从黑盒变成可编程对象。CSS 只告诉你最终渲染结果,Pretext 让你提前拿到每一行的精确边界、宽度和断点。
精度从哪来
源码几乎没有废代码。核心是用浏览器自己的 Canvas 当真理源头,预先把文本拆成最小可测量单元并缓存宽度,换行逻辑用纯 JS 重写。
prepare 阶段先用 Intl.Segmenter 按 grapheme 切分——不是按 char,因为 emoji 和组合字符必须当一个单元处理。同时处理 Unicode 空白规则和 bidi 方向。然后对每段调 Canvas.measureText 测宽缓存。作者用 Claude Code 迭代了几周,对着浏览器真实渲染结果反复比对,确保每种容器宽度下的换行行为一致。它不自己造字体引擎,而是模仿浏览器最准确的那部分,再把结果前置缓存。
这里有个实际接入时最容易踩的坑:Canvas.measureText 在字体尚未加载完成时会用回退字体返回宽度,prepare 出来的缓存全是错的。必须在 document.fonts.ready 之后,或者显式 await document.fonts.load(’16px Inter’) 之后再调 prepare。字体切换、variable font 轴变化时同理,要重新 prepare 或调 clearCache()。原文强调 font 参数对齐,但时序问题才是精度漂移的头号根因。
另一个兼容边界在 Intl.Segmenter 本身。Safari 16.4 之前不支持 granularity: ‘grapheme’,老版本会直接抛错或退化。面向存量 Safari 的项目需要检测能力,降级到基于正则的 grapheme 近似切分,或者干脆把这类浏览器排除在精确布局路径之外。
布局阶段完全抛弃 DOM。换行算法基于缓存的段宽度做贪心加必要回溯,处理连字符、标点禁则、CJK 不换行等边缘 case。walkLineRanges 和 layoutNextLine 内部维护一个 cursor(segmentIndex + graphemeIndex),每次只算当前行能塞多少段,算完立即返回,没有字符串拼接开销。
whiteSpace 的处理是同一套引擎里最容易踩坑的部分。normal 模式自动合并空白、忽略换行;pre-wrap 保留原始格式,但走同一套测量引擎。bidi 混合文字(英文夹阿拉伯文)在分割阶段就考虑了方向性,所以无缝。缓存是性能王牌,相同文本和字体的多次 prepare 直接复用,clearCache() 留给频繁切字体的大应用。
它真正改变的场景
虚拟化列表。variable height 虚拟列表以前要么估高要么 DOM 测量后强制 rerender,滚动时容易闪。Pretext 提前算出全部高度,occlusion culling 变成线性扫描,Masonry 那种不规则网格也能跑满帧。演示里几十万个文本框滚动丝滑。
CLS 归零。新文本加载时不用等 DOM 渲染再调锚点,高度已知,scroll position 直接算。
Canvas / SVG / WebGL 一致性。同一份 prepared 数据,DOM 和 Canvas 两边渲染像素级对齐。游戏 UI、数据可视化、设计工具受益明显。
响应式高级排版。聊天气泡 shrinkwrap、最优宽度二分搜索、杂志式多栏流式、文字绕图,以前要一堆 CSS hack,现在一次 layout 调用。编辑器里的 drop cap、justification(社区已有人基于 Pretext 实现 Knuth-Plass)、widows/orphans 处理全部可编程。
AI 生成内容。流式输出不再卡在测量循环里,文本从”渲染后才知道”变成”生成前就知道”。
它不取代 CSS
CSS 继续负责最终绘制,Pretext 只管测量和布局决策。Tailwind、Flex、Grid 照用,只是文本高度变得可控。CSS 文本模块本来就是声明式、黑盒、浏览器实现导向的,从没为精确可编程设计过。Pretext 把控制权交回 JS,能做 CSS 做不到的事:变宽迭代、精确 shrinkwrap、跨平台一致、非矩形流式。
它也不是万能药。selection 样式不直接支持,演示里靠透明 canvas overlay 画选区。full justification 的高级微调还在社区扩展。服务端渲染和更多语言支持在 TODO 里。选型时要清楚:它适合测量密集、布局动态、对一致性要求高的场景;纯静态页面、少量文本、不需要预知高度的场景,DOM 测量加节流就够了,引入引擎反而增加字体时序管理的负担。
作者 Cheng Lou 在 React、ReasonML、ReScript 摸爬滚打,又在 Midjourney 做过视觉生成,对文本排版的痛点理解到位。他说这是爬过地狱才搞出来的基础件,我信。文本测量看着简单,实际是字体引擎、Unicode 规范、各家实现差异的叠加,普通人扛不住。
建议拿 demos 配合 AI 玩一玩。文本不再是瓶颈,而是创意的起点。
ID:7468