腾讯把 770B 参数的混元新版本放了出来,智谱那边匿名跑了一周的 Ox Alpha 也终于揭晓身份。这周的模型更新密度偏高,工具链和基建侧同样没闲着。
先看模型,再看工具,最后聊几条值得记一笔的产业变动。
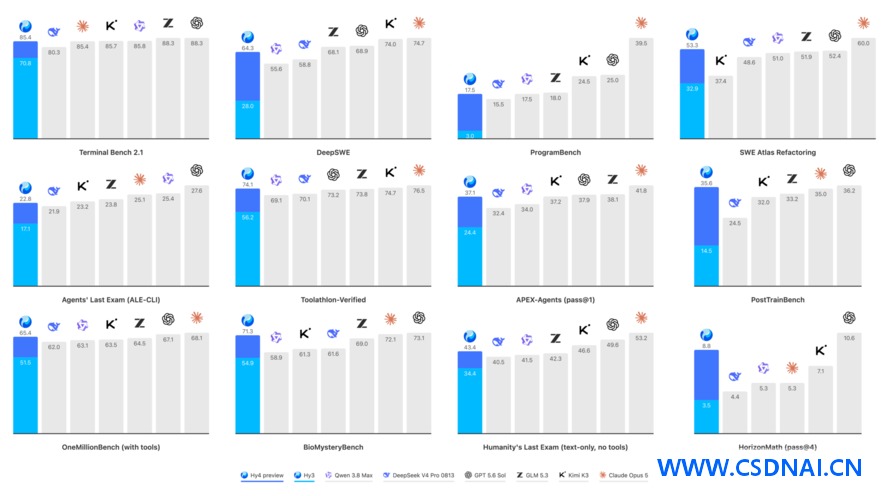
混元 Hy 4 preview:770B 总参数,激活 49B
腾讯开源了 Hy 4 preview,总参数 770B,激活参数 49B,上下文长度超过 1M。
这个尺寸放在开源阵营里属于第一梯队。目前它已经接入 Work Buddy、Code Buddy、元宝和 ima,外部开发者可以通过腾讯云 Tokenhub 或 Open Router 调用。
腾讯提到,Hy 4 preview 在训练过程中参与了自身调参方式、数据策略、评估体系和底层算子的优化,也参与了推理系统的算子融合与通信优化。端到端吞吐相比基线提升 31.8%。
这里有个判断:770B 总参数、49B 激活的 MoE 结构,意味着推理时对显存的需求远低于稠密模型,但部署门槛依然不低。想本地跑的话,先算清楚显存账。
Qwen 3.8-Flash-Next:Qwen 4 架构的提前预览
Qwen 开源了 Qwen 3.8-Flash-Next,官方把它定位为 Qwen 4 架构的早期预览。
这是一款多模态 MoE 模型。主体参数 125B,每个 Token 激活约 6B 参数,另外还有 51B 的 N-gram Embedding 参数。原生上下文 262K,可扩展至 1M。
架构调整集中在四个方向:Attention、Residual、Embedding 和 Optimization。Qwen 选择先把结构变化开放出来,让社区在完整 Qwen 4 系列推出前提前验证。
这种做法在工程上很务实。架构先放出来跑一轮真实负载,比等到全系列发布再暴露问题要好得多。
GLM-5.3-Flash:Ox Alpha 的真身
智谱发布并开源了 GLM-5.3-Flash。此前在 Open Code 和 Open Router 上匿名测试的神秘模型 Ox Alpha,就是它。
总参数 320B,激活参数 18B,采用稀疏注意力和线性注意力混合结构。这是 GLM-5 系列首个原生多模态模型。
智谱透露,Ox Alpha 匿名测试期间一度成为 Open Router 当周最受欢迎的模型,相关吞吐由国产 AI 芯片集群承载。模型权重已经开放。
320B 总参数、18B 激活,这个激活比例相当低。稀疏加线性的混合注意力设计,目标很明确:在长上下文场景下压低计算开销。
Pipette:端侧模型评测不能只看模型本身
Liquid AI 联合 Artificial Analysis 开源了 Pipette,一套面向端侧 AI 的模型评测工具。
Pipette 的思路和常规 benchmark 不同。它把 模型 + 量化方法 + Runtime + 设备 作为一个完整配置来验证,观察质量、速度、延迟和内存占用。
首批数据覆盖 30 多个模型、1000 多种配置,提供 macOS、Windows、iOS 和 Android 的测试客户端。

端侧部署的坑往往不在模型本身。同一个模型换一种量化方法、换一个 runtime,实际表现可能差出一大截。Pipette 把这几层拆开组合测试,方向是对的。
Wan 3.0:单次生成 30 秒视频,还能读 PDF
阿里云发布了 Wan 3.0 系列视频生成模型。
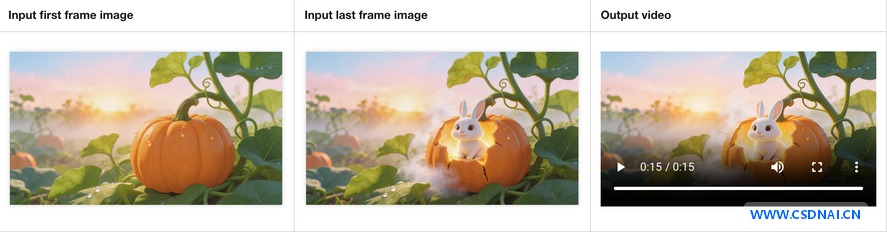
Wan 3.0 采用 All-in-One 设计,一套模型覆盖文生视频、首帧/首尾帧生成、多模态参考生成、视频编辑和续写。单次最长可生成 30 秒、30fps 的视频,原生生成对白、环境音乐和音效。
它支持一次使用最多 20 个多模态参考素材,包括图片、视频、音频、文本和网页。也就是说,一份 PDF、PPT 或网页都能变成视频生成的参考材料。
30 秒单次生成时长在当前的视频生成模型里属于较长水平。实际使用中,参考素材越多,生成结果的风格一致性通常越好,但推理耗时也会相应增加。
WeMM-Embedding:微信开源多模态 Embedding
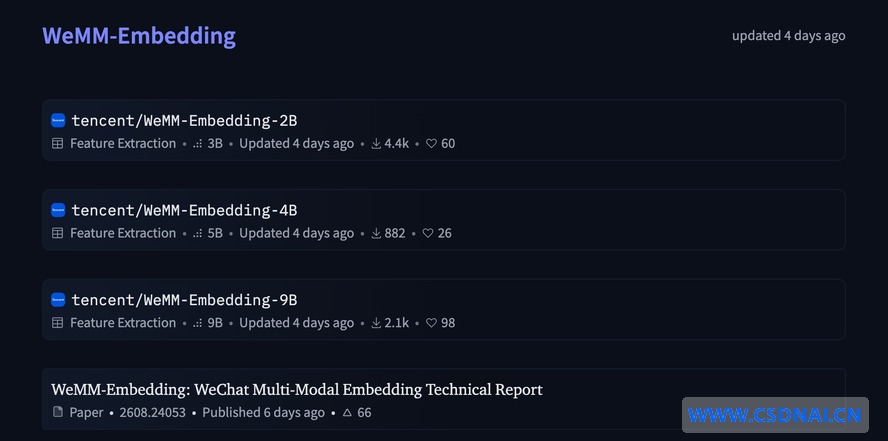
腾讯微信视觉团队开源了 WeMM-Embedding,提供 2B、4B 和 9B 三个版本。
这套模型能把文本、图片、视频、视觉描述,以及交错排列的多模态内容映射到统一的向量空间,用于检索、推荐和分类等任务。
根据技术报告,WeMM-Embedding 已经在视频号、公众号、朋友圈和电商搜索推荐等微信场景中落地。模型权重和代码同步开放。
多模态 Embedding 的难点在于跨模态对齐。文本和图片映射到同一空间后,检索时的语义一致性是否稳定,是评估这类模型的核心指标。
开源雷达:几个值得看的项目
OpenMAIC:一句话生成一整门课
OpenMAIC 是清华 MAIC 团队开源的多 Agent 互动课堂项目。
它可以从一个 Prompt 出发规划课程,再生成课程页面、幻灯片、测验、互动内容、项目式学习作业、图片、视频和语音。
新版加入了 Agent Workbench,可以通过对话让 Agent 规划、生成和修改整门课程。用户也能上传文档、音频和视频,或触发 Web Search,让课程围绕自己的材料搭建。
项目内置 20 个课程相关 Skill,支持替换模型、搜索后端、媒体服务和存储后端。
Archify:让 Coding Agent 给代码库画架构图
Archify 是一个面向 Cursor、Claude Code、Codex CLI 和 Open Code 的架构图 Skill。
它能读取代码库或系统描述,让 Agent 先输出结构化 JSON,再由 Archify 按确定性规则渲染成 HTML / SVG 架构图。
支持 Workflow、Sequence、Data Flow、Lifecycle 等图形,提供 Before / Delta / After 对比。
项目还会检查 Schema、布局、连线和标签位置,通过校验后才交付最终文件,压缩 Agent 随手画图时容易出现的结构错误。
这里有个坑:Agent 直接生成架构图时,连线交叉、标签重叠是常见问题。Archify 用确定性渲染替代自由生成,思路值得借鉴。
awesome-gpt-image-2:500+ 生图样例的可复用 Skill
awesome-gpt-image-2 是一套面向 GPT-Image 2 的 Prompt 模板与样例库。
项目收集并逆向整理了 500 多个生图样例和 20 多套工业级模板,再把主体、光线、材质、布局等 Prompt 元素拆成结构化模块,目标是让 Prompt 能像代码一样被组合和复用。
它还提供 GPT-Image 2 Style Library Skill,可以部署到 Claude Code、Codex、Cursor 等 Agent 中,让 Agent 从同一套样例库里挑选风格、模板和场景标签。
如果你经常需要给 Agent 写配图 Prompt,这个项目更像一份可触发的视觉风格库。
Crawl4AI:给 LLM 和 Agent 准备网页数据
Crawl4AI 是一个面向 LLM、RAG、Agent 和数据管线的网页爬取和内容提取工具。
它能把网页转换成结构清晰、适合模型读取的 Markdown,支持异步抓取、缓存、Session、代理、Cookie、自定义脚本和 Hook。
对于需要让 Agent 持续读取网站、做研究或搭建 RAG 数据源的场景,它提供了一套从网页访问、正文清洗到结构化提取的完整工具链,同时提供 CLI 和 Docker 部署。
这周有事:几条值得记的产业动态
OpenAI 决定不再向 Cursor 提供模型
OpenAI 宣布已通知 SpaceX,计划逐步终止向 Cursor 提供 OpenAI 模型的合同,拟定的终止日期为 11 月 12 日。
OpenAI 给出的理由是,在 SpaceX 完成对 Cursor 的收购后,公司无法确认相关技术会继续按照其支持条款使用。所以 OpenAI 选择在允许的最晚时间终止合同,同时也明确说明,现有合同为控制权变更提供了一段取消窗口。
DuckDB Labs 加入 AWS
Amazon 与 DuckDB Labs 签署最终收购协议,交易预计在 9 月初完成。DuckDB Labs 团队将加入 AWS,继续负责 DuckDB、DuckLake 和 Quack 等项目。
DuckDB 不会因为这次收购改变开源方式。DuckDB、DuckLake、Quack 等项目仍将在独立的 DuckDB Foundation 下维护,继续使用 MIT License,现有治理方式和路线图也会保留。
英伟达拟以 129 亿美元收购 Hugging Face
英伟达已同意以 129 亿美元收购 Hugging Face。
Hugging Face 在 2023 年融资时估值为 45 亿美元,英伟达当时就是投资方之一。如果这笔交易完成,收购价格接近三年前估值的三倍,也会成为英伟达规模最大的收购案之一。
截至当前,英伟达与 Hugging Face 尚未通过官方渠道公布完整交易细节。
Cloudflare 从 DNS 缓存里省出 100TB 内存
Cloudflare 本周分享了一次很典型的基础设施调优。
其 1.1.1.1 DNS 服务背后的 Big Pineapple 基础设施,维护着超过 2500 亿条 DNS Cache。工程团队调整了几处 Rust 数据结构后,把单条缓存记录的内存占用从 953 Bytes 压到 420 Bytes,下降 56%。
放到整个集群体量上,这些改动最终释放了约 100TB 内存。与此同时,缓存写入吞吐提升 43%,查询延迟下降 19%。没有增加新服务器,性能和内存都从数据结构里抠出来了。
这个案例值得反复看。Rust 里一个结构体的字段排列、对齐方式、枚举大小,在高频路径上放大到千亿级别就是巨大的开销。
Twitter 真的被人复活了
一家名为 Operation Bluebird 的美国初创公司发布了新社交平台 Twitter.now,重新使用 Twitter、Tweet、Retweet 等名称。
这家公司认为,马斯克把 Twitter 更名为 X 后,相当于放弃了部分相关商标权,所以在 2025 年向美国专利商标局申请撤销 X 持有的 Twitter 和 Tweet 商标。
X 随后起诉 Operation Bluebird,希望阻止新平台发布。今年 4 月,负责案件的法官曾在听证会上对 X 是否仍拥有一块商标权提出疑问,不过那只是初步意见,还没有形成最终书面裁决。
又拍云被执行近 900 万元
据公开执行信息显示,又拍云相关主体在 7 月和 8 月共被执行 3 次,执行金额合计接近 900 万元。
其中,一笔 239 万元的强制执行未能完成,杭州拱墅区法院随后对相关公司及其法定代表人签发限制高消费令。
索尼、华纳起诉 Anthropic
Sony Music Publishing、Warner Chappell Music 等音乐出版商在美国加州北区联邦法院起诉 Anthropic,并将 CEO Dario Amodei 和联合创始人 Benjamin Mann 列为个人被告。
起诉书指控 Anthropic 为训练 Claude,大量通过 BitTorrent、网页抓取等方式获取受版权保护的作品。称 Mann 在 2021 年从 LibGen 下载至少 500 万本盗版书,2022 年 Anthropic 又从 Pirate Library Mirror 获取至少 200 万本,原告还特别援引此前诉讼材料。
小鸭子机器人
Pollen Robotics 展示了 Microduck 的一套 sim2real 调参链路:在仿真环境里训练,搬到真机上运行,再继续教它新的动作。
Microduck 是 Hugging Face 旗下 Pollen Robotics 推出的 25cm 高开源双足机器人,售价 399 美元,SDK、模拟器和强化学习调参栈都已开源。
一只桌面小鸭子,也正经跑起了机器人调参链路。
ASCII 动态卡片
Praveen Kumar 做了一组 ASCII cards。尽管它由 ASCII 组成,但通过字符密度、颜色和动态变化,也能得到一个很有质感的动态卡片。
立体二维码
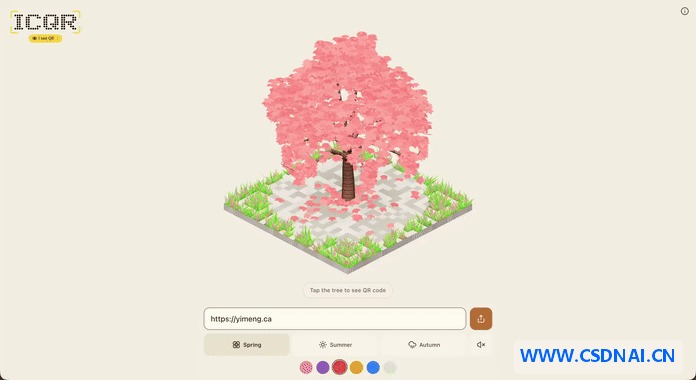
Manish Kumar 分享了一个挺漂亮的二维码玩法:输入一个网址,二维码会“长”成一棵 3D 树。
Qwen 画水彩
有人做了个很抽象的实验:拿 Qwen Coding Model 做强化学习,让它学会写 JavaScript 画水彩画。
让它编写 p5.brush JavaScript,再渲染成 PNG,通过参考画对照评分,方式是给 Qwen 一个水彩画 Prompt。
视频 4D 人
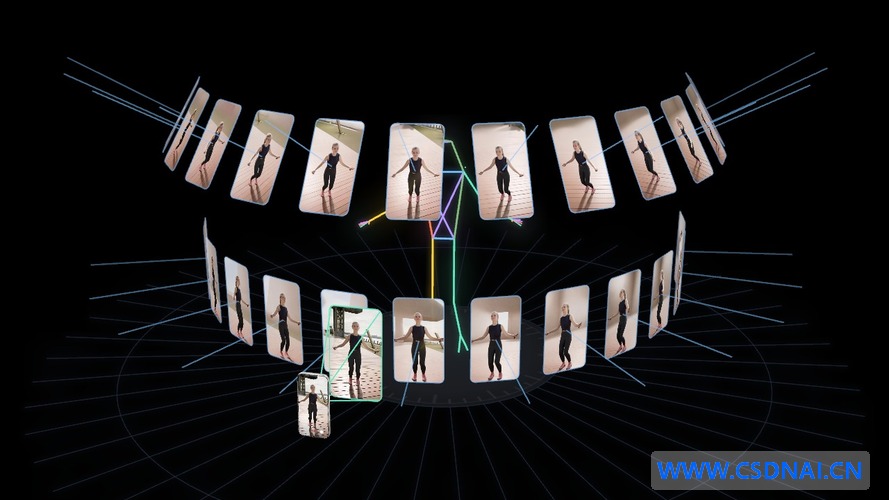
蚂蚁技术团队开源了 4DAnyone,能把一段普通单目人物视频转换成多视角视频。
项目具有 6、24、48 个视角以及不同俯仰角组合,生成结果可以继续用于 4D Gaussian Splatting 重建,实现 360° 或自由视角观看。
Claude 语翻译器
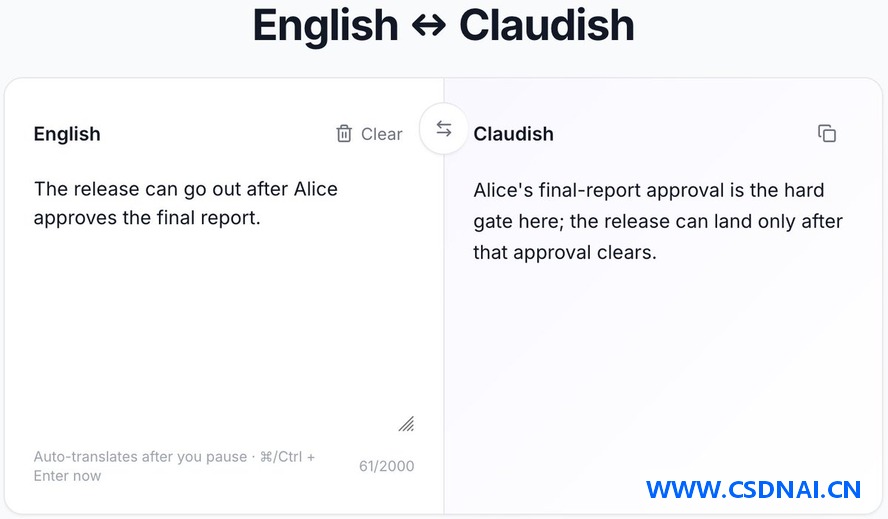
Yuntian Deng 发现 Claude 的表达方式有一股 Claude 味,便干脆做了个翻译器。它只有一个功能:English ↔ Claudish。