LLM 的本质并不神秘:用深度神经网络在大规模文本上预训练,再拿去做下游微调或直接推理。它真正值钱的地方,是从海量语料里学到了语法、语义和语言模式,于是能理解也能生成。
围绕这个能力,落地场景可以拆成九类。下面按输入输出的形态来讲,比按论文分类更贴近工程。
文本进、文本出:摘要、翻译、问答
这类任务归在 NLP 范畴,底层常见 Transformer 或 BERT。
摘要质量用 Rouge、BLEU 这类指标衡量,企业拿它自动归纳长报告,缩短决策链路。翻译服务通常在平行语料上训练,用 METEOR 评估,跨国团队靠它抹平语言障碍。问答系统依赖上下文感知算法,集成进现有系统后能给出实时、有数据支撑的回答。
语音转文本:转录与声控
核心是 ASR 系统,早期用隐马尔可夫模型,现在主流是深度神经网络。
会议场景里做实时转录,产出可搜索、可归档的文本记录。声控助手把 ASR 和 NLP 串起来执行命令,从仓库免提操作到零售客户交互都能用。
图像转文本:字幕与 OCR
特征提取靠 CNN,文本生成接 RNN 或 Transformer。OCR 会先做二值化等预处理,再用 k-NN、SVM 之类的分类器。
企业侧的价值是给视觉内容自动打标签、给发票自动分类。
代码生成:补全与修 Bug
在代码库上训练的语言模型能预测代码片段,加快开发节奏。领域 LLM 常用抽象语法树或控制流图提升准确率。
修 Bug 时一般把静态代码分析工具接进来定位漏洞,模型再给修复建议。
聊天机器人:客服与 FAQ
业务场景里的机器人常用决策树、有状态 LSTM,或者 GPT 这类更强的架构。训练数据往往来自企业历史客服对话,所以回答更贴合实际业务。
除了客服,它还能做线索挖掘、自动追加销售,人力成本降得很明显。
情绪分析:从评论和社媒读客户态度
靠 NLU 识别语言里的情感细微差别,工具层面有 TextBlob、VADER,也有更先进的神经网络模型。
接进 CRM 后可以做实时情绪跟踪,让互动更有针对性。
数据清理:找出并纠正错误条目
常用无监督算法,比如 k 均值或层次聚类,来定位异常数据点。结构化数据里的不一致,可以配决策树或规则系统识别。
清洗做不好,后面所有分析都不可靠,这一步对战略规划和运营效率是地基。
异常检测:识别离群点
统计方法用 Z 分数,机器学习用孤立森林。时间序列场景会用到 LSTM,检测随时间变化的异常。
欺诈检测、制造质检、市场趋势预测都能用,核心价值是提前识别并缓释风险。
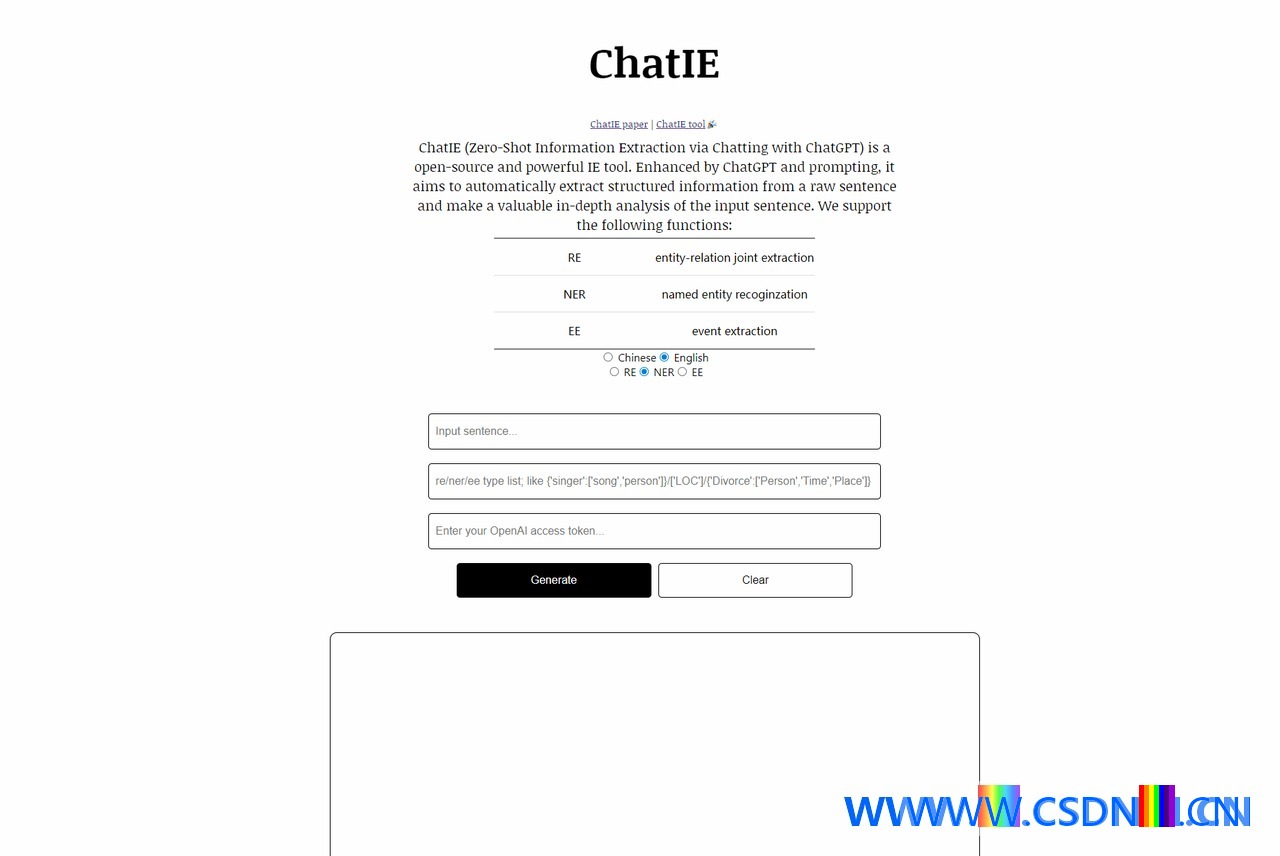
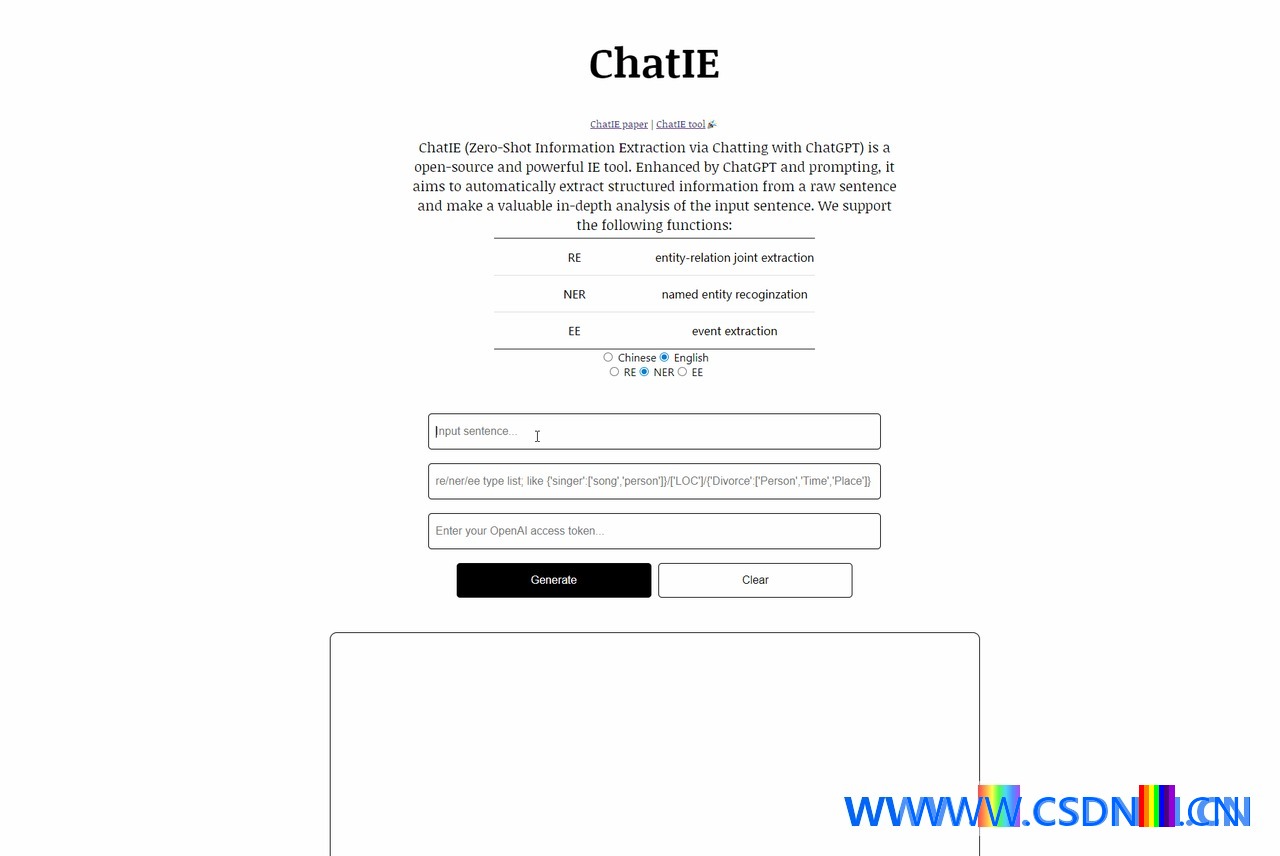
零样本信息抽取:Chat IE 的两阶段多轮问答
零样本 IE 的目标是在没有标注数据的前提下搭起抽取系统。人工干预少,所以难,但也正因为不用标注,省下的时间和人力非常可观。
GPT-3、ChatGPT 这类大模型在零样本下表现不错,于是有了基于提示的思路。Chat IE 把零样本 IE 改造成两阶段框架的多轮问答,覆盖三类任务:实体关系三元组抽取、命名实体识别、事件抽取。
两个语言、6 个数据集上的实验显示效果很好,部分数据集(如 NYT 11-HRL)甚至超过全监督模型。这为资源受限时搭建 IE 系统提供了基础。
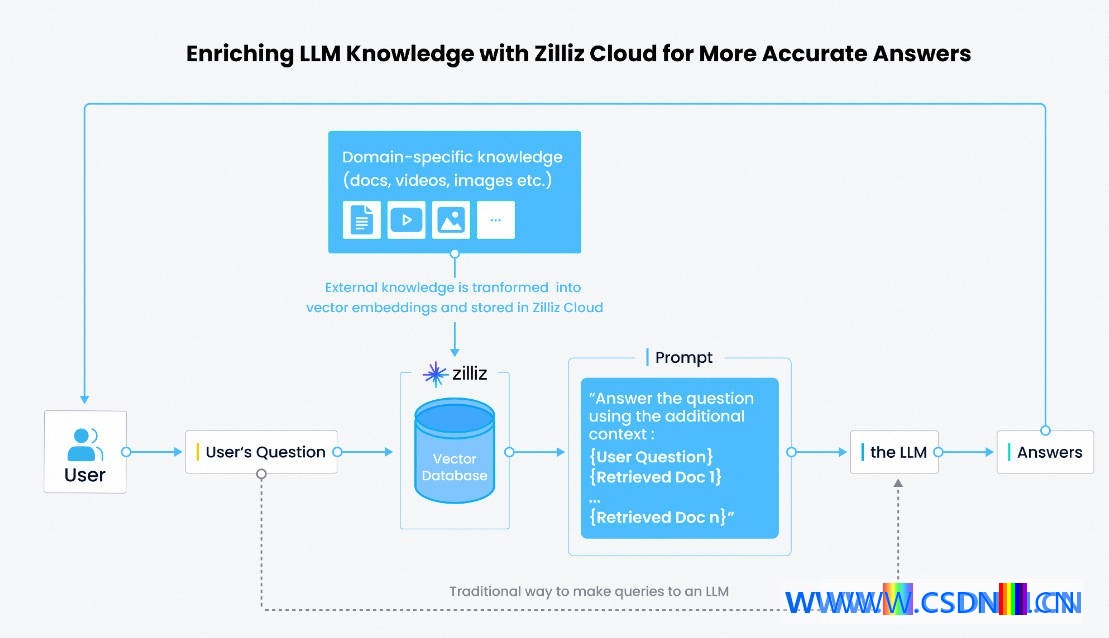
RAG:用 LangChain 把检索接进生成
LangChain 本身不提供 LLM,它做的是抽象,把 LLM 当成一个功能模块,再和其他模块组合出应用。说白了,它负责把 LLM 的能力和已有能力接起来。
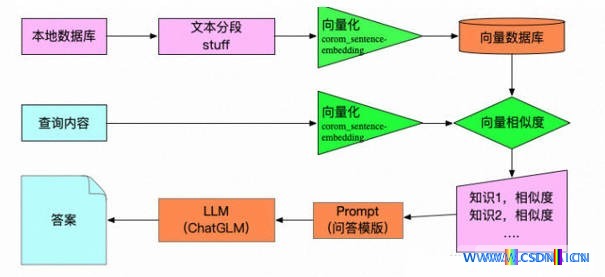
完整链路是:加载文件 -> 读取文本 -> 文本分割 -> 文本向量化 -> 问句向量化 -> 在向量库里匹配最相似的 top k -> 把匹配文本作为上下文和问题一起塞进 prompt -> 交给 LLM 生成回答。
这里有个坑:向量检索召回的 top k 只是候选,直接返回答案那是 Transformer 之前的做法。现在多了一步,让大模型对召回内容做归纳,回答的全局结构会好很多。
三个核心点:文本切割、embedding 与向量化存储、LLM 归纳。
切割粒度直接决定召回质量,切太碎会丢上下文,切太大会稀释相关性。embedding 选型要看语种和领域,通用模型在垂直语料上未必稳。
召回 top k 个 chunk 后,按类似下面的 prompt template 灌给模型做总结:
已知信息:{context}

根据上述已知信息,简洁和专业的来回答用户的问题。
工程上怎么选
文本类任务成熟度最高,直接上;语音和 OCR 依赖具体 ASR、识别引擎的准确率,上线前务必用真实业务数据跑一遍验收。
代码生成适合辅助补全,不建议直接信任它改生产代码。异常检测和情绪分析对数据分布敏感,模型漂移要定期校验。
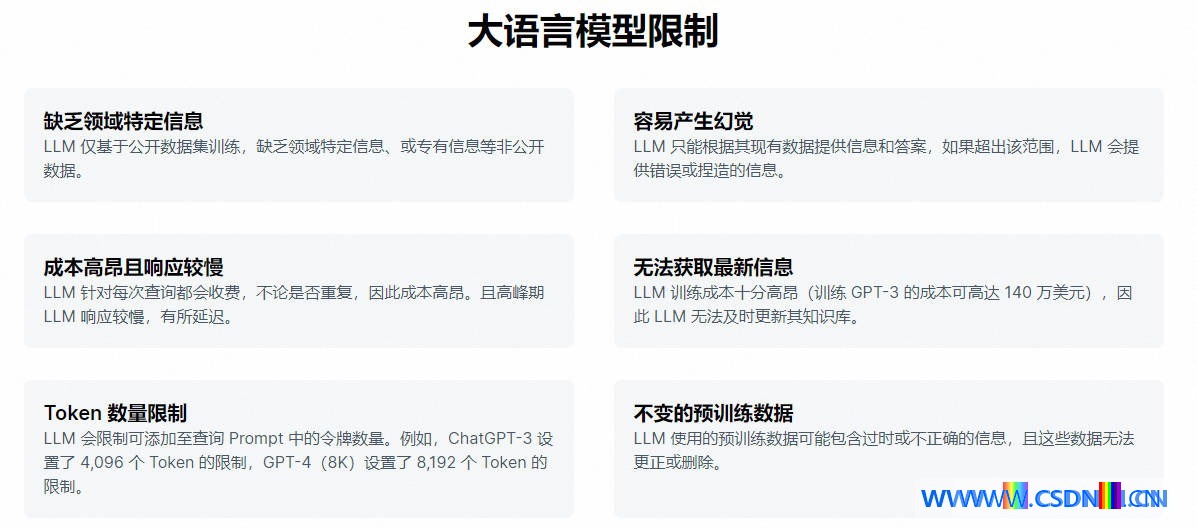
RAG 适合知识更新频繁、答案需要溯源的场景;如果知识库稳定且问题固定,微调反而更省推理成本。







