GPT-2 是一个自回归模型,由多层单向 Transformer 解码器堆叠而成。自回归的含义很直白:每生成一个新词,就把它拼回输入序列末尾,作为下一步的输入。训练方式属于自监督学习,从无标注文本里构造目标,让模型自己生成标签来调参。
GPT-2 与 GPT-1:从微调到零样本
GPT-1 走的是“预训练 + 下游微调”的经典路线。GPT-2 把模型规模拉大到 1.5B 参数,训练语料换成百万级别的 WebText。同期 BERT 最大只有 0.34B 参数,但 GPT-2 作者发现,单纯扩大模型和数据集,相对 BERT 的优势并不明显。
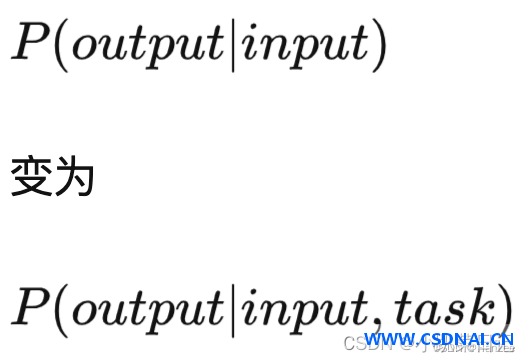
真正的变化在下游任务处理方式。GPT-2 的预训练目标和 GPT-1 一致,但不再对每个下游任务做微调,只做简单的 Zero-Shot 推理,效果就和当时微调过的模型相差不大。Zero-Shot 的意思是:模型对训练集中没出现过的类别,也能自动建立映射 XX -> YY。训练集和测试集的类别没有交集,靠类别描述把两边关联起来。
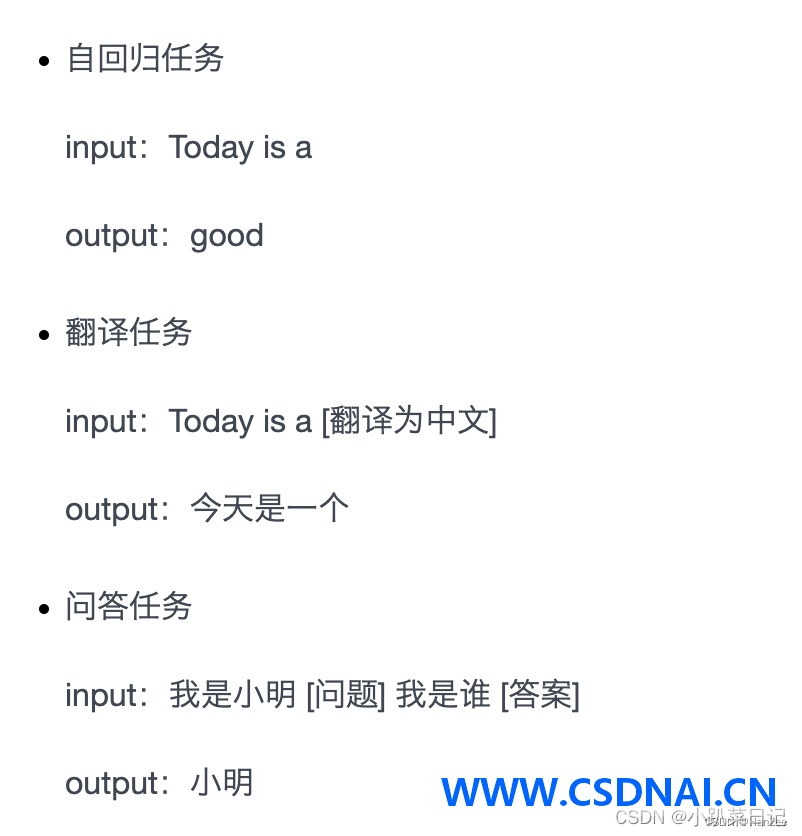
GPT-2 在输入里加了下游任务的相干描述,也就是后来所说的 Prompt。模型凭借预训练阶段获得的语言理解和生成能力,按提示产出符合任务要求的输出。
比如文本归类任务,用户给出任务描述(归类、每个类别分别是什么样子),GPT-2 直接按描述把文本分到不同类别,不需要针对特定类别微调。问答系统也一样,模型根据问题和上下文信息生成回答,不需要在特定问答数据集上微调。
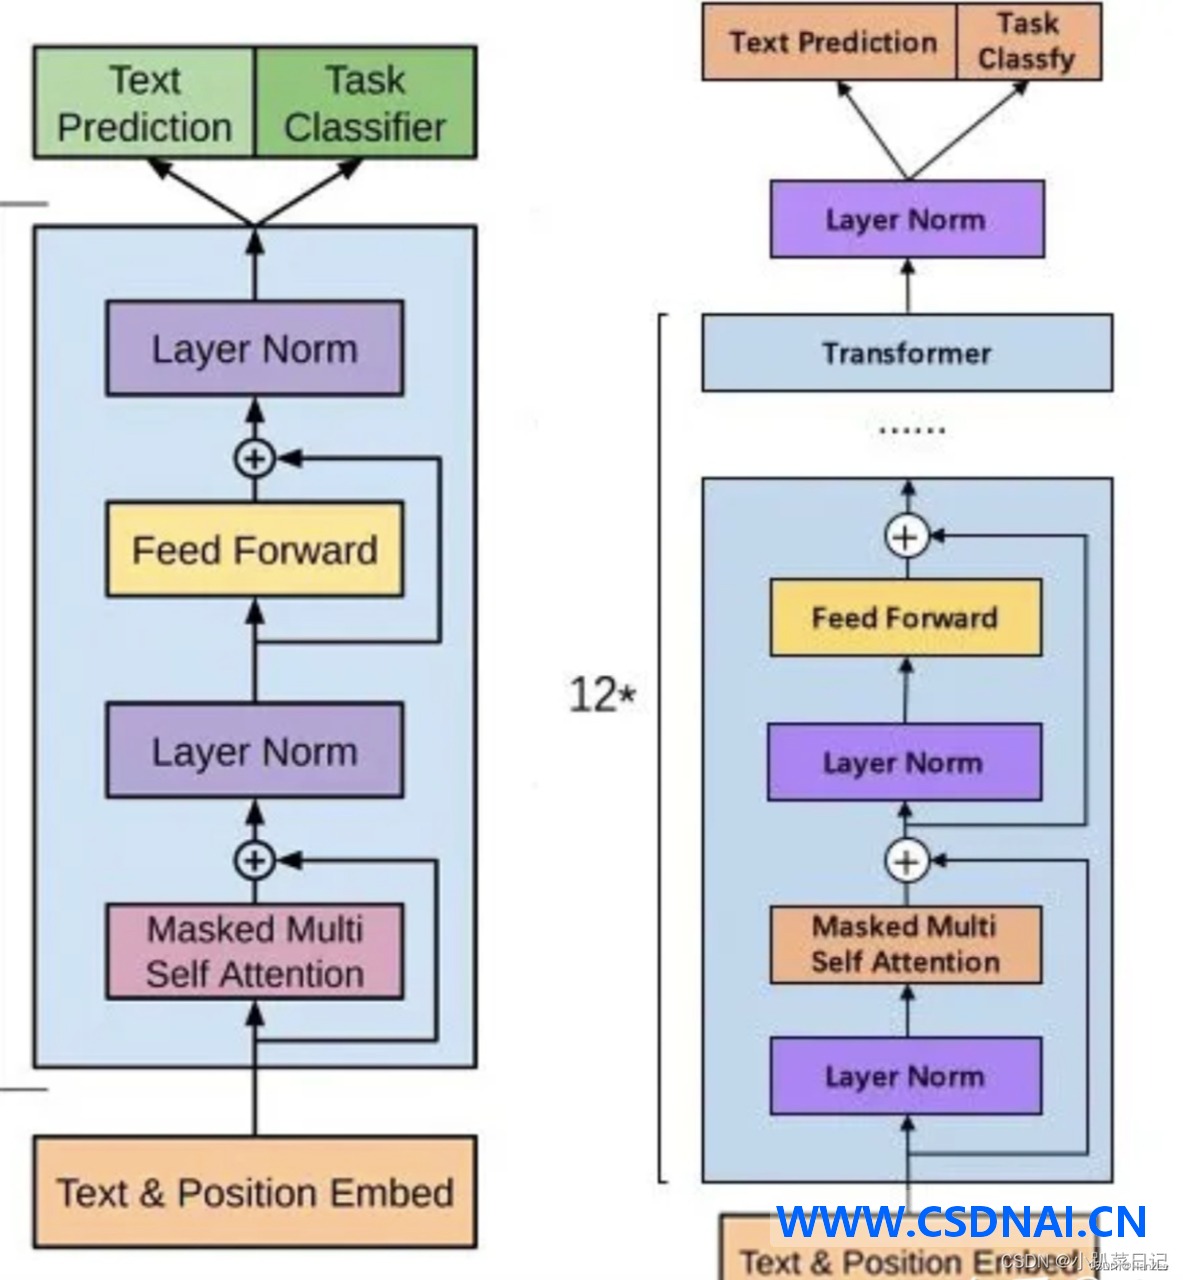
架构上还有一处改动:调整了每个 block 中 Layer Normalization 的位置。把 layer normalization 放到每个 sub-block 之前,并在最后一个块后再加一个 layer normalization。
GPT-3 与 GPT-2:规模升级与上下文学习
GPT-3 可以看作 GPT-2 的升级版,使用 45TB 训练数据,参数量达到 175B。它主导提出两个概念,情境(in-context)学习是核心。
情境学习的定义:给定几个任务示例或一个任务解释,模型应能通过简单预测补全任务中的其他示例。换句话说,预训练模型要理解任务本身。情境学习是对模型进行引导,教它应该输出什么。比如翻译任务可以输入:请将以下英文翻译为中文:Today is a good day。
情境学习分三类:Zero-shot、one-shot、few-shot。GPT-3 的口号是“告别微调的 GPT-3”,它可以用零条样例的 Zero-shot、一条样例的 One-shot、少量样例的 Few-shot 完成推理任务。
下游任务四种设置对比
Fine-tuning(FT):用成千上万的下游任务标注数据更新预训练模型权重。缺点很实际,每个新下游任务都需要大量标注语料,模型在样本外推预测时效果不好,FT 会导致泛化性降低。
Few-Shot(FS):验证阶段给少量下游任务示例作为限制条件,但不允许更新预训练模型权重。主要优点是不需要大量下游任务数据。主要缺点是跟 fine-tune 的 SOTA 模型性能差距较大,而且仍需要少量下游任务数据。
One-Shot(1S):这种方式与人类沟通的方式最相像。
Zero-Shot(0S):非常具有挑战性,即便是人类有时候也很难仅依赖任务描述、没有示例的情况下理解一个任务。不过 0S 设置下的性能最与人类水准具有可比性。
实际部署时容易忽略的几点
这里有个坑:Zero-Shot 和 Few-Shot 的边界并不稳定。同一模型在不同提示模板下,Zero-Shot 表现可能从接近随机跳到接近 Few-Shot。工程上不建议把 Zero-Shot 结果直接当成生产环境唯一判据,最好用固定验证集做回归对比。
另一个实际问题是显存。GPT-3 175B 参数即使做推理,全精度加载也远超单卡容量,必须用模型并行或量化。GPT-2 1.5B 在单张 24GB 卡上推理相对轻松,但做 Few-Shot 时上下文变长,KV Cache 会吃掉不少显存,长上下文场景要提前压测。
下面这段伪代码展示了 Zero-Shot 与 Few-Shot 在调用侧的区别,重点看 prompt 构造和是否更新权重:
验证与选型建议
测试 Zero-Shot 是否有效,可以构造两类验证集:一类是训练集中出现过的类别,一类是没出现过的类别。分别统计准确率,如果两者差距过大,说明模型泛化不足,Zero-Shot 并不适合当前任务。
Few-Shot 的验证则要控制示例数量,从 1 条、4 条、8 条逐步增加,观察性能曲线是否收敛。如果增加示例后性能没有提升,说明任务本身不适合上下文学习,应该回到 Fine-tuning 路线。
选型上,标注数据充足且任务固定,Fine-tuning 仍然最稳。标注数据少、任务多变、需要快速上线,优先考虑 Few-Shot。Zero-Shot 适合做原型验证或对准确率要求不高的场景,不建议在生产环境单独依赖。



