向量和业务数据分家,代价从来不在第一次同步。真正难缠的是后面那条常驻同步链路、那个新鲜度窗口、那份跨系统的权限治理,还有两份数据副本之间的一致性。快手把这条路换掉了:向量留在 Paimon 表里,检索由 Doris SQL 发起,下推到湖上执行。
原有的人湖链路不用动,普通 OLAP 读取方式也不用改。Paimon 2.0 提供 Vector Index,Doris 通过 Paimon Rust 读索引和数据,按桶并行完成召回与回表。
Paimon 2.0 的索引底座
Paimon 2.0 的 Vector Index 建在普通表之上,分两种形态:append 表的 Global Vector Index,主键表的 PK Vector Index。两者共用同一套索引实现和检索模式,差别只在索引怎么构建、命中结果怎么回表。快手的业务表是主键表,后续讨论都对应后者。
索引文件和数据文件是物理解耦的。一个 Snapshot 同时引用 Data Manifest 和 Index Manifest,后者记录索引文件的类型、字段、位置和覆盖范围:append 表记 Row ID 范围,主键表记源数据文件。加索引不用改数据布局,同一张表继续服务批处理、流处理和普通 OLAP。
图 1 画出了这层关系。
向量列用 ARRAY 或定长 VECTOR 声明。主键表的向量索引走表属性配置,随 compaction 自动构建,不需要单独触发。Spark SQL 建表时声明索引列、索引类型和距离度量:
CREATE TABLE vector_items (
item_id BIGINT,
embedding ARRAY<FLOAT> COMMENT '__VECTOR_FIELD;2048',
payload STRING
) TBLPROPERTIES (
'primary-key' = 'item_id',
'bucket' = '32',
'deletion-vectors.enabled' = 'true',
'pk-vector.index.columns' = 'embedding',
'fields.embedding.pk-vector.index.type' = 'ivf-rq',
'fields.embedding.pk-vector.distance.metric' = 'l2'
);
Spark SQL 没有 VECTOR 类型,列注释 VECTOR_FIELD;2048 把 ARRAY 声明成 2048 维定长向量;nlist 这类构建参数通过 fields..pk-vector.index.options 以 JSON 传入;精排倍数 refine_factor 可以放在表属性里,也可以放到查询选项里。
写入之后,compaction 把桶内文件合并到 Level 0 以上时,顺手为向量列生成一个索引段,登记到 Index Manifest,由新的 Snapshot 引用。索引段记录它覆盖的源数据文件,命中结果映射回文件内的物理行位置。新写入的数据在下一次 compaction 之前不属于任何索引段,这段中间状态要靠检索模式兜住。
五类索引怎么选
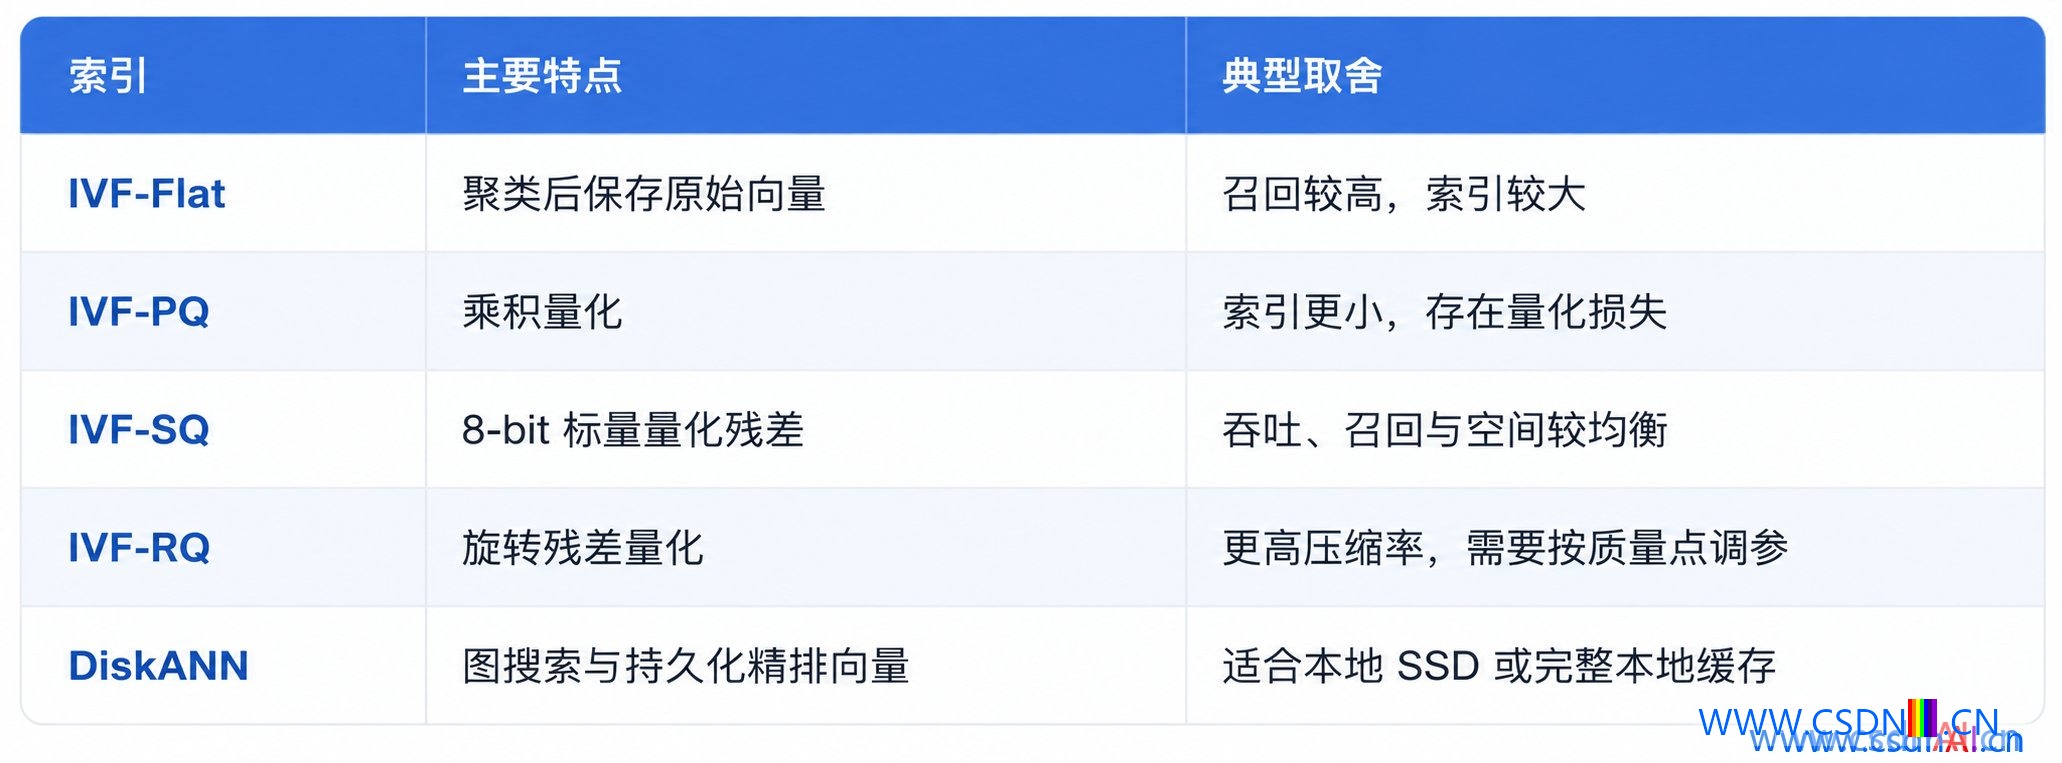
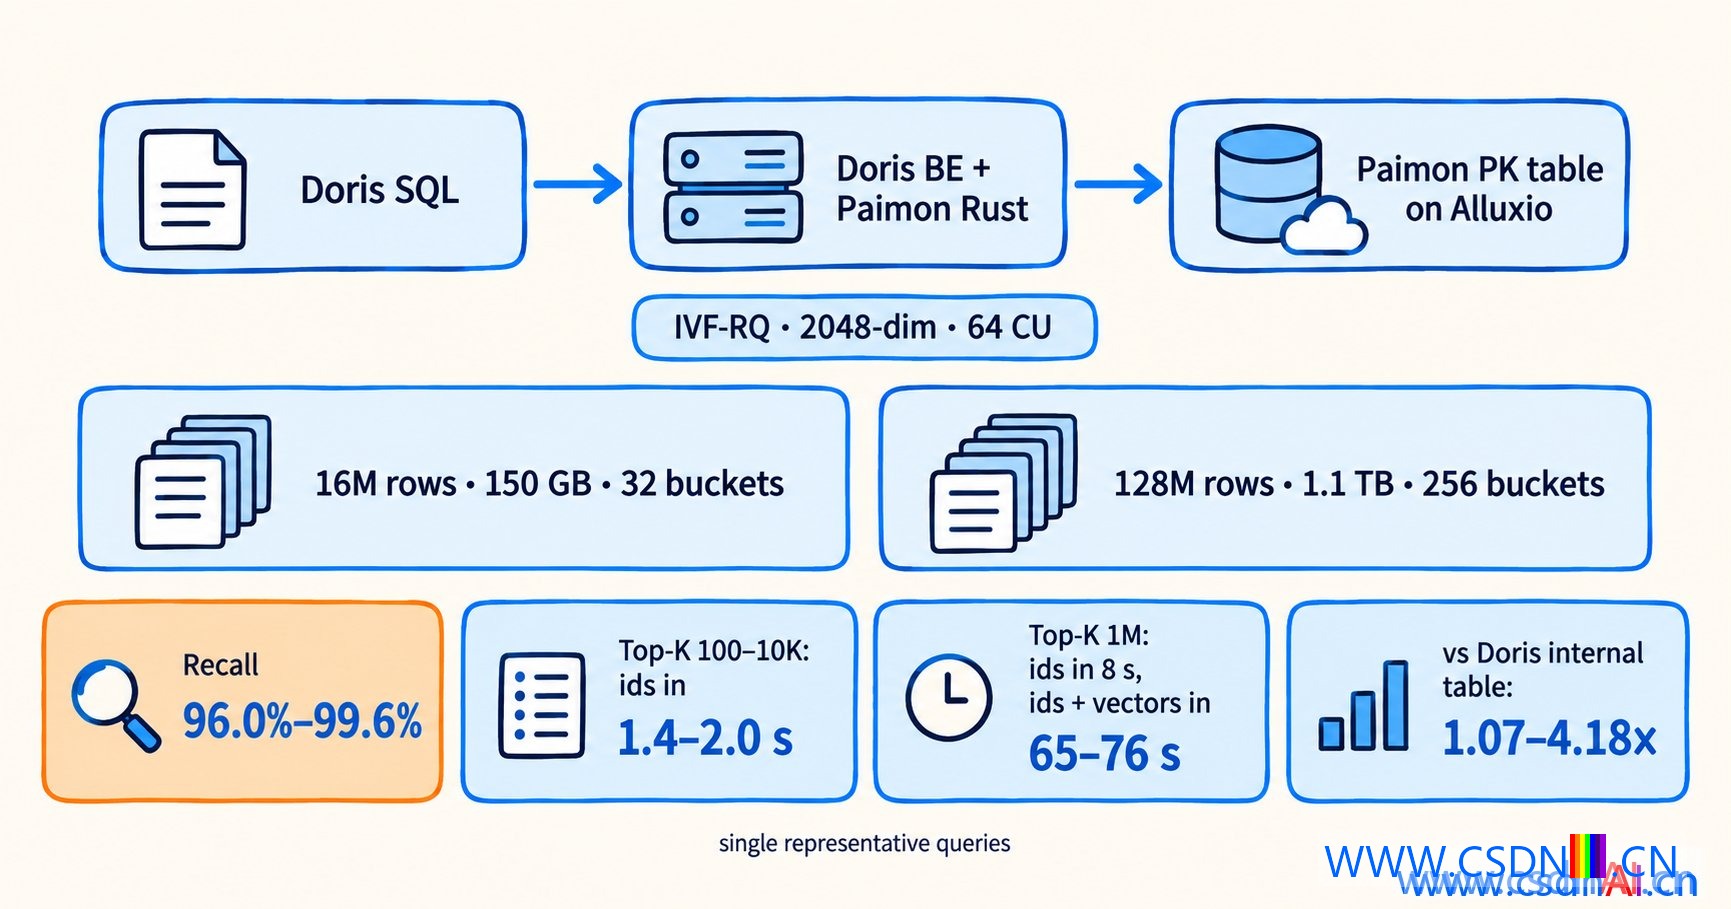
Paimon 2.0 当前支持五类索引实现,性能、召回、索引大小、构建耗时各有取舍。亿级 2048 维向量按原始精度存,索引体积会很大,远端读取量跟着涨;RQ 的旋转残差量化压缩率更高,代价是要按质量目标调参。快手最终选 IVF-RQ,在压缩率和召回之间取平衡,实测 Recall 落在 96.0%~99.6%。
读取链路:从 JNI 换到 Paimon Rust
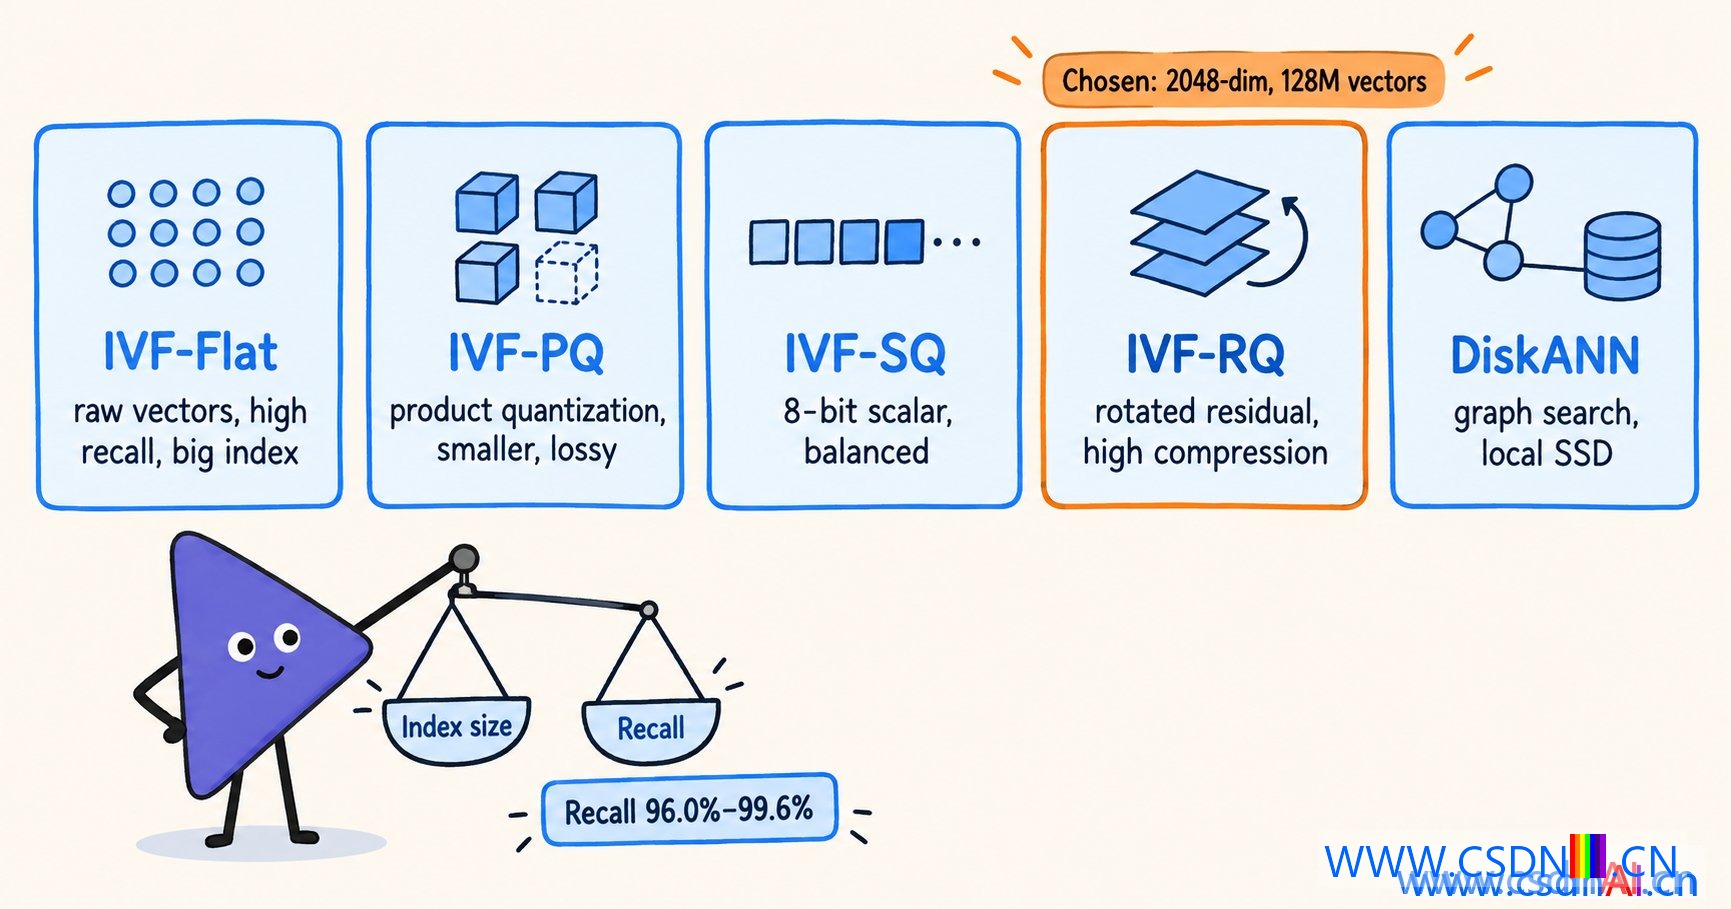
Doris 早期读 Paimon,MOR 场景要经 JNI 调 Paimon Java SDK 读合并数据。这条路有两个硬伤。
一是 JVM 内存没法按查询粒度跟踪管控。一个大查询把内存吃光,Doris 侧看不到细粒度指标,也压不住。二是 MOR 内存占用大,多并发直接把 JVM 打到 OOM;把堆调大,又挤占 BE 的 native 内存。
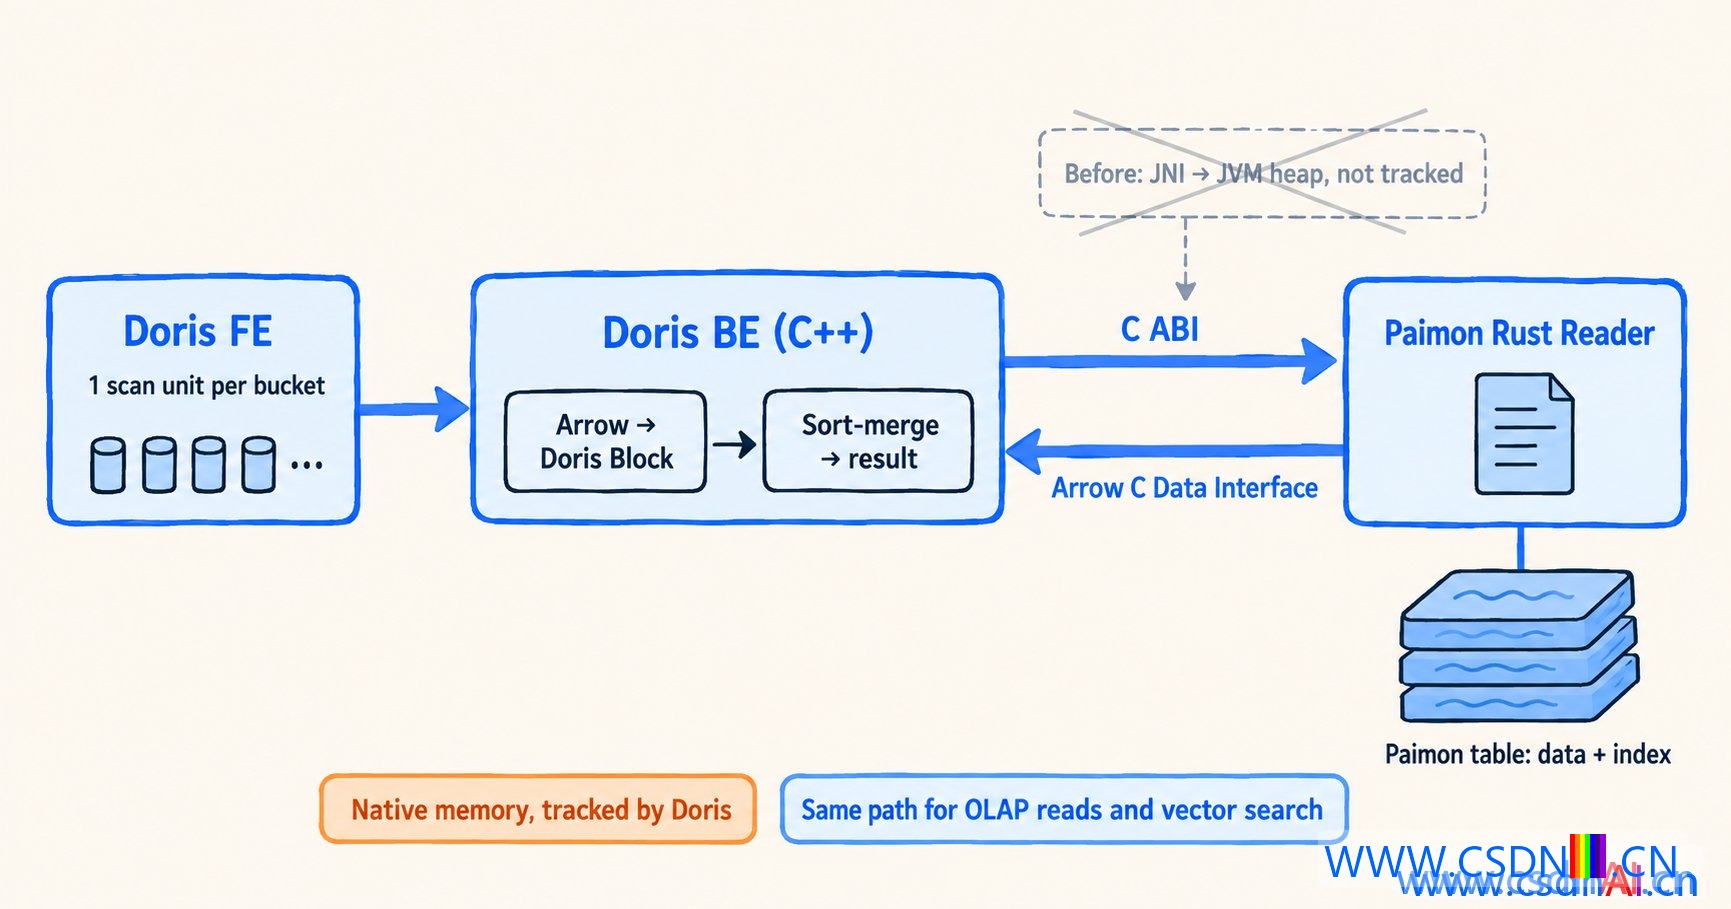
快手实测后换成 Paimon Rust。它由 Paimon 官方团队维护,MOR 和索引读取都能跟 Java 版本同步。实测读取性能是 Paimon Java 的 2~3 倍,比 Doris 原生 reader 慢约 10%,差距主要出在 Arrow 到 Doris Block 的内存格式转换上。Paimon Rust 用 native 内存,能纳入 Doris 已有的内存管控体系统一管理。
代码层面,Doris BE(Backend,C++ 执行进程)通过 C ABI 调 Paimon Rust Reader,结果经 Arrow C Data Interface 在 Rust 和 C++ 之间传递,再转成 Doris Block 交给执行层。Arrow 是列式格式,Rust 侧产出的数据能被 C++ 侧直接按列消费,中间省掉一次逐行转换。
普通读取和向量检索共用这条链路。
检索为什么必须下推
向量检索和普通读取有个本质区别:一次 Top-K 要读哪些行,读之前不知道,必须先在索引里算出来。Doris 如果不利用索引,ORDER BY … LIMIT 形式的向量 Top-K 会退化成全量计算——把整列向量读进 BE 内存,逐行算距离再排序。1.28 亿行、2048 维的规模下,单次查询要搬约 1 TB 向量数据。
所以检索必须下推到湖上索引。动手之前得先看清 Paimon 主键表向量索引的四个特性。
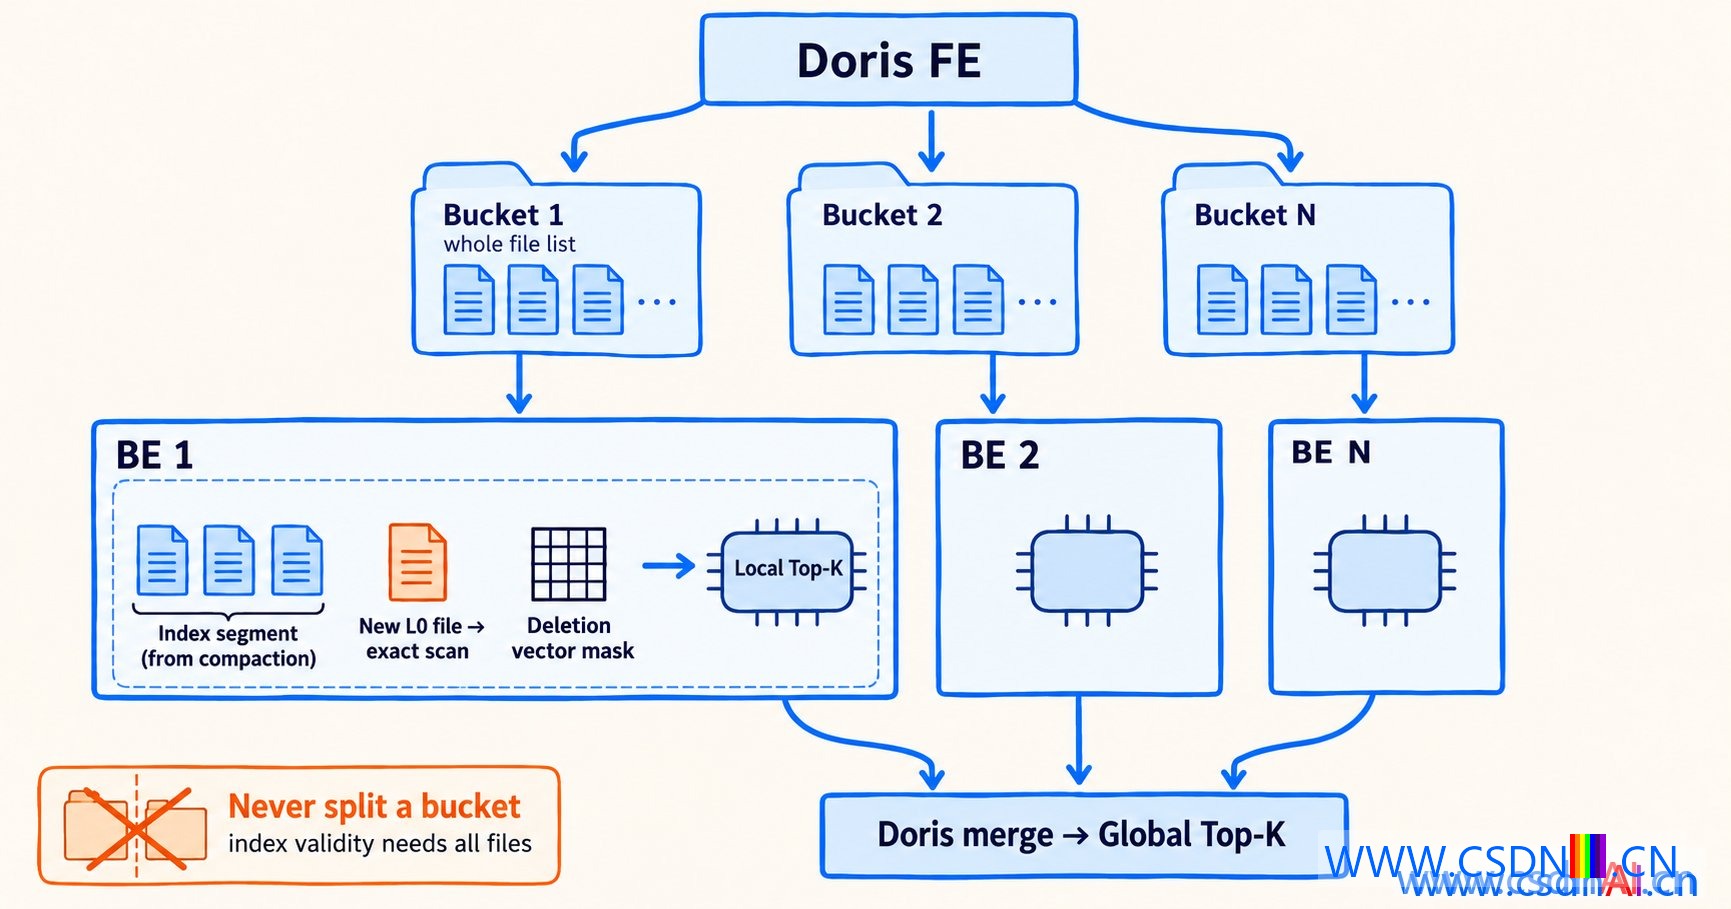
索引按 (Partition, Bucket) 组织,桶既是数据分片单位,也是索引单位。索引由 Paimon 后台 compaction 产生,只覆盖已 compaction 的数据,刚写入的 L0 文件不在任何索引里。一次正确的检索要归并三个操作:索引召回、未覆盖文件的精确回退、删除向量(Deletion Vector)掩码计算。
一个索引段是否有效,取决于它覆盖的源文件集合是否仍等于该桶当前的活跃文件集合。这个判断需要看到整个桶的完整文件集。
快手业务表是主键表,行会被更新、合并,没有稳定的全局 Row ID。索引记录的是物理坐标:数据文件加文件内行号。召回后要按物理行号回数据文件取行。
Doris 的索引查询规划据此展开:
FE(Frontend,负责查询规划)按 Paimon 表的桶枚举扫描单元,拿到每个单元的完整文件清单;扫描单元下发给不同 BE 节点,多台 BE 并行处理各自分到的桶,在桶内完成召回、精确回退、精排、回表和删除向量应用;跨桶的全局 Top-K 由 Doris 自己的排序归并算子收口。
向量检索由 Paimon 内核(Paimon Rust)完成,Doris 侧承担分布式调度与结果归并。整桶下发、分桶并行的执行方式见图 4。
Top-K 改写与 Index-Only Scan
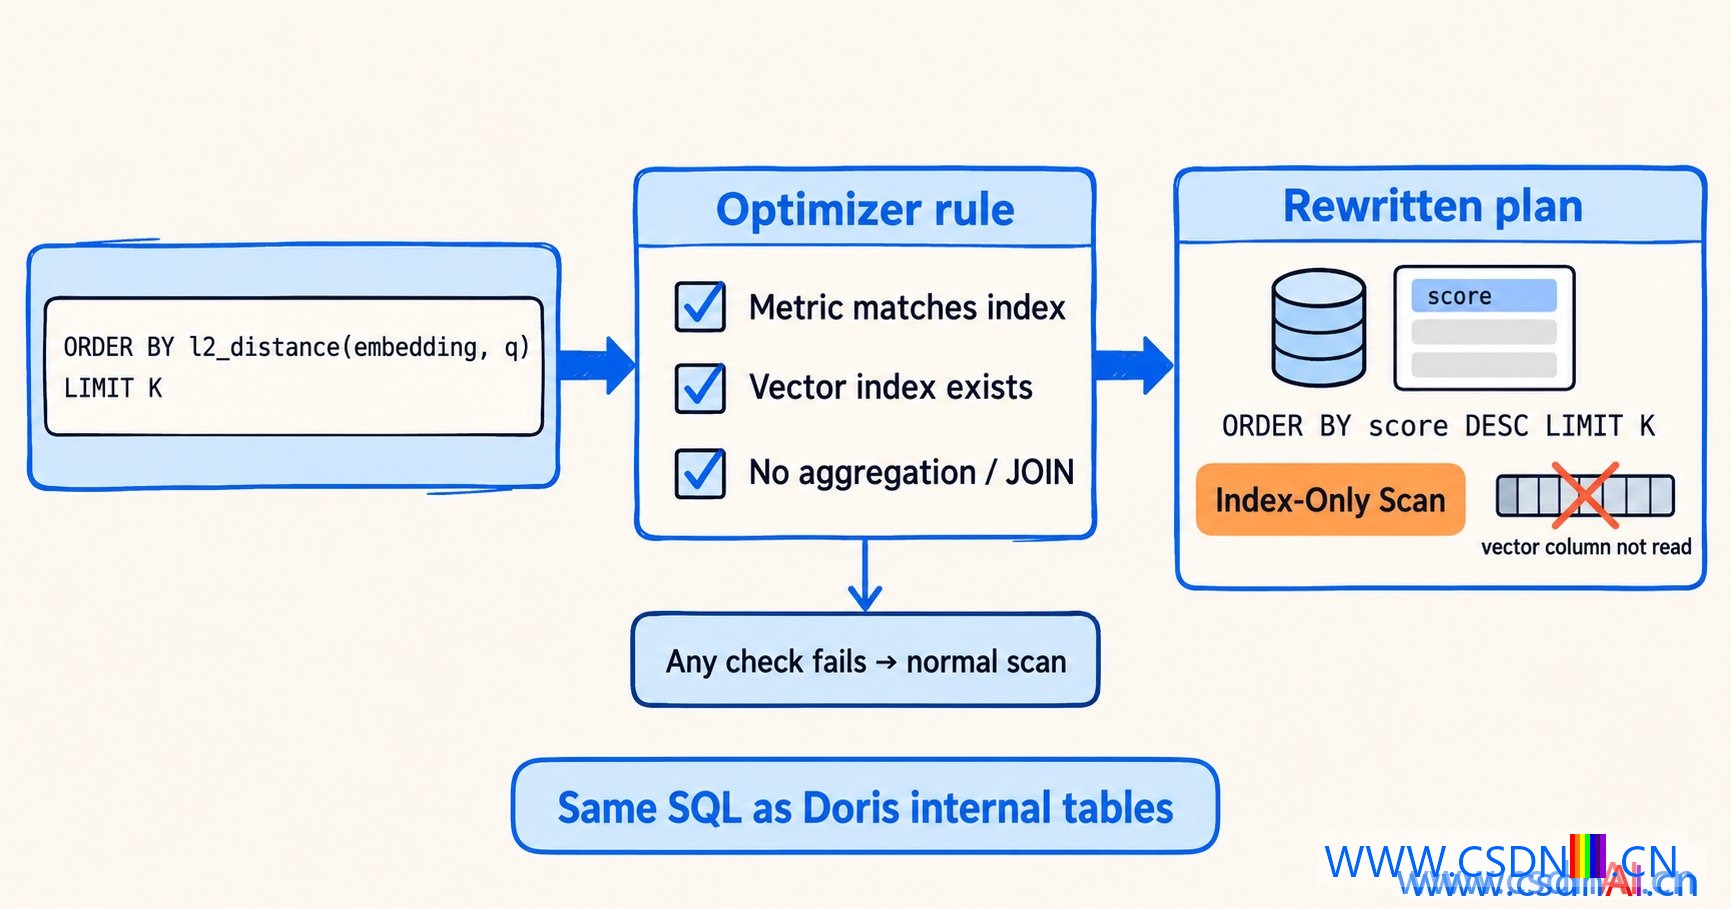
标准向量检索 SQL 按距离排序取前 K 条。Doris FE 加了一条优化器规则,识别这个模式并改写执行计划:给扫描节点加一个检索得分列;把原 SQL 里的距离表达式改成对得分的换算,不再重算距离;排序从按距离升序改成按得分降序。
再进一步:SELECT 列表里没有出现向量列本身时,就完全不读原始向量列,也就是 Index-Only Scan,省掉向量列的读取与传输。
识别条件有三条:距离函数与索引配置的度量方式一致;该列存在向量索引;SQL 中不含聚合或 JOIN。任一条不满足就退回普通扫描,保证结果正确。
带过滤条件和分页的语句同样走这条规则。分区谓词在 FE 用于裁剪分区,只保留相关分区的桶;能转成 Paimon 谓词的条件下发到 Paimon Rust,在检索前收敛候选,即前置过滤(过滤列没有索引时需要扫描该列);用到 Doris 函数的谓词,比如 length(a) > 1,没法下推,由 Doris 对检索结果做后置过滤。分页的 OFFSET 与 LIMIT 合并成一个更大的 K 下推,真正的偏移交给上层排序算子。
用户写的是和 Doris 内表向量检索一样的 SQL,不改语句就能用上 Paimon 表上的向量索引。
大 Top-K 的坑:检索和物化要拆开
一个典型的 Top-K SQL:
select id, embedding from vec_table
order by l2_distance_approximate(embedding, [...])
limit <K>;
K 小的时候,一次扫描拿 id 列和 embedding 再检索,开销不大。
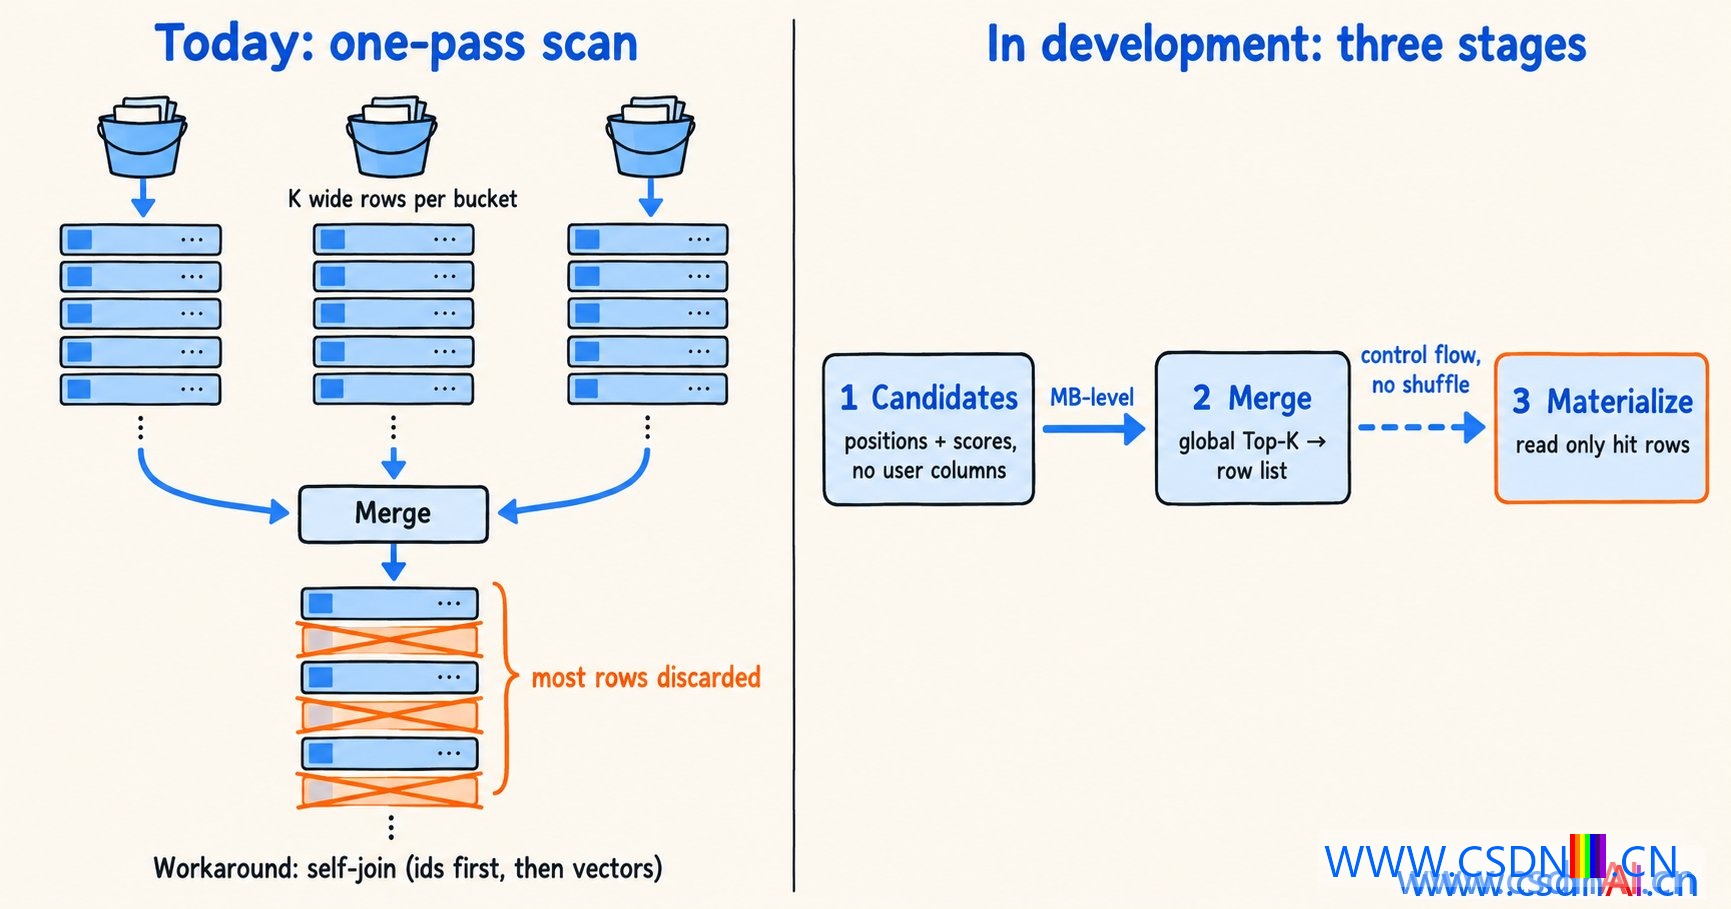
K 一大,代价就上来了。每个桶都要按 K 读出候选行的全部用户列,而这些行绝大多数会在全局合并时被丢掉。K = 100 万、向量列 2048 维时,每个候选行带 8 KB 向量数据(2048 × 4 字节),丢得越多,无效读取越多。
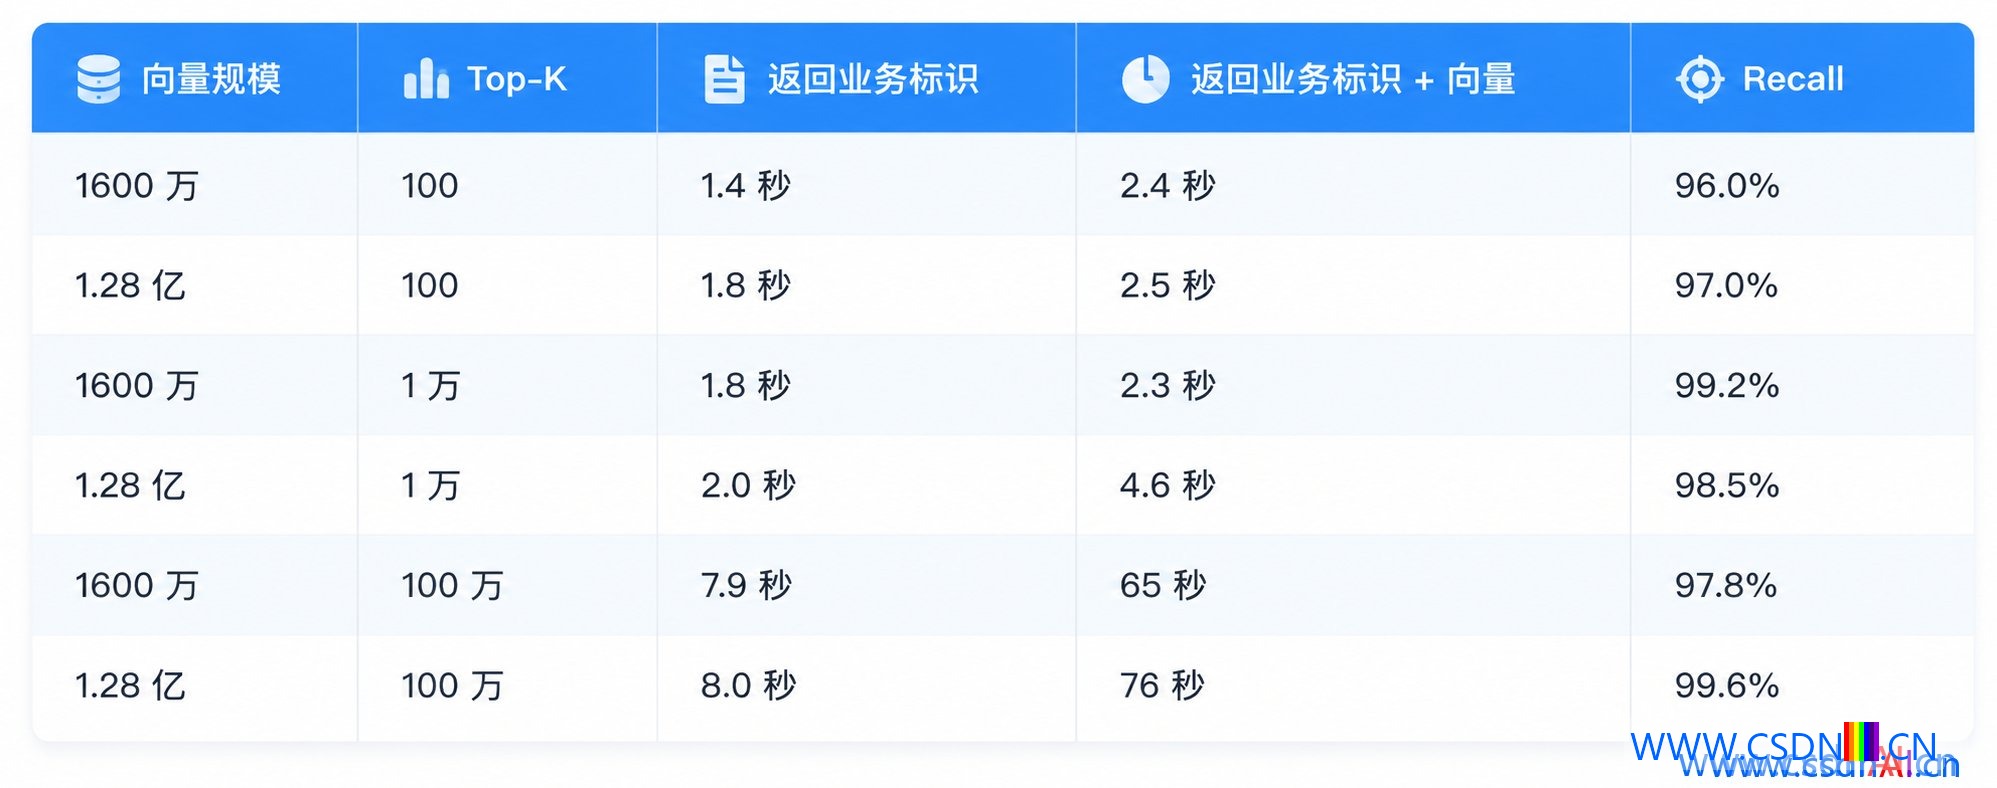
快手当前的做法是把这类查询改写成自关联:先用只返回 id 的子查询完成召回,再关联原表取回命中行的向量,写法见第 3.2 节。关联时候选 id 集合下推到 Paimon 读取层,读取器据此排除无关文件和行组,再用 Parquet 页级索引跳过无关页面,只物化命中行的向量列。实测数据里,Top-K = 100 万时只返回 id 为 7.9~8.0 秒,连向量一起返回是 65~76 秒,差距主体就是这 100 万行向量的读取与物化。问题解决了,但用户得改写 SQL,这里有个坑。
正在开发的下一步执行计划把检索和物化拆成三段。候选阶段:各 BE 在自己分到的桶上检索,不读用户列,只产出候选集。合并阶段:收齐全部候选,做全局 Top-K 与精排,产出一份待物化的行清单(数据文件加文件内行区间),清单按数据文件分组,并把命中行的行区间合并。物化阶段:按行清单只读命中行的用户列。
合并阶段收敛到一个节点是算法要求:精排要看到全局候选集才能算出正确的 Top-K,行清单的分组与区间合并也要看到全集才能做对。汇聚的候选集是 MB 级,全程没有 hash 或 range 重分布。
一次扫描和三段式的对比见图 6。
预期收益有三点:Top-K 越大,被丢弃的候选行越多,省下的宽列读取越多;用户手写的自关联由物化阶段取代,从执行计划中消失;两种形态由 FE 按代价模型自动选择,用户不用感知,也不用改 SQL。
生产实测:规模和口径
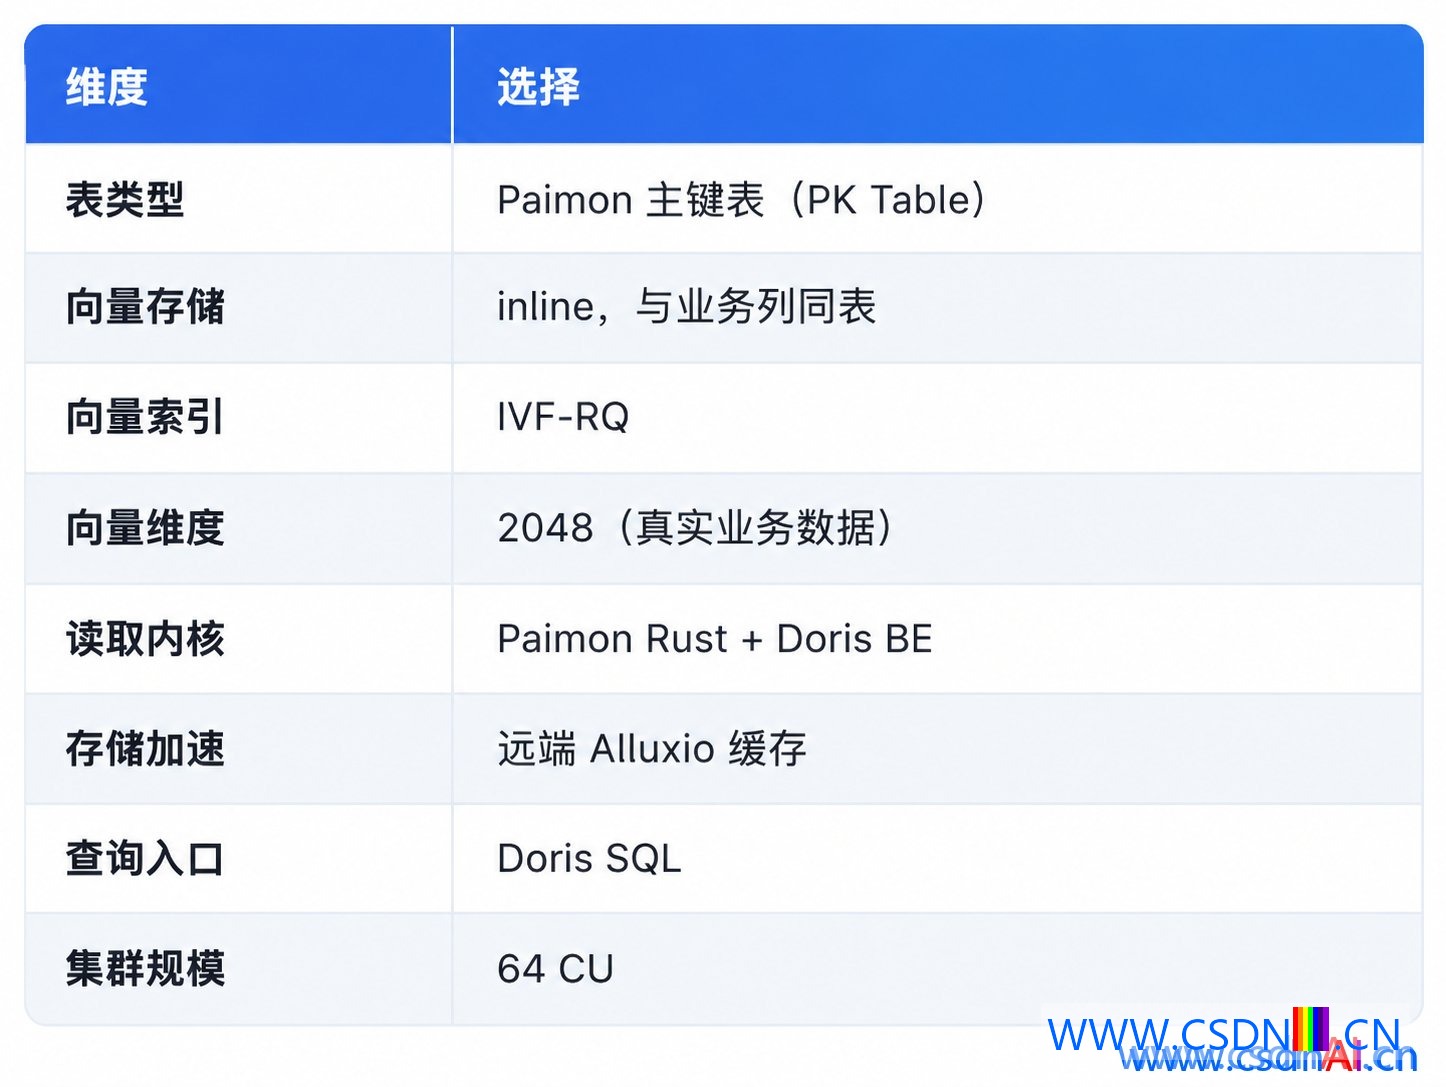
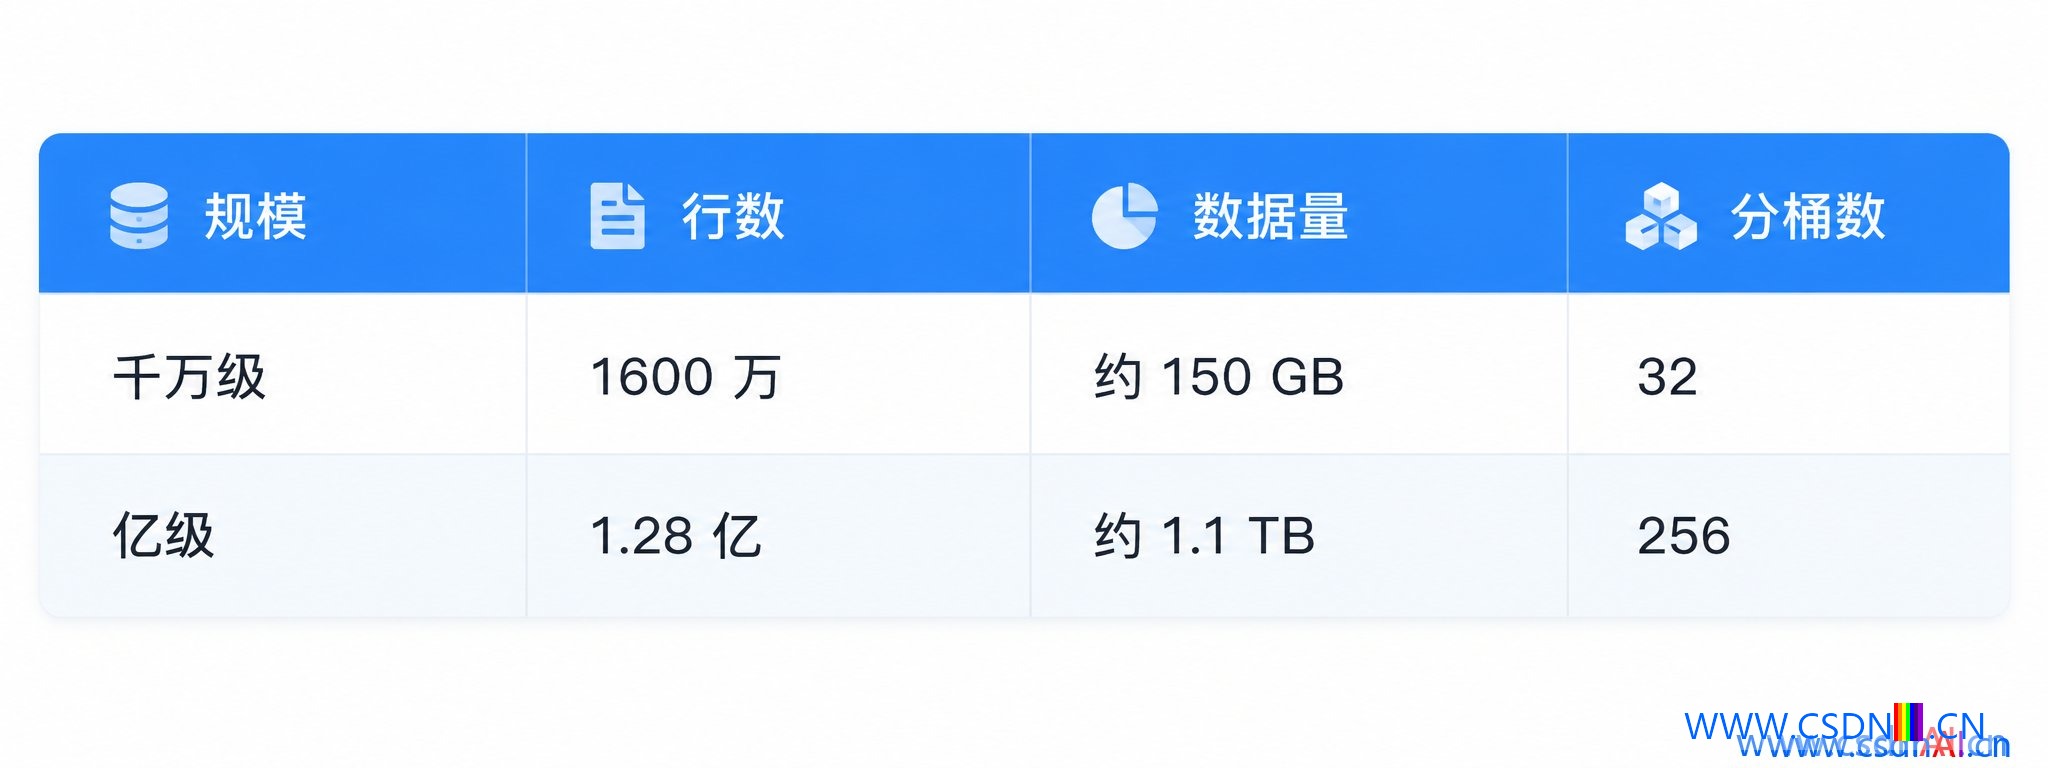
快手已在生产环境用 Doris 外表查询 Paimon 表上的向量索引。测试集规模覆盖千万到亿级。
两类查询分开测。一类只返回业务标识,由向量索引直接给出 Top-K:
select id
from vec_table
order by l2_distance_approximate(embedding, [...]) / 2048 维查询向量 /
limit <K>; -- K 取 100 / 1 万 / 100 万
这是典型的 Index-Only Scan 查询,主要反映召回本身的开销。
另一类把业务标识连同向量一起返回。当前形态下由用户改写成自关联,先用子查询取出 Top-K 的 id,再关联原表取回命中行的向量:
select t1.id, embedding
from (select id, embedding from vec_table) t1
join (
select id
from vec_table
order by l2_distance_approximate(embedding, [...]) / 2048 维查询向量 /
limit <K>
) t2 on t1.id = t2.id;
表中“返回业务标识 + 向量”一列用的就是这条自关联 SQL,主要反映向量列读取与物化的开销。第 2.4 节的三段式实现后,同样的查询可以直接写成:
select id, embedding
from vec_table
order by l2_distance_approximate(embedding, [...]) / 2048 维查询向量 /
limit <K>; -- K 取 100 / 1 万 / 100 万
届时自关联由物化阶段取代,语句与查询 Doris 内表一致。
结果怎么读
两列耗时都是端到端耗时。只返回业务标识的查询对应第 3.2 节第一条 SQL,连向量返回的查询对应自关联 SQL,表中是代表性单次查询结果。
两点结论值得记下来。索引检索对数据规模不敏感:行数从 1600 万增至 1.28 亿,只返回业务标识的耗时在三档 Top-K 下分别多 0.4 秒、0.2 秒和 0.1 秒。Top-K = 100 万时,瓶颈在向量列的结果物化,不在检索。
这组数据是单次代表性查询,不覆盖 QPS 维度。
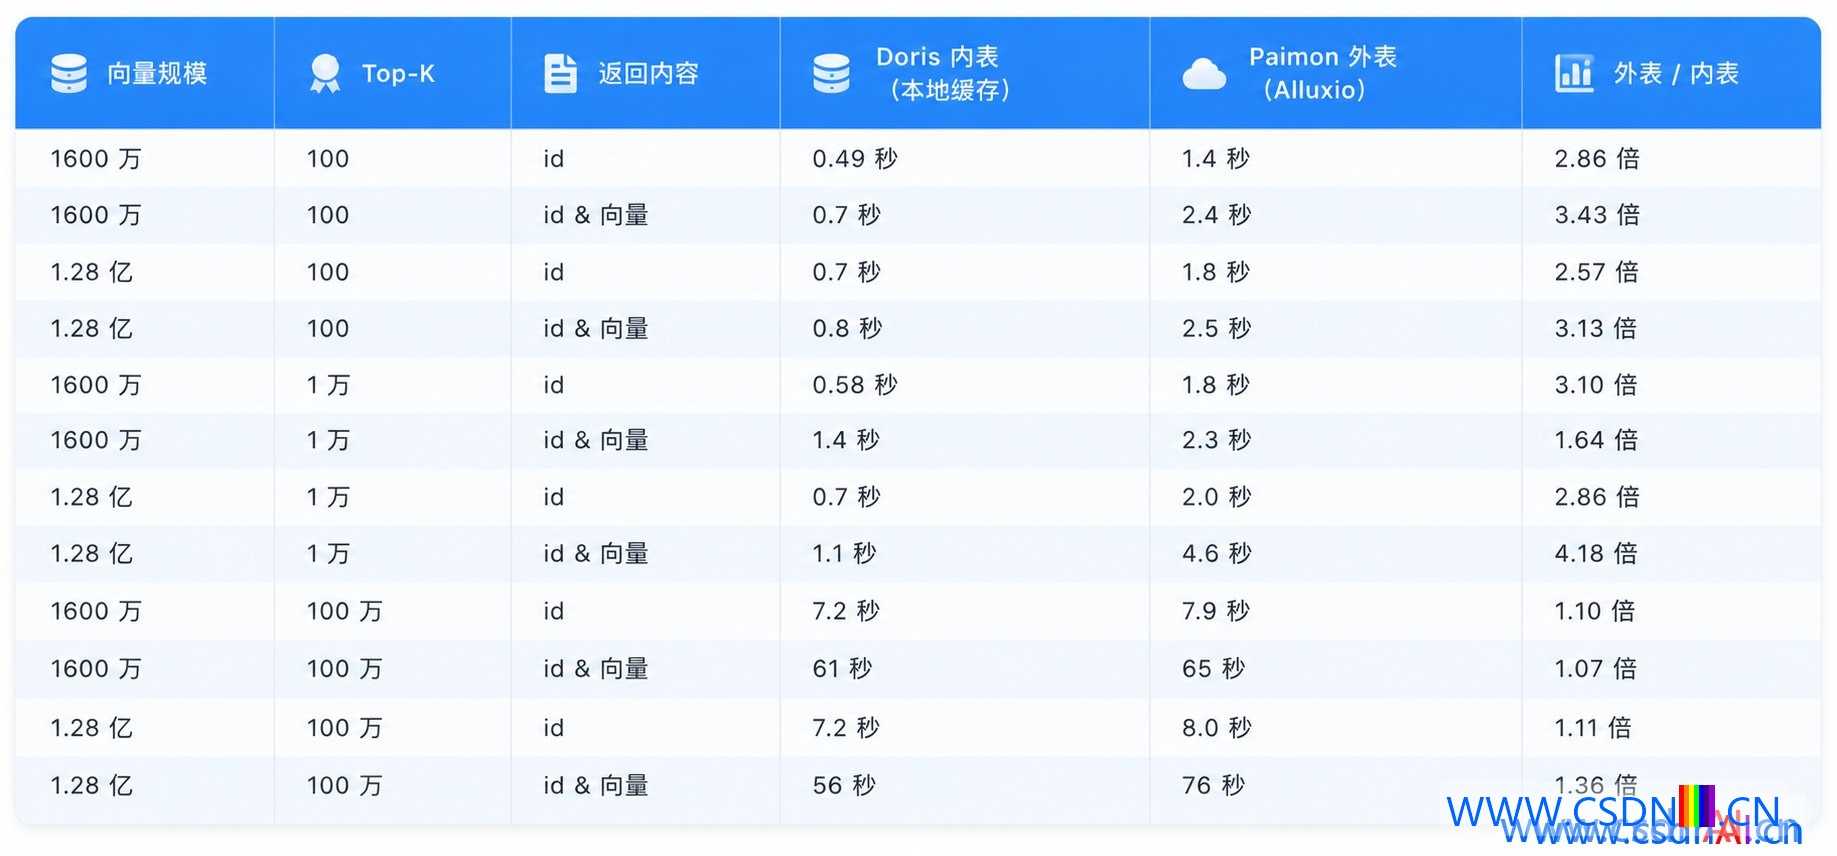
快手还做了 Paimon 表和 Doris 内表的对比测试:把同一批 Paimon 数据导进 Doris 内表,用 Doris 自己的向量索引查询。外表耗时为内表的 1.07~4.18 倍。只返回业务标识时,绝对差值只有 0.7~1.3 秒。Top-K = 100 万时差距收窄到 1.07~1.36 倍,此时耗时主体是回表物化,两侧读取的数据量相同,缓存位置的影响被摊薄。
两个规模下 Recall 为 96.0%~99.6%,只返回业务标识在 Top-K = 1 万以内不超过 2.0 秒。
内表性能确实更优,但看绝对值:只返回业务标识时多 0.7~1.3 秒延迟,换来的是数据从写入 Paimon 到可被检索的时效性提升、统一存储避免多副本冗余、省掉跨系统传输转换的计算开销,以及两套系统各自的权限治理。这笔账快手认为划算。
不适用与风险
这套方案不是万能的,几个边界要清楚。业务对召回延迟极度敏感、要求亚秒级且不接受任何额外开销的场景,内表或专用向量库更稳。写入后立刻要检索、不能等 compaction 的场景,L0 文件不在索引里,精确回退会拉高延迟。查询里带聚合或 JOIN、或者距离函数与索引度量方式不一致时,优化器规则不生效,会退回全量扫描,1 亿行以上要慎重。
运维上还有一点:Paimon Rust 用 native 内存,虽然纳入了 Doris 内存管控,但版本要和 Paimon 侧对齐,混用版本容易在索引读取上出问题。上线前建议用只返回 id 的 Index-Only Scan 查询做基准,确认召回率和延迟达标,再逐步放量。
社区共建与下一步
这条链路是快手、Apache Doris 社区和 Apache Paimon 社区一起推的。快手已在 Apache Paimon 和 Apache Paimon Rust 社区累计贡献 120 个以上 PR,Doris 侧的改动也会在未来两个月内合入 Doris 社区。
后续推进的方向包括:三段式延迟物化,让 Top-K = 100 万这类工作点不再为最终会被丢弃的候选行读宽列,用户也不用再手写自关联;索引的本地缓存,在调用进程内做本地磁盘与内存缓存,并由 Doris 配合做一致性哈希分发;全文检索与 Hybrid Search,全文检索路径已在 Paimon 侧完成,Doris 侧接入后,同一张湖表上可以组合结构化过滤、关键词匹配和语义召回;检索语义补齐,支持相似度范围检索(快手内部已开始灰度,计划经过大规模生产验证后贡献回社区),并让检索参数能按查询覆盖,而不只是表级配置。
Paimon、Iceberg、Lance 等多模湖仓能力已合入 Doris 4.2 发版分支,将随 4.2 版本于 9 月底正式发布。Apache Doris 为开源项目,其企业级版本与云上托管由商业化公司 SelectDB 提供,与开源版 100% 兼容。
