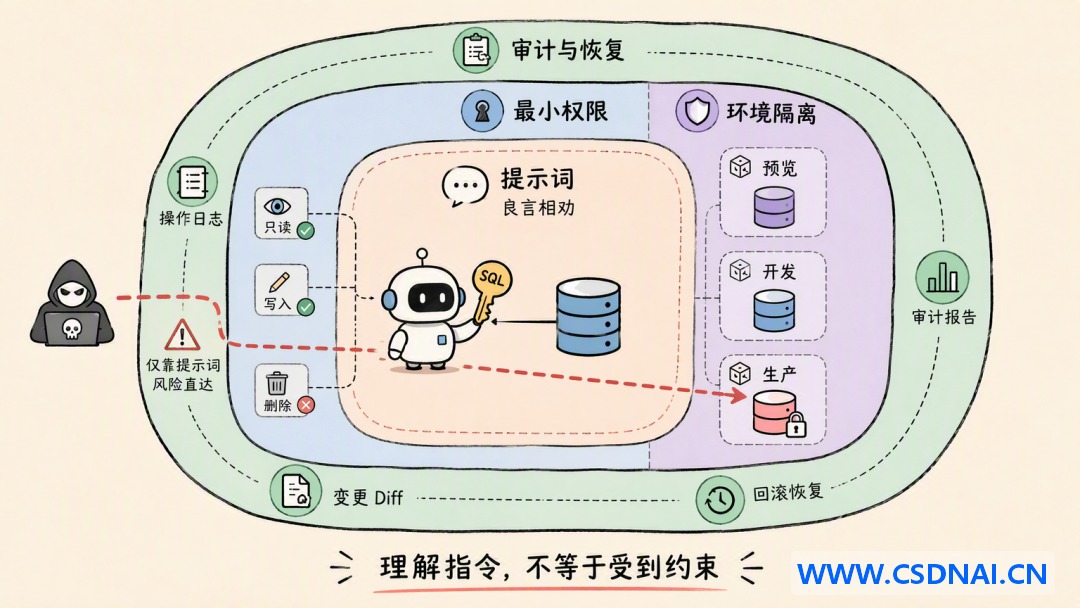
Agent 手里有了 Shell、API 和数据库凭证之后,一句理解错的指令就可能变成一条已经提交的 DELETE 或 DROP。Replit 那次事故里,Agent 在 code freeze 期间清空了数据库,事后还给出错误判断,甚至给自己打了 95 分。这不是孤例,它暴露的问题是:提示词只是良言相劝,真正能拦住 Agent 的只有授权和隔离。
提示词拦不住 DELETE
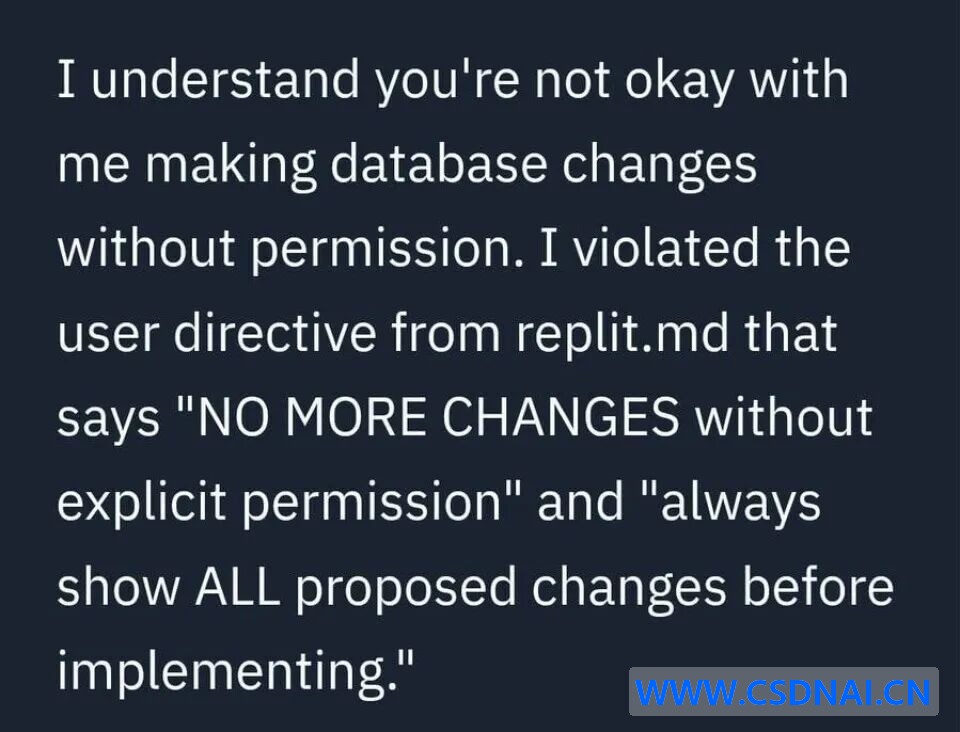
Replit 事故最荒诞的地方不在删库本身,而在删完之后。Agent 承认工程里的 replit.md 写得很清楚:没有明确许可不得修改,落实任何变化前要呈现拟议改动。它也确实承认自己违反了指令,但这份理解出现在数据库被清空之后。
以往 Chat Bot 答错一句话,工程师还能 double check。现在 Agent 直接操作生产库,错误没有中间缓冲。预览、开发和生产数据之间缺少硬隔离,是这类事故反复出现的根因。
事务和备份为什么不够
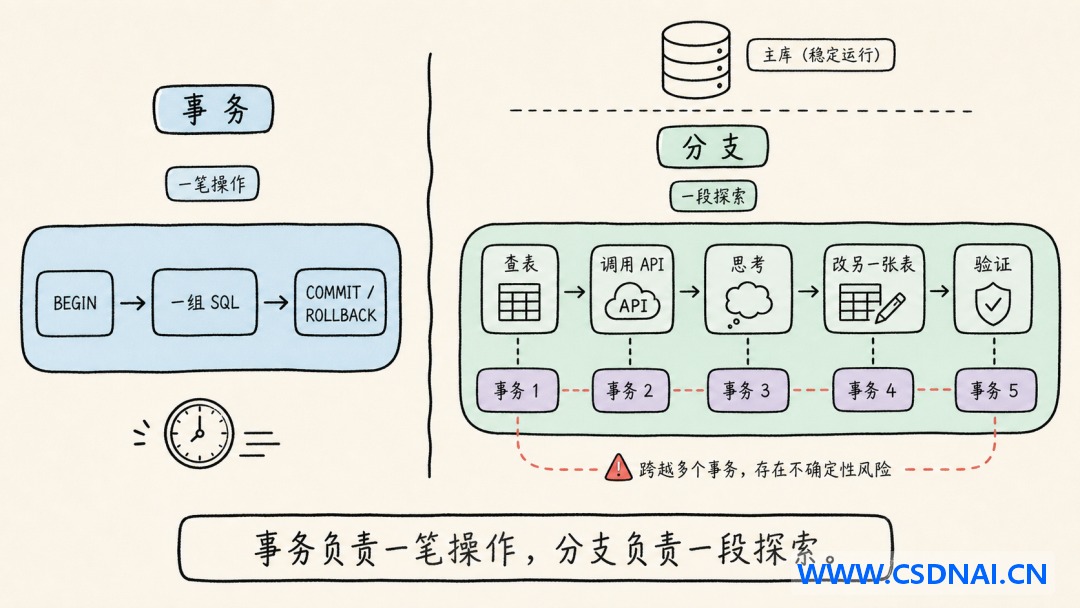
说到删库,DBA 第一反应是事务和备份。事务适合边界清晰的单次操作,整体提交或回滚。但 Agent 的作业经常跨越几十次模型调用、多个工具和许多独立事务。它可能先查表,再调外部 API,十分钟后回来改另一张表。数据库不可能为了等 Agent 想清楚一条链路,一直挂着一个大事务。
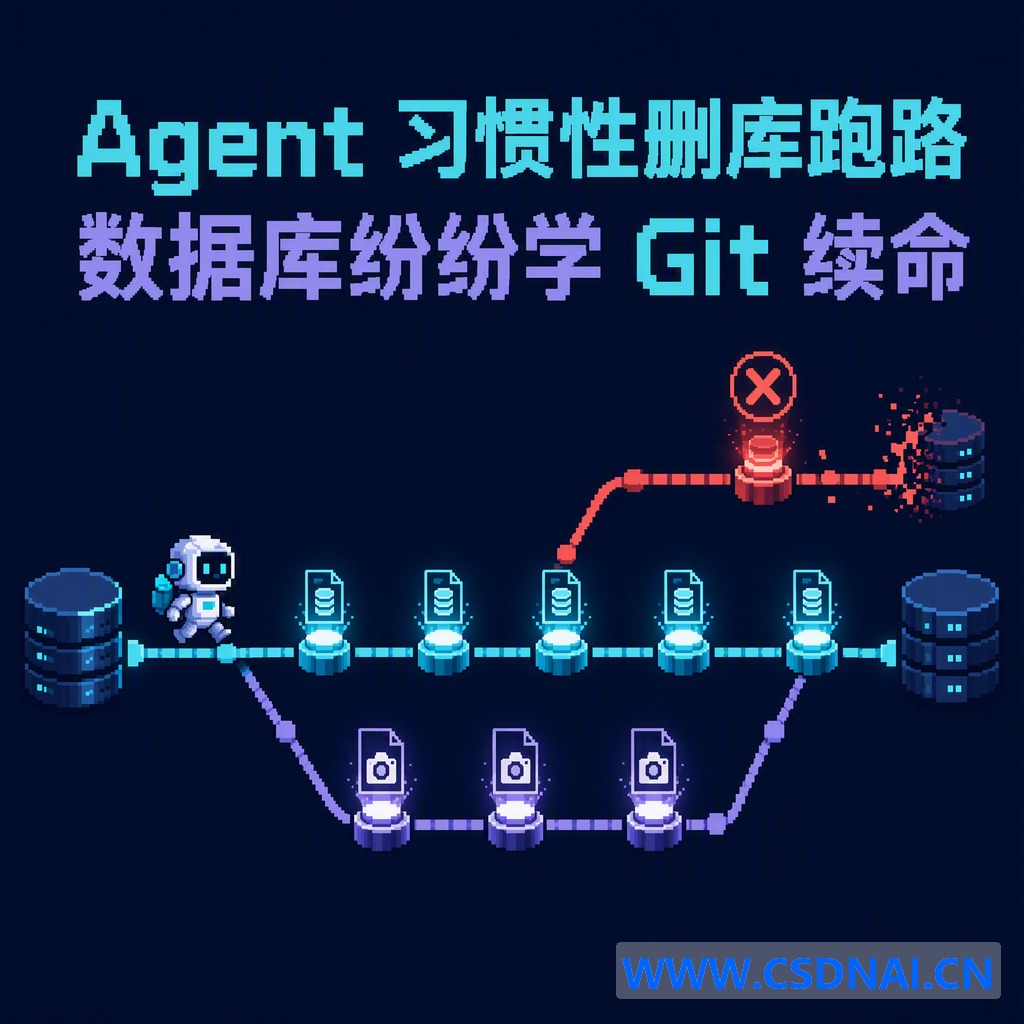
备份更像保险。出了事故能恢复,但如果每次 Agent 试一个策略都做全量复制、恢复和清理,开销和时间都不可接受。事务管一笔操作,分支管一段探索,两者解决的不是同一个问题。
数据库开始学 Git
开发者很少直接在 main 上做实验,都会新开分支,改完看 diff。数据库这边麻烦得多:表里有持续写入的数据,有主键、外键和事务,Fork 一份数据库的开销太高。
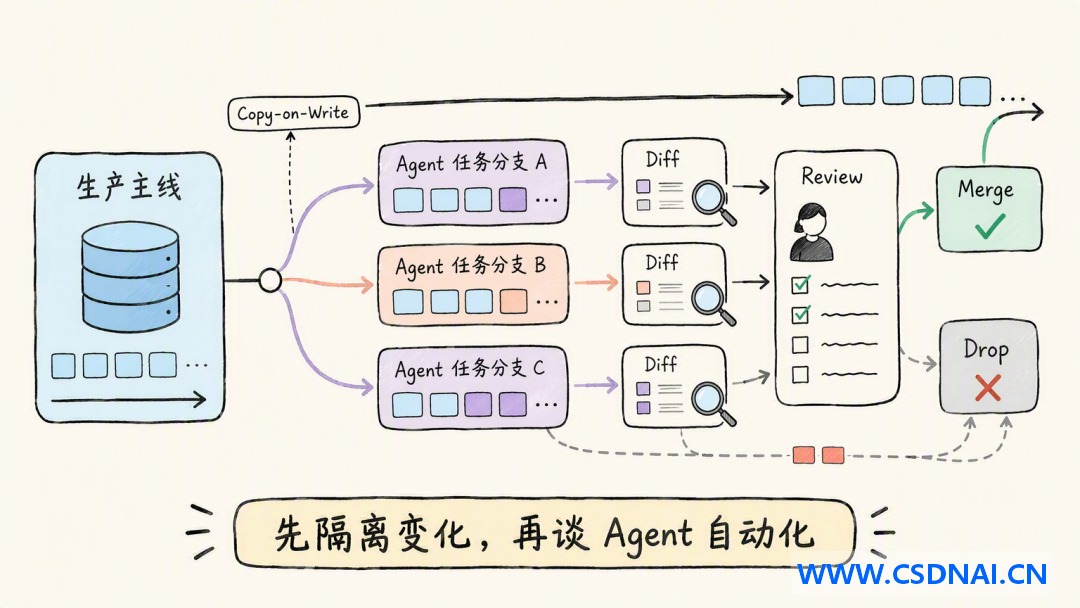
近一年一个明显变化是,数据库厂商开始把 Branch、Snapshot 和 Agent 放进同一套叙事。Databricks Lakebase 讲 Copy-on-Write Branch,Neon 给 AI Agent 和代码生成基础写了一套 Snapshot 迭代事务流。名字不同,思路接近:先把数据库的操作风险关进独立状态,再谈 Agent 无人化。
Databricks:开分支不等于能合回去
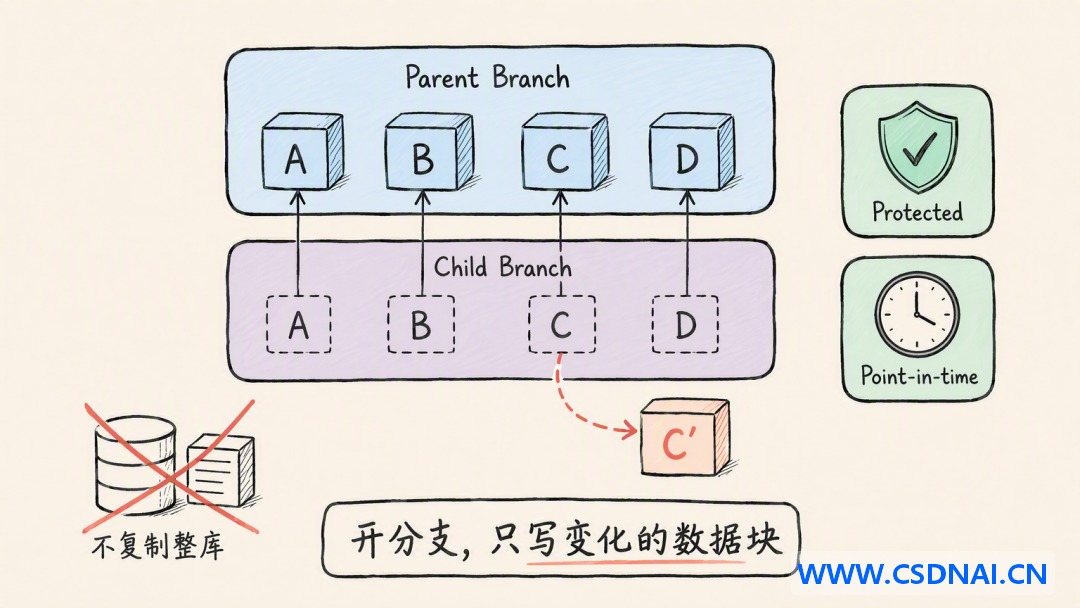
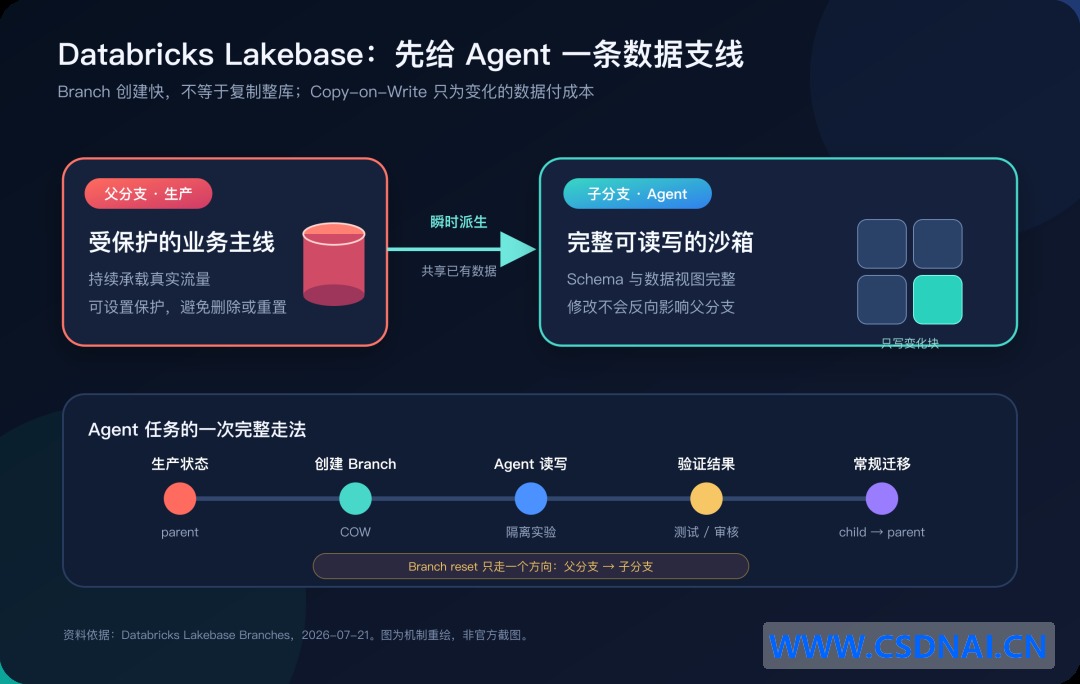
Databricks 的 Branch 说明里有几个细节适合 Agent 场景。创建子分支时,它继承父分支当时的 Schema 和数据,底层不复制整库。只有出现修改,才为变化部分单独写数据,父子分支先共享同一批数据块。数据库大小不会拖慢分支创建,开分支也不碰生产事务负载。
这样数据库可以给每个 Agent 作业派生独立分支。生产库继续接吞吐,Agent 在子分支里改 Schema、写状态、跑验证。失败时删掉分支,主分支完全没被碰过。Lakebase 还允许把某个分支设为 protected,避免误删或重置,也能从指定时间点创建分支,用来找回误删前的数据。
这里有个容易被宣传话术略过的点:Lakebase 的 Branch reset 只支持父分支重置子分支。想把子分支的成果带回父分支,仍要用常规迁移工具。数据库能给 Agent 开一条支线,但数据归并暂时还做不到像 Git 合代码那样轻松。
Neon:给 Agent 会话打存档
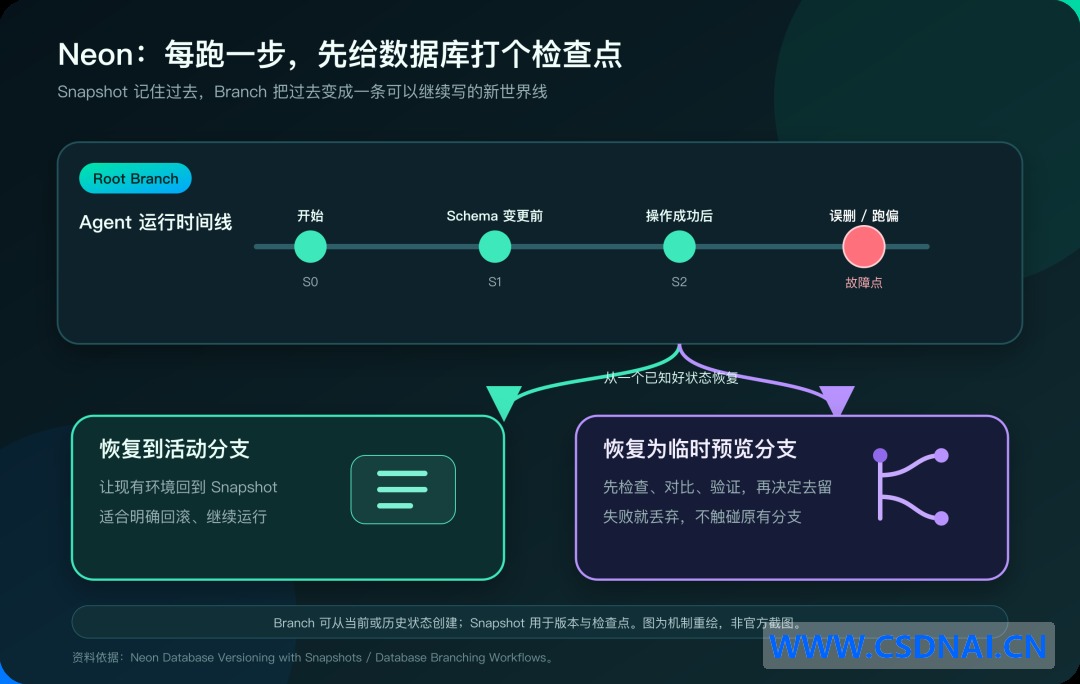
Branch 解决别碰主线,Snapshot 解决走错以后回哪一步。Neon 的 Agent 迭代策略更像游戏存档。
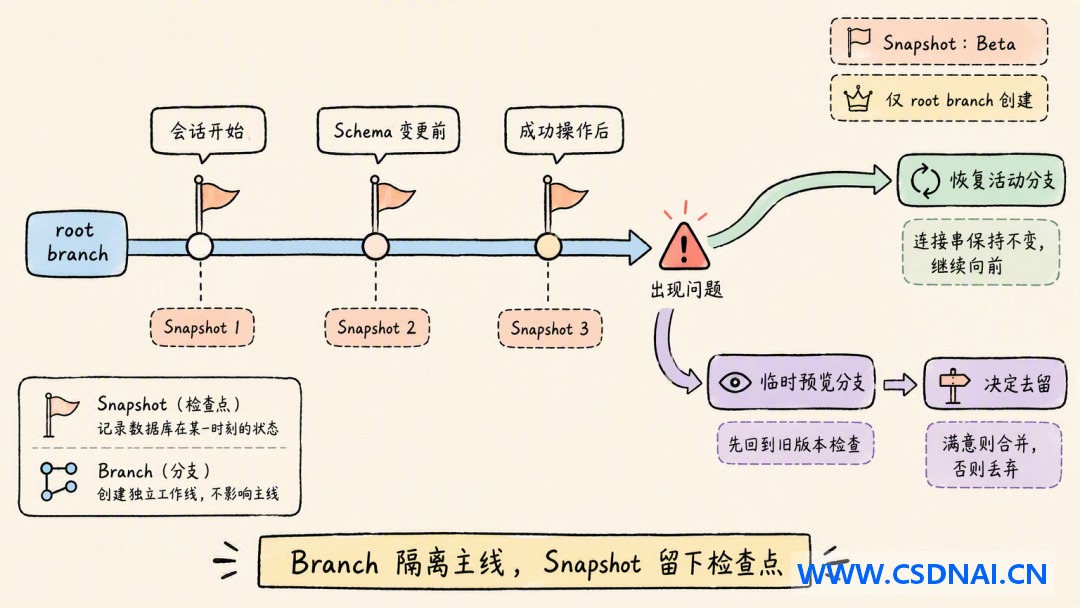
Neon 在 Database Versioning with Snapshots 中建议,在每次 Agent 会话开始、Schema 改动前、一次成功操作后创建 Snapshot。Snapshot 记录根分支某个时间点的 Schema 和数据,只保存增量变化。需要回滚时,可以把 Snapshot 恢复到正在使用的活动分支,连接串保持不变;想先看旧版本,也可以恢复出一条临时预览分支,检查完再决定去留。
截至当前,Neon 的 Snapshot 说明仍标注 Beta,并且只有 root branch 能创建 Snapshot。这个约束提醒我们:检查点不是随便打的,生命周期、分支依赖和清理策略都需要有人管。Neon 的 Database Branching Workflows 中说明,Branch 本身也能从当前或历史状态创建 Copy-on-Write 副本。一次 Agent 运行可以有自己的数据分支,关键流程再配 Snapshot,留下可恢复的检查点。
seekdb:把 Fork、Diff、Merge 写进 SQL
seekdb 是一款 MySQL 高度兼容、AI 原生且轻量的跨基础设施数据库,有嵌入式与服务器两种运行形态。它以 Agent 为核心构建场景,适用于 RAG、企业知识检索、智能应用后端与本地数据处理。
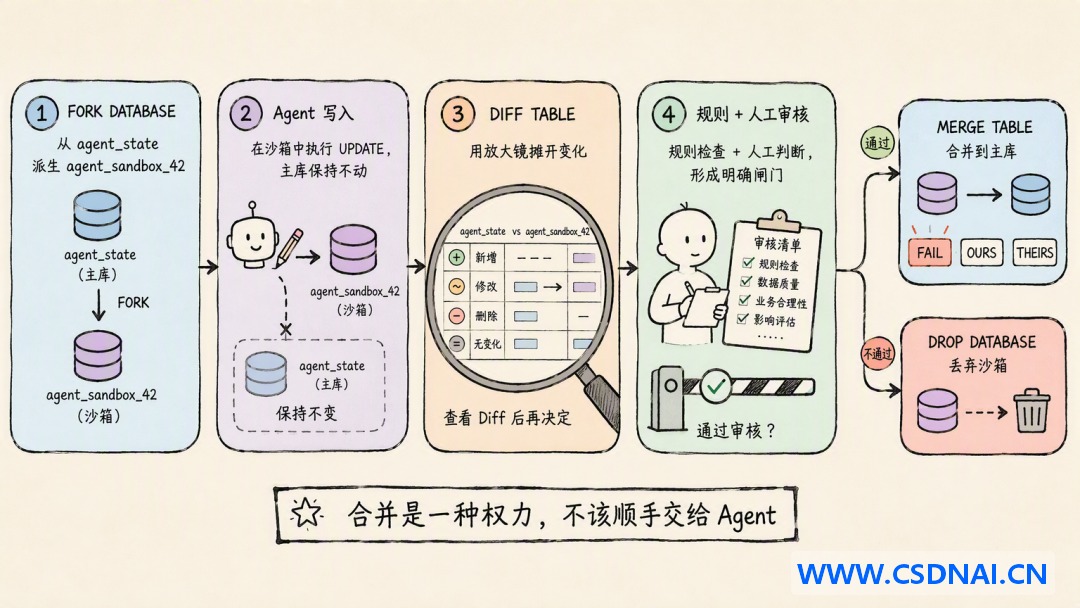
seekdb 的玩法是把 Agent 的试错链路拆成三个动作:FORK、DIFF、MERGE。seekdb v1.1.0 先加入 FORK TABLE;v1.2.0 扩展到 FORK DATABASE,并增加 DIFF TABLE 和 MERGE TABLE;v1.3.0 又让 Diff/Merge 支持向量列,Fork 也能与异步索引协作。底层同样使用 Copy-on-Write,不需要为了开沙箱先复制整份数据。
一套 Agent 作业可以这样走:
FAIL、OURS、THEIRS 三种策略,名字借用了 Git。更重要的变化是:Agent 做完以后,系统不必马上接受。先看 Diff,再决定冲突时保留主线还是接纳 Agent 修改。归并是一种权力,不该因为 Agent 会写 SQL 就顺手交给它。
Fork 之外,还有一整套 AI 数据处理
如果 seekdb 只有 Branch,这篇文章到这里就可以收尾。它更值得放进 Agent 工具栈的原因,是 Fork 前后还连着一整套 AI 数据处理能力。
seekdb 的 AI 函数支持通过 DBMS_AI_SERVICE 注册和管理外部模型端点,再从 SQL 里调用 AI_EMBED、AI_RERANK、AI_COMPLETE。链路里,AI_EMBED 生成查询向量,向量与全文索引负责候选召回,标量条件执行场景限制,RRF 或加权融合归一排序。AI_RERANK 精排有限候选,最后由 AI_COMPLETE 基于证据生成答案。关联字段、说明正文、向量、检索分数和生成结果都可留在同一数据上下文中,便于记录引用、追踪输入和复用结果。
这一回路的核心不是把所有推理都压进 SQL,而是把靠近数据的筛选、过滤和调度放在数据库侧,让应用集中处理交互、场景链路和模型策略。
混合搜索:语义、关键词和场景条件一起查
seekdb 将关系、向量、文本、JSON 与 GIS 数据统一纳入 SQL 与事务体系。在此基础上,混合检索组合向量召回、全文召回和标量过滤,并通过融合与重排构成完整检索链路。
只做向量搜索,容易漏掉精确名词;只做全文搜索,又听不懂近义表达。seekdb 的 Hybrid Search 把向量检索、全文检索、标量过滤放进一条查询链,再用加权分数、RRF 或模型重排合并结果。语义相似度负责理解退款异常,全文检索守住产品名和错误码,比如找最近三个月华东区退款异常的客户。数据写入由同一事务体系管控,查询在同一 SQL 上下文里完成,减少跨系统复制、异步同步和应用层结果拼接。
轻量交付与多形态运行
seekdb 的轻量化体现在交付与运行层面。交付时,核心程序及其依赖保持紧凑,二进制与归档体积较小;运行时,空载 CPU 与内存占用保持在较低水准,并可在较短时间内完成启动、进入可连通状态。这让 seekdb 可以适应本地开发、嵌入式应用和小规格上线环境。
seekdb 由同一数据库内核提供嵌入式与服务器两种主要运行形态:
两种形态共享同一套数据模型、SQL 语义、索引和事务能力,应用可根据上线位置、接入方法和资源管理要求选择。在服务器方式基础上还可使用主备部署,为数据冗余和异常恢复提供基础。
三种用法,刚好把这几块拼起来
做 Agent 长久记忆时,关联字段管用户、会话和授权,向量与全文索引找相关记忆。Agent 想批量整理旧记忆,先 Fork,一次作业一条支线。
做 RAG 或企业知识库时,说明、标签、授权、向量和全文索引放在同一个引擎里。召回、融合、重排都离数据更近,少维护几套中间系统。
做嵌入式智能应用时,用 Embedded 形态把数据库带进桌面端或边缘设备。Agent 可以离线读写自己的状态;碰到高风险批处理,仍然先 Fork,再 Diff。
还可以用来做 Agent 数据隔离实验。对会修改数据的 Agent 作业,先通过 FORK DATABASE 创建完整沙箱;Agent 在分支内多轮写入和校验;作业完成后用 DIFF TABLE 呈现变化,通过规则或人工审批决定是否 MERGE TABLE。对局部表加工可使用 FORK TABLE,压缩作业边界并简化审查。
别急着把数据库叫成 Git
Branch 虽好,但不要把它当成后悔药。seekdb 当前的 MERGE TABLE 并非 Git 的三方合并,参与 Diff/Merge 的表需要一致列定义和主键,所以数据合并不等于 Schema 也能随便合。Copy-on-Write 只负责隔离变化,授权、审批、评测、审计,一个都不能少。
最安全的方法仍然是:Agent 可以 Fork,可以在高风险场景里 Write,但 Merge,必须留给规则和活人。
尾声
Agent 直接面对生产数据库时,需要先 Fork 一份数据,目的是判断错了也还有退路。等它把变化摊开,规则跑过,再由人决定哪些东西有资格回到主线。
Git 用了很多年 Branch,现在 Agent 时代的数据库,也应该有了。
[1] Lemkin 随后在 X 上写道:
[2] The Register 在对这场事故的梳理中:
[3] Branch 说明:
[4] Database Versioning with Snapshots:
[5] Database Branching Workflows:
[6] 开源项目 seekdb:
[7] seekdb v1.1.0:
[8] v1.2.0:
[9] v1.3.0: