数据湖这几年被反复定义,但工程上真正要回答的问题只有一个:这套系统能不能同时接住结构化报表和半结构化数据,并且不让成本失控。LLM 把后者的处理门槛打下来之后,数据湖的边界被重新划了一遍。
两个系统、三个标准,先把概念钉死
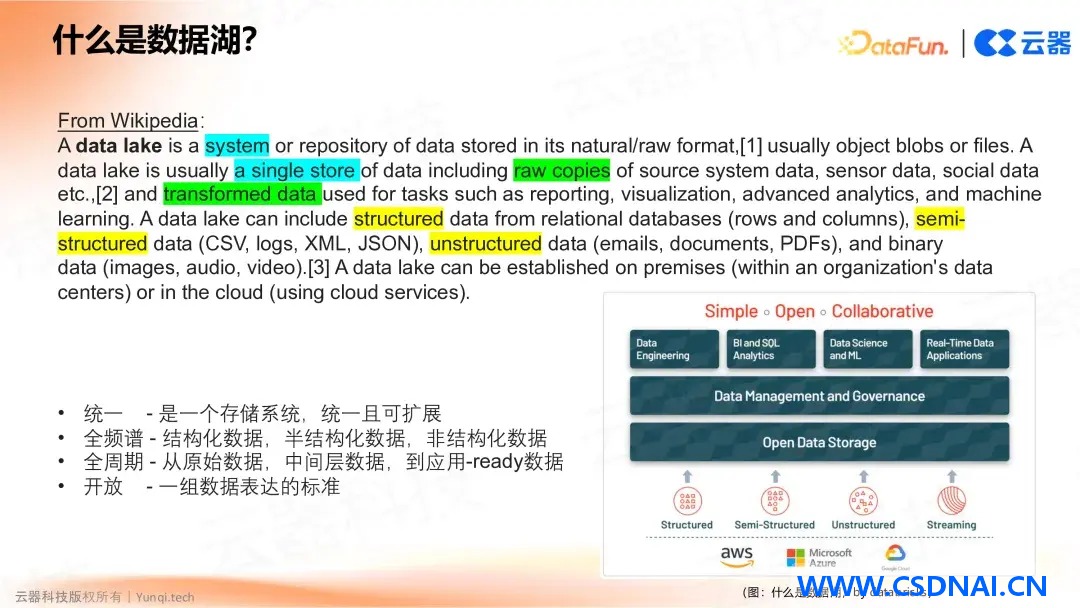
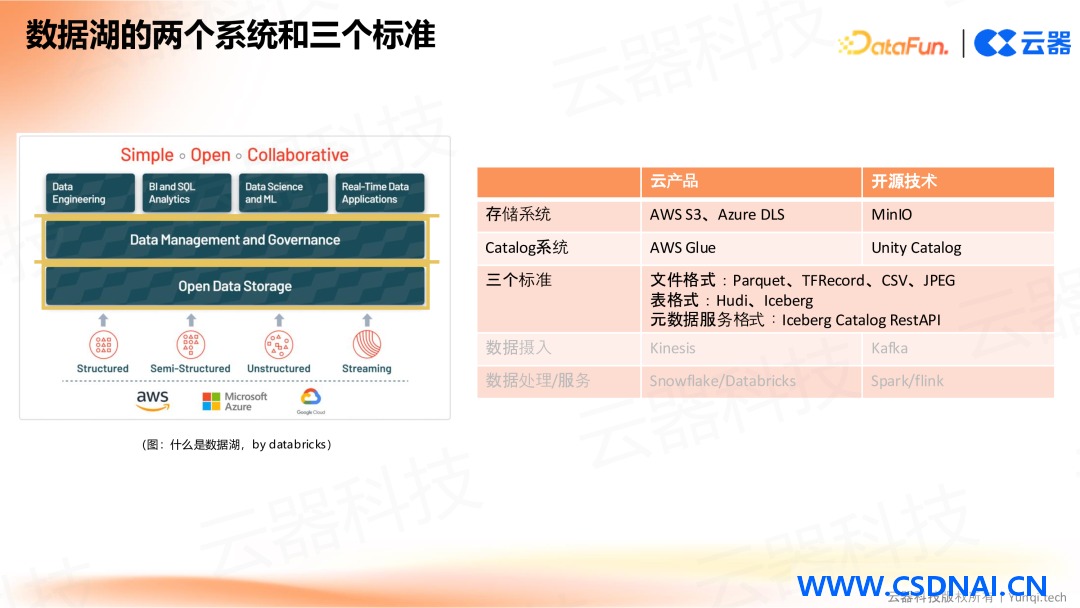
数据湖不是某个引擎,而是一套统一且可扩展的数据底层,覆盖采集到输出的全链路,能装结构化、半结构化乃至非结构化数据,且不绑定特定计算引擎。Databricks 用简单、开放、协作概括它,这个说法在工程上站得住。
拆开看,它由两个系统构成:存储系统(云对象存储或开源分布式存储)和 Catalog 系统(管理数据定义、结构、来源等元数据)。支撑它们的是三类标准:文件格式(Parquet、CSV、JPEG 等)、表格式(Hudi、Iceberg、Paimon、Delta Lake)和元数据服务格式(如 Iceberg REST API)。
驱动力换挡:从互联网数据爆炸到 AI 解锁暗数据
上世纪七十年代的数据库理论打了地基,2000 年后互联网流量把传统数据库压垮,谷歌的 GFS 与 MapReduce 撑起了第一代数据湖的技术骨架。早期数据湖靠海量存储、易扩展、低成本起量,代价是性能和实时性拉胯。
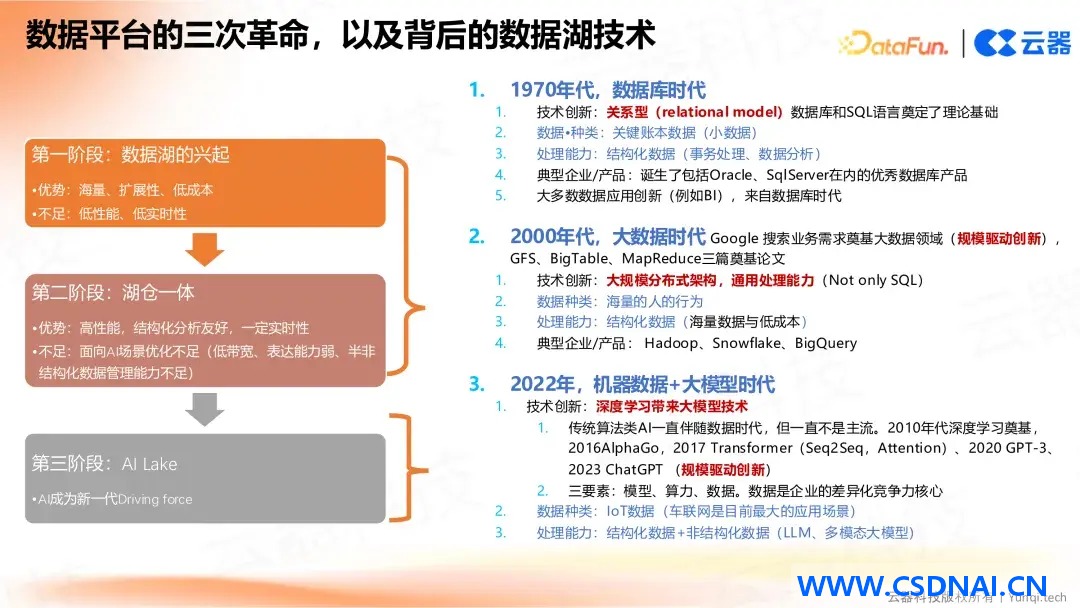
近五年湖仓一体成为事实标准,把数仓的高性能分析能力叠到湖上,实时性问题缓解了大半。但面向 AI 场景仍有硬伤:带宽不足、以结构化数据为主。真正的变量是 AI 带来的半非结构化数据处理能力,数据规模存在十倍的扩展空间,沉淀在湖里的暗数据第一次有了被点亮的路径。
存储层:对象存储上位,HDFS 退场的实操代价
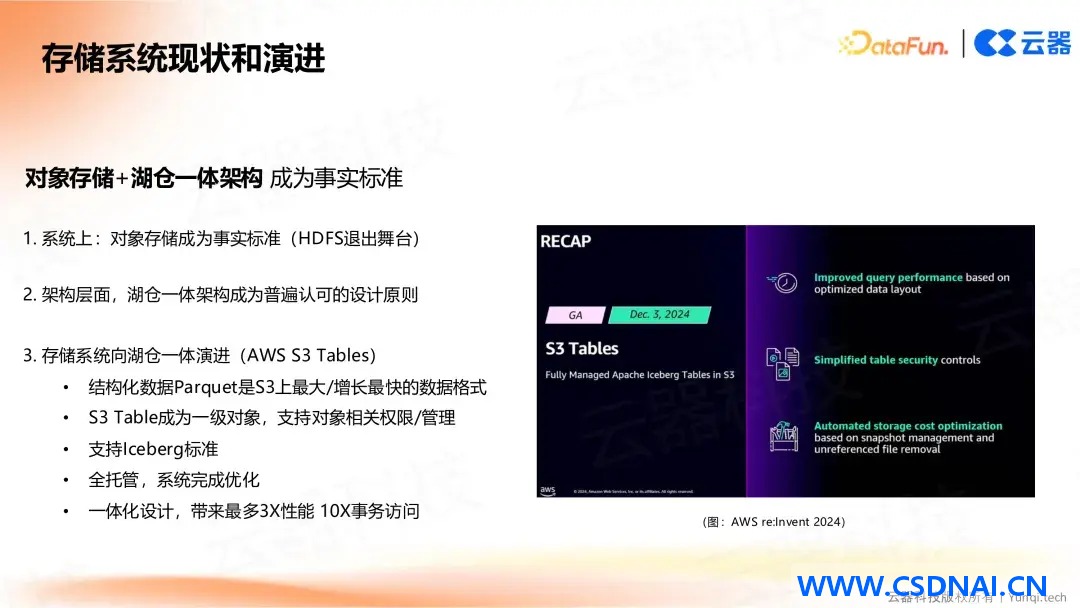
格局已经很清楚:HDFS 逐步退出主流,新建平台基本都架在云对象存储上。对象存储还在向上生长,AWS S3 引入 table 概念,支持 Iceberg 标准并做全托管,自动处理压缩、授权、小文件合并,性能和事务处理效率都有数量级提升。
迁移这件事不能只看趋势。HDFS 的 rename 是原子操作,对象存储的 rename 本质是 copy 加 delete,大批量分区重写时会出现明显的延迟尖峰;list 操作在深层目录下也远慢于 HDFS。典型报错是作业在 commit 阶段超时或出现 FileNotFoundException,根因多为元数据最终一致性窗口内并发读写冲突。规避手段是改用 Iceberg 或 Hudi 的提交协议接管文件生命周期,避免业务代码直接操作底层路径,同时把分区数控制在合理量级。
表格式:Iceberg 领跑,Paimon 在流场景卡位
文件格式层面 Parquet 已是结构化数据的事实标准,新兴数据大多以它为存储载体。表格式则是多强并立:海外 Iceberg 认可度最高,Snowflake、AWS 全面采用;国内 Paimon 与 Flink 深度绑定,流批一体场景优势明显;Hudi 擅长增量更新与快速删改,适合高实时性写入;Delta Lake 主打 ACID 事务可靠性。
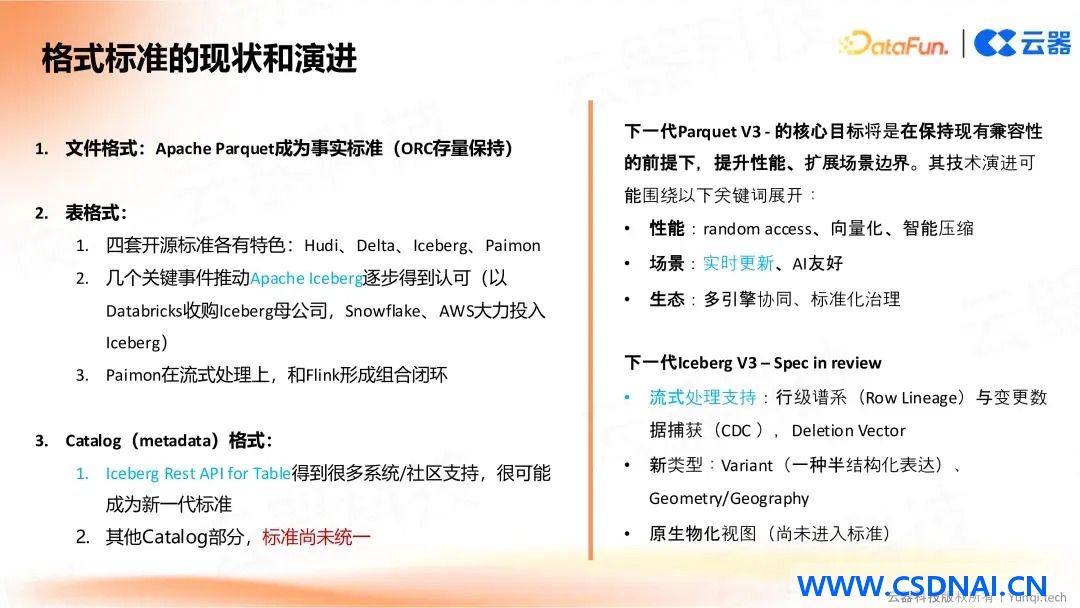
四个项目都在快速迭代,长期看互操作性会被社区推着往前走,但数据格式兼容、接口统一、性能优化这些坎短期内绕不过去。
Iceberg V3 的推进值得单独盯。行级血缘追踪、CDC、Delete Vector 优化是核心卖点,实现验证可以直接查快照元数据:
spark-sql -e "SELECT snapshot_id, summary FROM db.tbl.snapshots ORDER BY committed_at DESC LIMIT 5"
判定标准看两点:summary 中是否出现 deleted-records 统计,以及删除后查询是否走 position delete 而非全文件重写。若删除操作仍触发整分区重写,说明引擎侧尚未启用 V3 的 Delete Vector 路径,升级收益要重新评估。
Catalog:战国时代,观望也要有兜底
Hive Metastore 的三个老问题没变:只认结构化数据、缺权限血缘治理能力、容易把整套老旧体系拖进来。替代方案分两派。独立服务模式以 API 收集元数据入库,用图结构表达血缘,提供点查、搜索、治理计算,属于组装式架构;Big Meta 模式把元数据抽象成结构化存储,交给现有引擎直接处理,架构更统一。
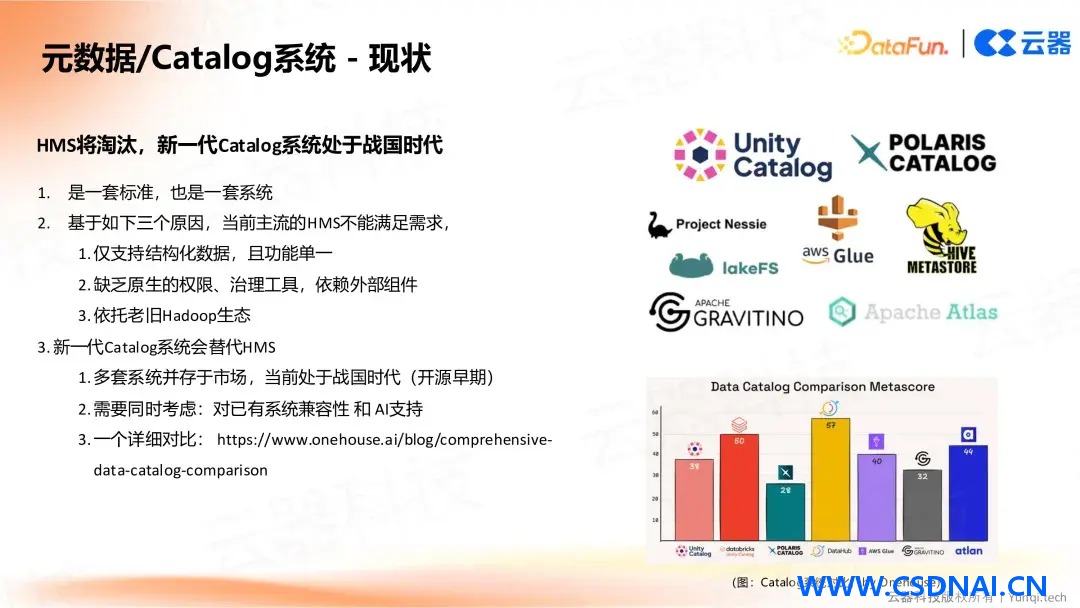
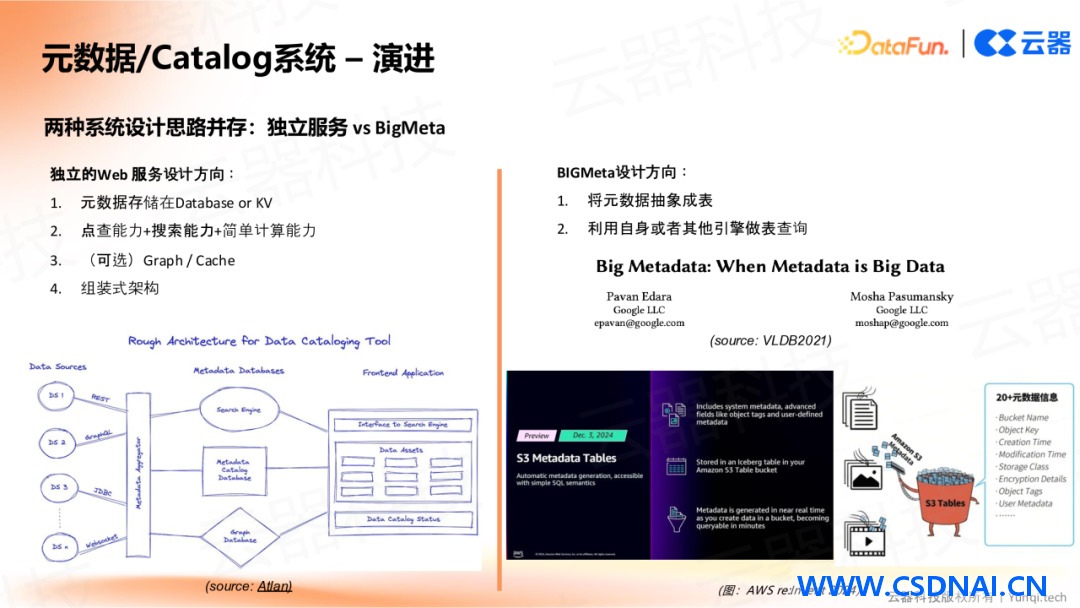
选型上有个容易忽略的边界:独立服务模式在跨引擎高频并发访问时,元数据层的锁竞争会放大延迟,多引擎混跑的团队尤其明显。观望期的兜底做法是保留 HMS 作为兼容层,新 Catalog 通过 REST 接口对接,避免一次性切断存量链路。云厂商倾向 Big Meta,开源侧多为独立服务,两种思路大概率长期并存,服务不同场景。
AI 改写数据消费:从查询到召回
AI 之前,数据平台靠关系代数处理结构化数据,SQL 加 Parquet 打天下。AI 的价值在于突破类型限制,聊天记录、图像、视频这类过去的暗数据,经模型处理后能提取出关键信息,原本孤立的数据类型被拉进同一套处理链路。
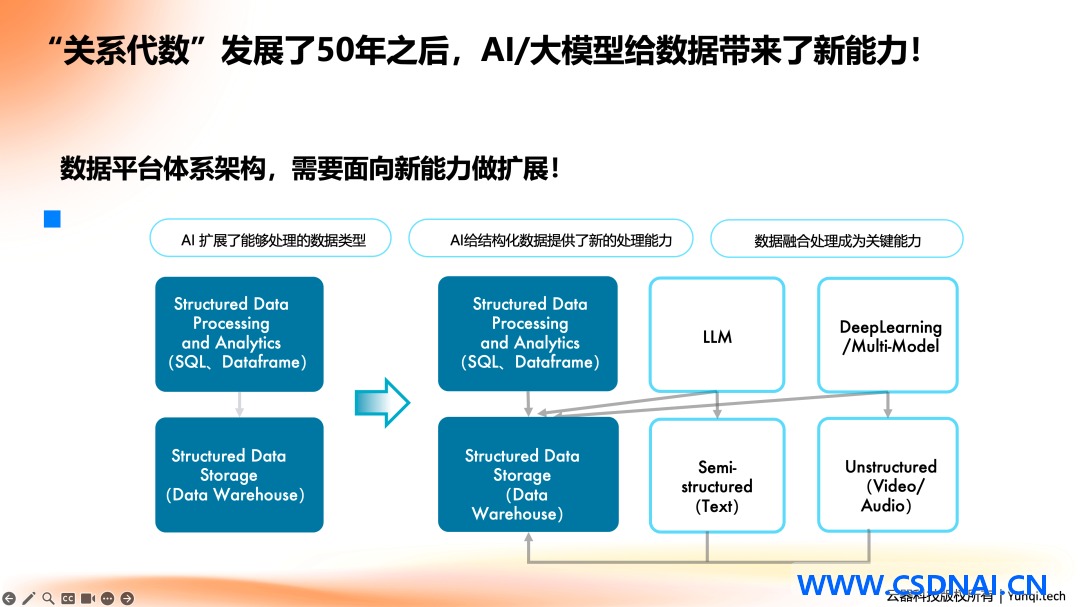
DIKW 模型被重新激活。传统路径是原始数据经 ETL 出报表,少量进搜推系统,利用深度有限。AI 介入后,原始数据进引擎可做知识问答和语义搜索,报表支持归因建模,多智能体系统能基于基础数据完成综合财务分析。数据消费越来越依赖 AI 引擎做结构化与半结构化的联合分析。
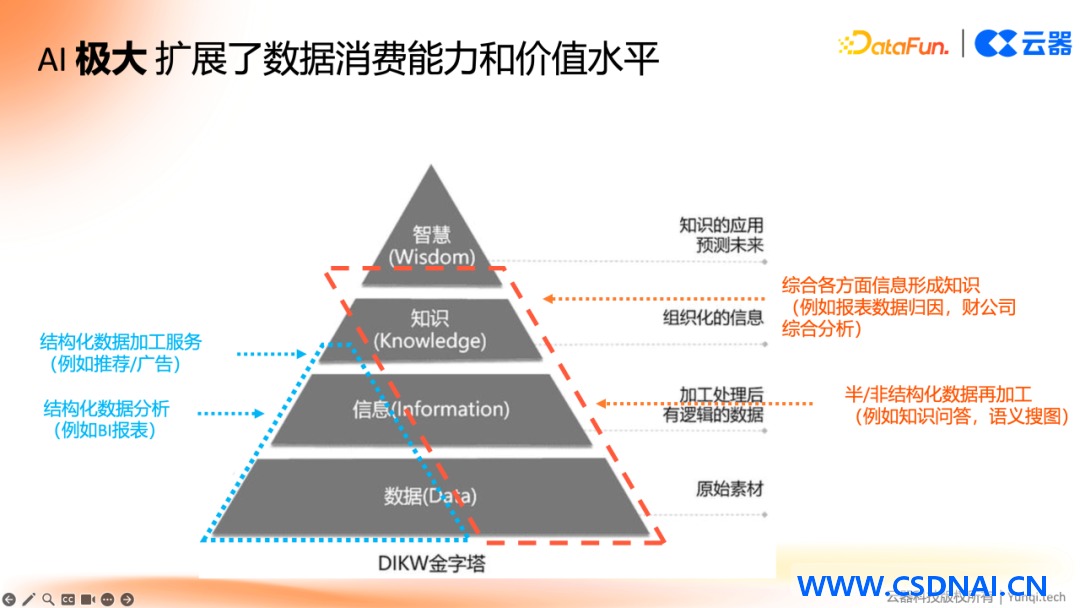
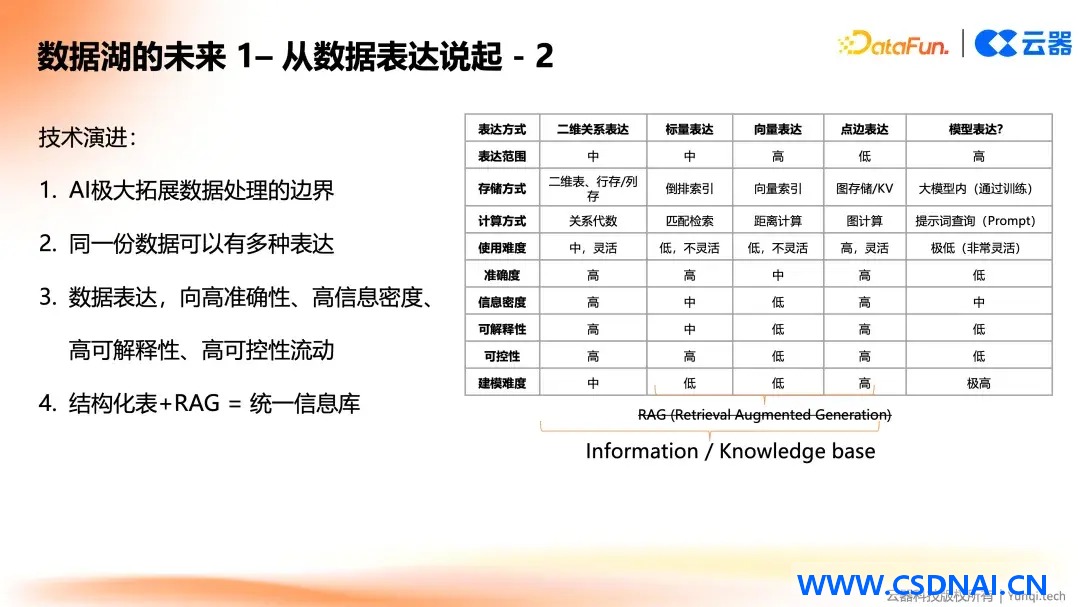
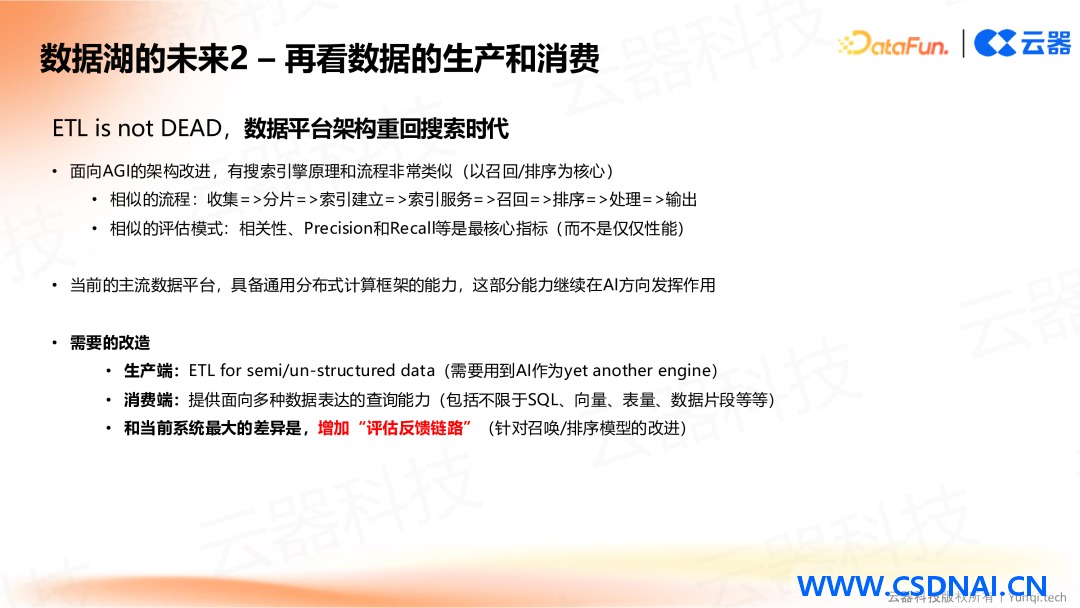
同一份数据可以有五种表达:二维关系、标量倒排索引、向量、点边图结构、融入模型。目标是整合成统一知识库,兼顾准确性、信息密度和可解释性。
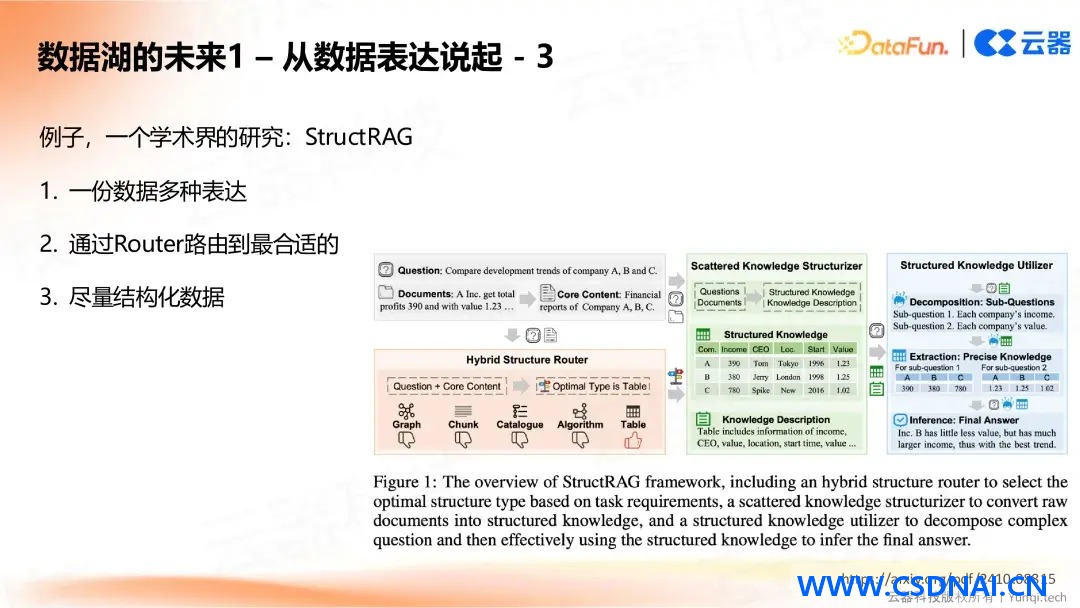
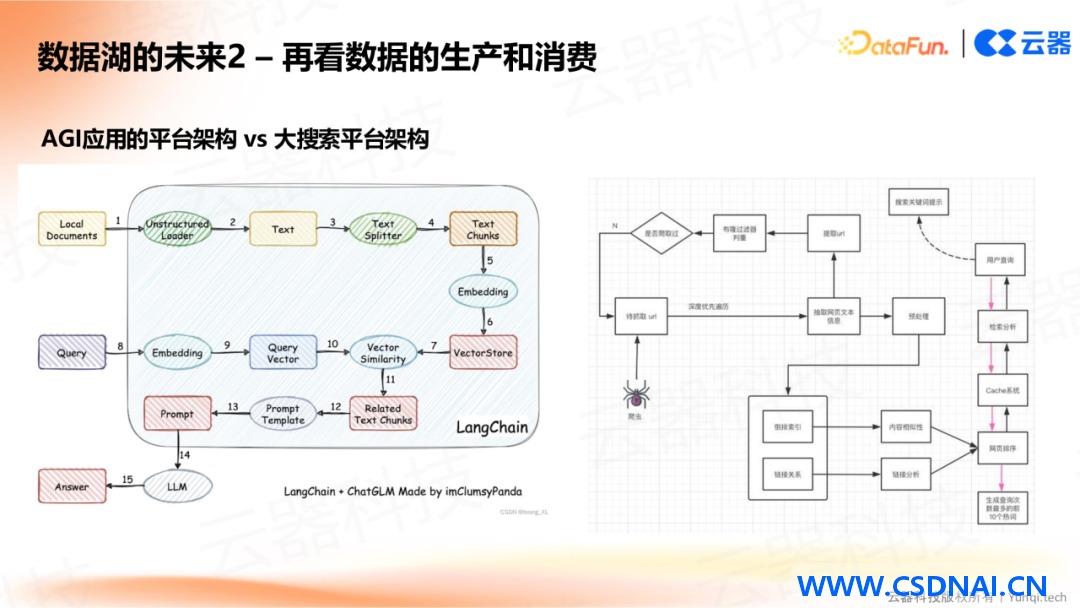
系统架构随之从主动查询转向召回驱动。生产端做 ETL 与语义处理,引入 AI 引擎写入对应存储;消费端支持多表达查询,系统自动召回数据供大模型分析,再通过评估反馈优化排序。这套流程和搜索引擎同构:预处理、召回匹配、结果生成。
面向 AI 的存储与标准:专用化与通用化的拉扯
AI 催生了一批专用存储,海外 Vast Data、国内 3FS 这类系统聚焦大模型需求,支持预训练数据拆分、推理阶段 KV 存储,用 Disaggregated 架构加 RDMA 换高吞吐,牺牲通用性。3FS 提供 Fuse 与原生接口,原生接口性能更优。
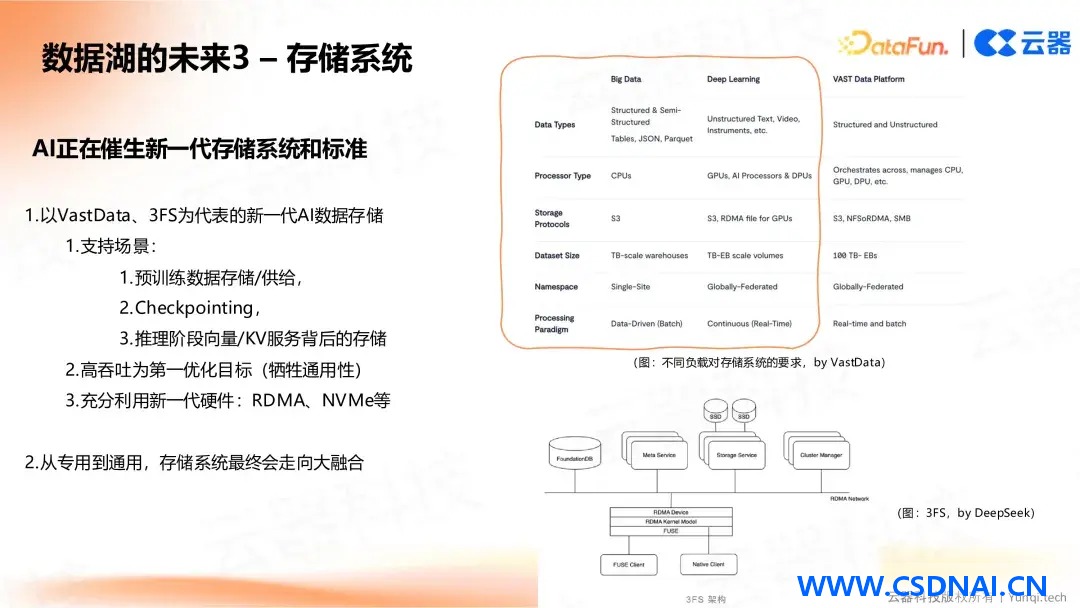
多数企业不必自建 AI 存储。云对象存储正在补 RDMA 能力和带宽,一两年内大概率能覆盖大部分训练与推理场景,届时按需选 SSD 或低成本层即可。标准层面,Parquet V3 和 Iceberg V3 都在向 AI 与实时场景靠拢,随机访问、智能压缩、半非结构化处理是共同方向。
云器 Lakehouse 的工程取舍
云器把存储抽象成统一 Volume,按类型和权限划分独立空间,做细粒度授权与隔离。AI 能力封装进数据流水线,增量文档分析像结构化 ETL 一样跑,处理结果自动落库。向量索引、标量索引、表数据被整合进统一知识库,支持多模态直接读取。反馈链路把用户对召回效果的评估反向喂给排序模块和模型输出,形成持续迭代。
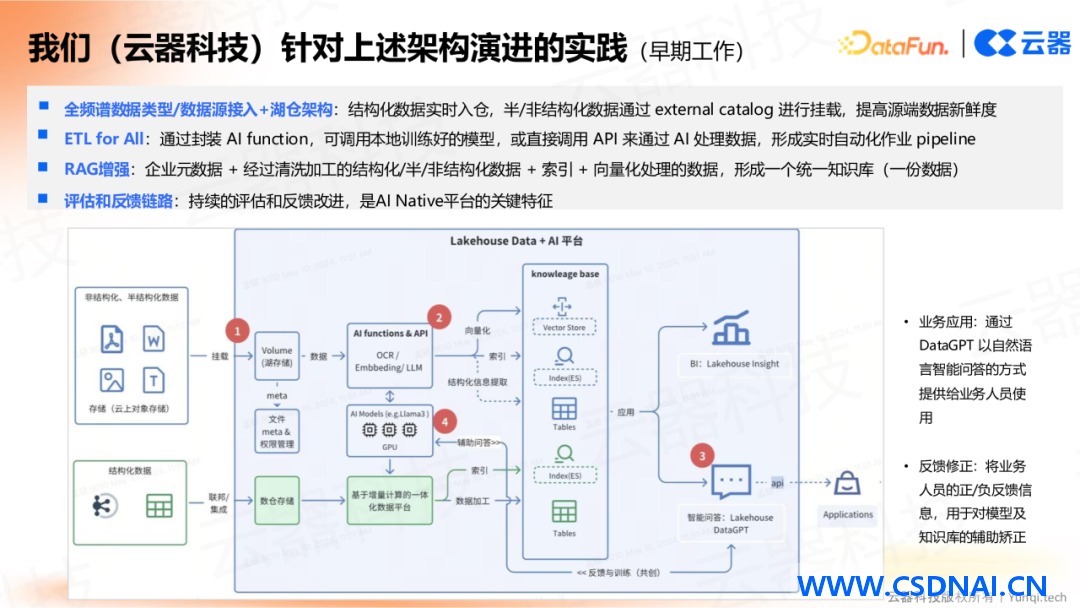
元数据系统正向 Big Meta 模式演进。实践中百 TB 以上数据量的元数据计算可能耗时三十秒,这是推动架构调整的直接原因。至于 3FS 这类系统与数据湖的整合,短期看仍是专款专用,融合产品已经出现,但通用数据平台接入专用存储的时机,取决于云厂商的节奏,不必抢跑。
ID:6590
