作者:vivo IT 手段小组- Liu Heng
直面牵扯存量代码改动的诉求,难点不在于编码,而在于怎样安全、精确地修改。本文通过搭建一个由1个调度器和多个单职责Skill构成的AI协同流水线,将左右拆解、规范沉淀、埋点和回归检查等隐性事务链路化,保证在实现功能的并且,对存量代码实现最小侵入式改造。
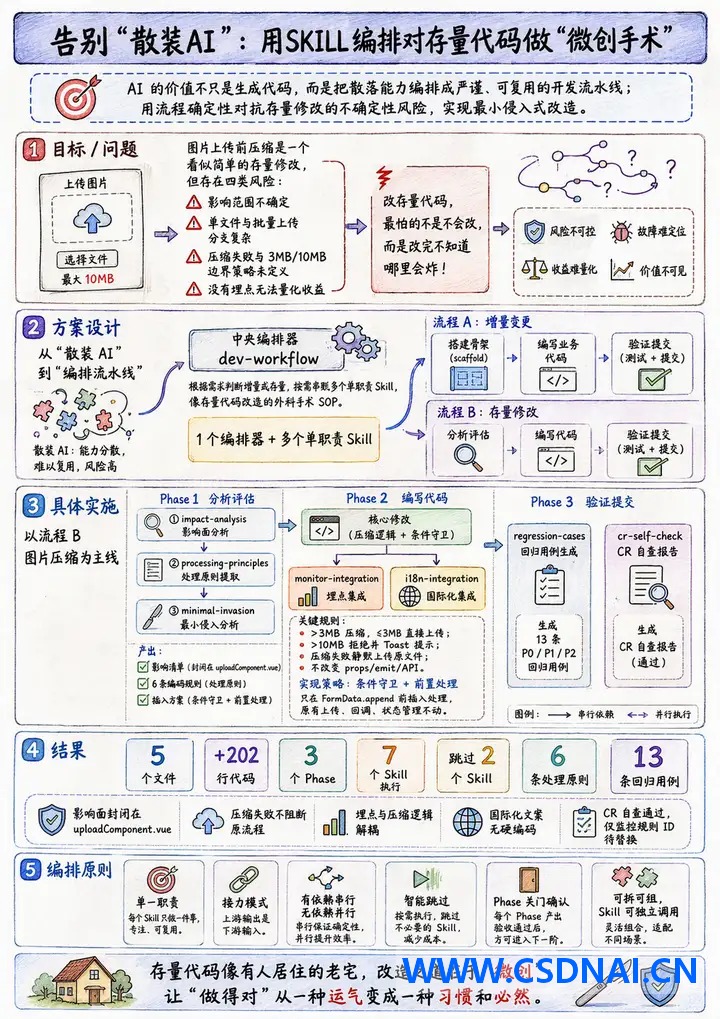
1分钟看图掌握核心要点👇
一、标杆情形:一个看似简便的存量代码改动
某场景上报模块需要新增“图片上传前压缩”功能。诉求本身简便,不过当作存量修改,切实的复杂性在于:
- 左右边界不确定:报量中牵扯上传图片的情形不止一处,细化要改哪一处?同一个上传组件被多个父组件共用,改了这一处,其他触发方会不会受影响?
- 逻辑分支复杂:单文件上传和批量上传两条路线,压缩逻辑要插入哪个分支、插到哪一层,会不会有副效用?
- 降级策略未界定:压缩失败时是折回触发方、静默降级上传原文件,还是提示用户?会不会导致上传功能不可用导致平稳性隐患?界限值等于 3MB 或 10MB 时算哪边?
- 成效很难量化:压缩功能发布后,没有埋点就无法印证它在起效用。压缩时期耗时和上传阶段省下来的时间对照,可否实现正向回报?需要资料支撑以校验调优效果。
核心矛盾:改存量代码,最怕的不是“不会改”,而是改完不知道哪里会炸。传统的“打开文件直接改”模式,极易遗漏代码之外的隐性工作:影响面没分析、处理规则没定义、埋点没集成、回归用例没覆盖——任何一个环节的遗漏都可能导致线上事故。
二、解决策略:从”散装AI”到”调度流水线”
为解决上述难题,我们不再依赖零散的AI问答,反倒搭建了一条可复用的AI帮衬开发流水线。其核心思想是:把开发流程中那些”每次都要做、不过轻松忘”的步骤,沉淀为独立的、单职责的AI Skill,并通过一个智慧调度器按需串联落实。
使AI当作助手,严格遵照链路,这就像为存量代码修改拟定了一份基准的”外科手术SOP”。
三、结构构建
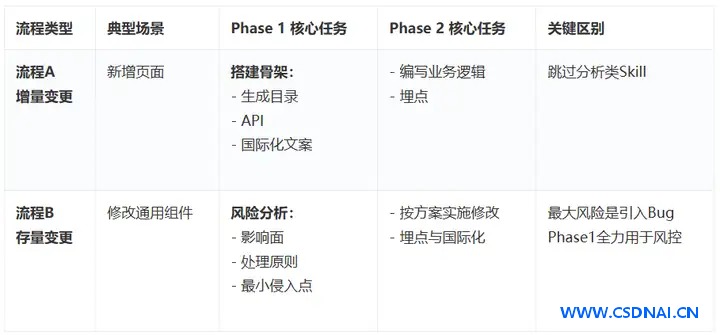
整个体系由 1个中央调度器 (dev-workflow) 和 多个独立Skill 组成。调度器担责依据诉求类型,智慧编排并串联Skill;每个Skill则像流水线上的专用工具,只做完一项特定作业。
3.1 链路调度:两条路线,按需组装
dev-workflow(编排器)
│
├── 判断需求类型(增量 / 存量)
│
├── 增量需求 → 流程 A
│ │
│ ├── Phase 1 — 搭建骨架
│ │ ├── scaffold-generator → 生成模块目录结构
│ │ ├── api-definition → 生成 API 请求函数
│ │ └── i18n-integration → 生成国际化文案
│ │
│ ├── Phase 2 — 编写业务代码
│ │ ├── [编写或生成业务逻辑]
│ │ └── monitor-integration → 埋点集成(如需要)
│ │
│ └── Phase 3 — 验证提交
│ ├── regression-cases → 回归用例生成
│ └── cr-self-check → CR 自查
│
└── 存量修改 → 流程 B
 │
 ├── Phase 1 — 分析评估
 │ ├── impact-analysis → 影响面分析
 │ ├── processing-principles → 处理原则提取
 │ └── minimal-invasion → 最小侵入分析
 │
 ├── Phase 2 — 编写代码
 │ ├── [实施代码修改]
 │ ├── monitor-integration → 埋点集成
 │ └── i18n-integration → 国际化文案
 │
 └── Phase 3 — 验证提交
 ├── regression-cases → 回归用例生成
 └── cr-self-check → CR 自查
反倒依据诉求类型(增量、存量),挑选不同的Skill组合与落实顺序,调度器并非机械地运转所有Skill。
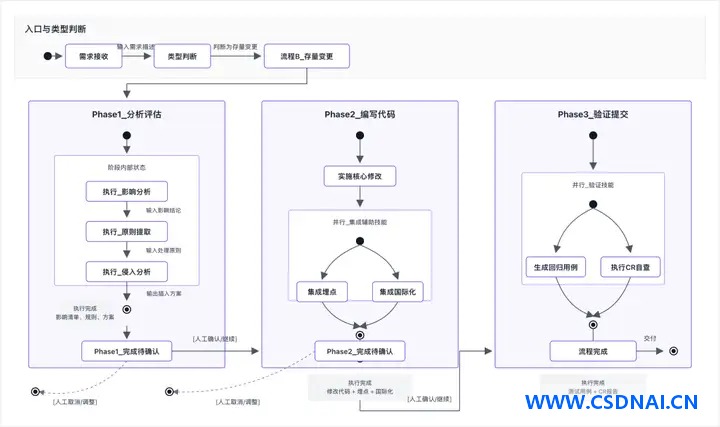
以链路B为例,下面的状态机图呈现了完整的动态落实流转——涵盖 Phase 内部的 Skill 串行顺序、两个并行分支,与每个 Phase 结束后的关门确认点:
3.2 技能方阵:每个Skill的职责与产出
每个 Skill 好比流水线上的每台”机器”。多个 Skill,每个只做一件事。它们之间通过”产出物”传递资料——上游 Skill 的输出,就是下游 Skill 的输入。
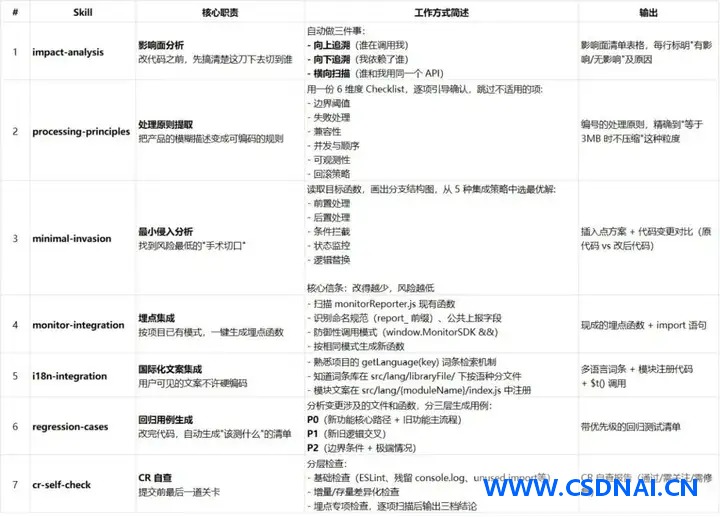
设计思路:每个 Skill 都是独立的 Markdown 文件,既能被编排器调度,也能单独使用——例如:只想分析影响面?直接调 impact-analysis;紧急 hotfix 可以跳过 Phase 1,直接进 Phase 2。
3.3 调度机理:三个机制使流水线不僵化
调度器通过三个核心机理保证流水线弹性可控:
- 智慧跳过:并非每个 Skill 都要跑。调度器依据诉求特质自助判断,跳过不适用的 Skill。本次实操中 9 个 Skill 落实了 7 个,跳过了 2 个(scaffold-generator、api-definition)。
- Phase 关门:每个 Phase 做完后暂停确认,输出摘要并询问可否延续,使人类保留纠偏的权力。
- 独立可拆卸:每个 Skill 可独立采用,调度器只是”推介的串联方法”,并非”唯一的使用方式”。
三个机理的构建动机、实现细节和实操成效,详见第四、五章。
3.4 资料流转:Skill 间的接力赛方式
整个链路中最值得关注的,是 Skill 之间怎么传递资料。
这并非通过 API 或数据库,反倒通过自然语言形式的产出物在对话上下文文中流转:
impact-analysis
 │ 输出:"影响面极小,修改封闭在 uploadComponent.vue 内部"
processing-principles
 │ 输入:上游结论 → 跳过"跨组件兼容性"检查项
 │ 输出:6 条编码规则(含阈值、降级策略、埋点要求)
minimal-invasion
 │ 输入:6 条规则 → 确定需要"条件守卫 + 前置处理"两种模式
 │ 输出:具体的代码插入方案
[代码实施]
 │ 输入:插入方案 → 机械化编写代码
 ├──▶ monitor-integration(规则第 5 条触发)
 ├──▶ i18n-integration(Toast 文案触发)
regression-cases
 │ 输入:变更的文件和函数 → 生成回归清单
cr-self-check
 │ 输入:所有修改的文件 → 逐项检查
 │ 输出:CR 自查报告
上游 Skill 的结论会直接影响下游 Skill 的行为。 比如:
- impact-analysis 判定”左右面小”→ processing-principles 跳过了”跨组件兼容”和”回滚策略”检查项
- processing-principles 明确了”需要埋点”→ 调度器在 Phase 2 自助激活了 monitor-integration
- processing-principles 没提到”新建模块”→ 调度器跳过了 scaffold-generator
四、实操推演:以”图片压缩”诉求跑通链路B
以下以”某场景上报图片压缩”这一标杆存量诉求,演示链路B怎样运转。
工程师输入诉求描述后,调度器 dev-workflow 自助拆解需求特质。调度器判定为存量改动,自助路由至链路B,本次”图片上传前压缩”牵扯对现有 upload Component.vue 组件的修改。
Agent执行过程
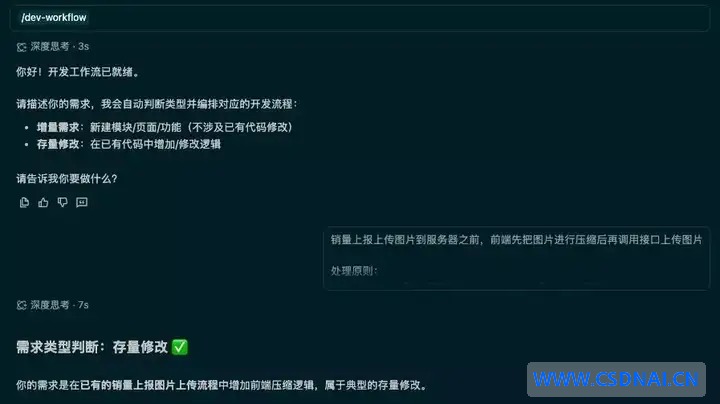
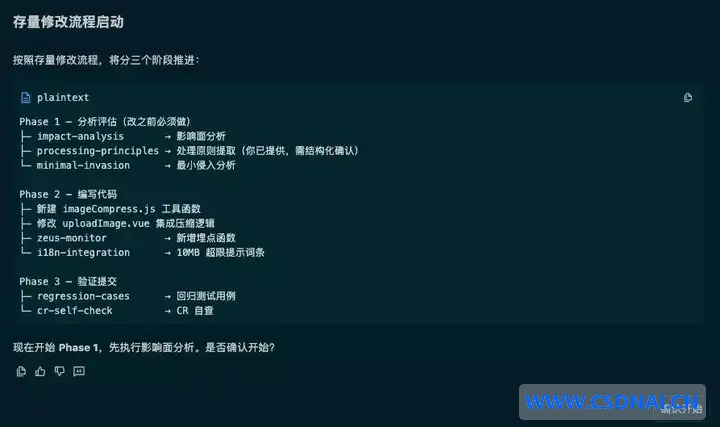
以下按 Phase 渐渐拆解,看每个 Skill 细化干了什么、产出了什么。
4.1 Phase 1:拆解评估(三个 Skill 严格串行)
Phase 1 的三个 Skill 是有依赖关联的——后者需要前者的输出。所以必须串行执行。
Skill 1: impact-analysis — 影响面分析
输入:需求描述 + 目标文件路径(upload Component.vue)
AI 自助扫描了触发链——向上追溯(谁在调用我)、向下追溯(我依赖了谁)、横向扫描(谁和我用同一个 API),最终输出:
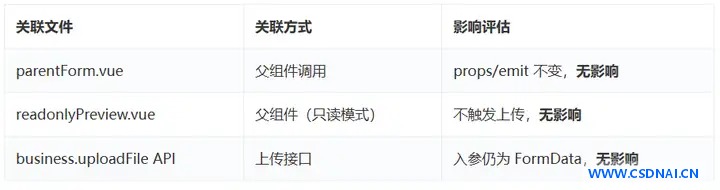
结论:影响面极小,修改完全封闭在 upload Component.vue 内部。 这一步给了我们动手的信心。
这个结论被传递给下一个 Skill——processing-principles 所以知道不需要考虑”跨组件兼容”的难题。
Agent执行过程
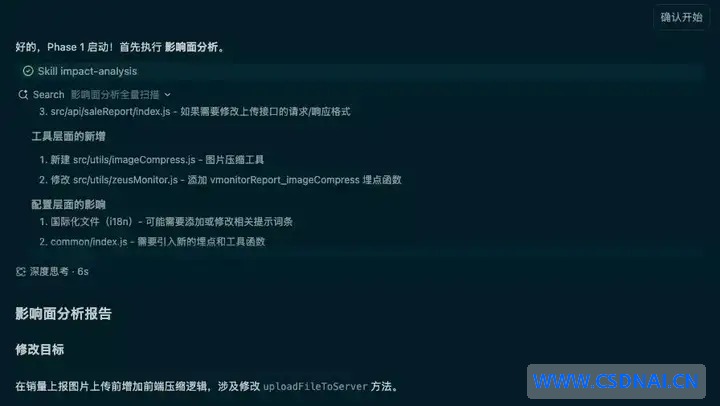
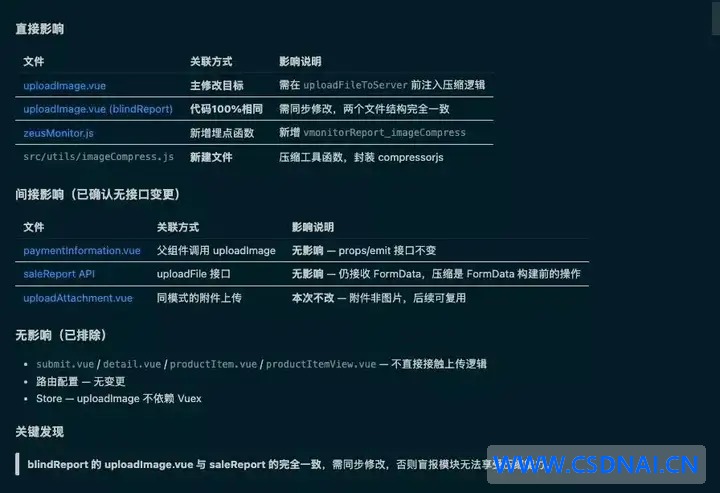
Skill 2: processing-principles — 处理原则提取
输入:需求描述 + impact-analysis 的结论(影响面小,无跨组件变更)
它拿着结构化 Checklist(界限阈值、失败处置、兼容性、并发与顺序、可观测性、回滚策略六大角度)逐项引导确认。中间抛出了两个要害难题:
- “等于 3MB 时算哪边?” → 用户挑选:不压缩
- “压缩失败要不要提示用户?” → 用户挑选:不提示
最终沉淀出 6 条编码级规范:
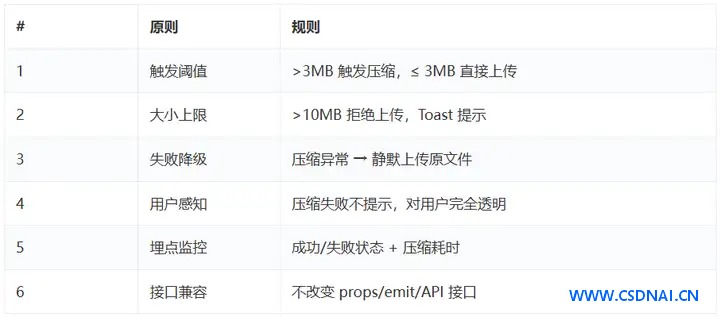
亮点:等于 3MB 时不压缩,等于 10MB 时允许上传——这种边界值的决策,如果没提前想清楚,写到一半才发现又得改。
这 6 条规范被传递给下一个 Skill——minimal-invasion 据此敲定代码怎么插入。
Agent执行过程
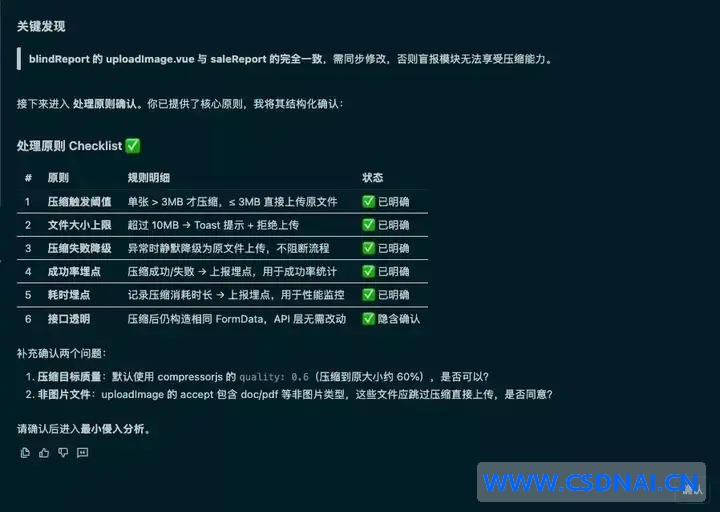
Skill 3: minimal-invasion — 最小侵入分析
输入:目标函数源码 + processing-principles 的 6 条规则
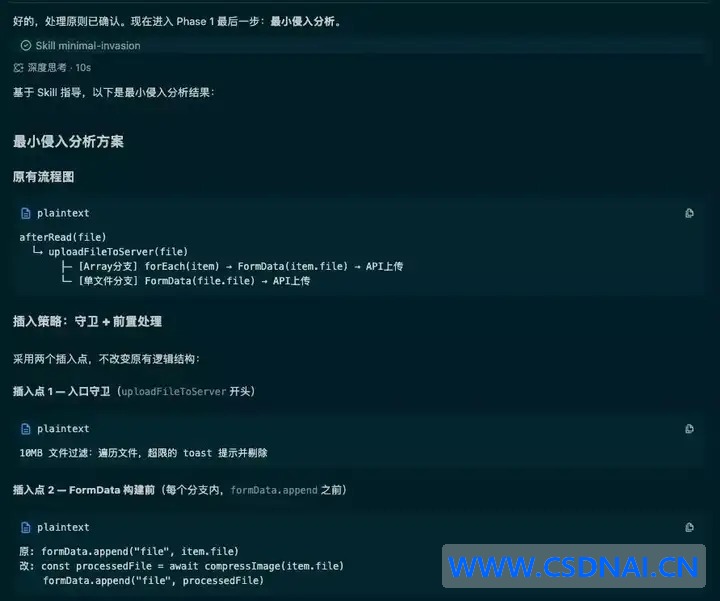
它读取 upload File To Server 方式,画出分支结构:
uploadFileToServer(file)
├── if (Array) ──── 批量上传
│ └── forEach → FormData.append → 调用接口
└── else ─────────── 单文件上传
 └── FormData.append → 调用接口
然后从 5 种整合策略中挑选了两种的组合:
- 条件守卫(规范 2):入口处 10MB 拦截,迅速失败
- 前置处置(规范 1/3):Form Data.append 之前插入压缩,失败降级返回原文件
输出了细化的代码改动策略:
// 原来
formData.append("file", item.file);

// 改为
const processedFile = await this.processFileWithCompress(item.file);
formData.append("file", processedFile);
只改一个变量名,原有的上传、回调、状态管理全部不动。 这就是”最小侵入”的精髓。
Agent执行过程
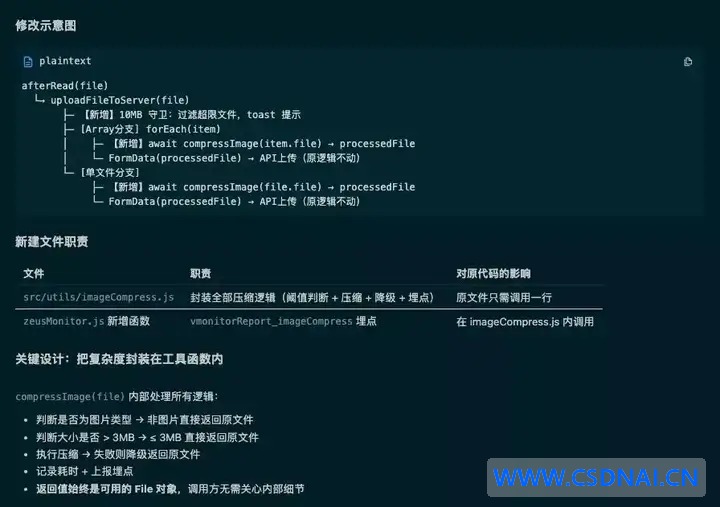
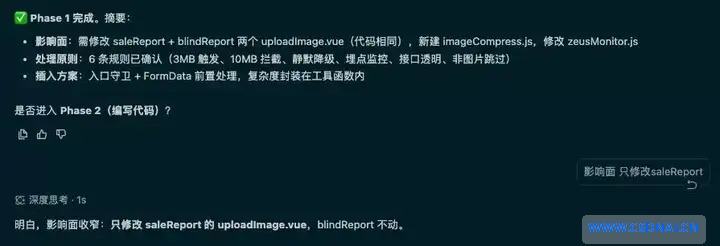
Phase 1 小结:三个 Skill 像接力赛一样——impact-analysis 递出”影响面”,processing-principles 接棒递出”规则”,minimal-invasion 再接棒递出”插入方案”。上游的结论直接影响下游的行为:
- impact-analysis 判定”左右面小”
- processing-principles 就跳过了”跨组件兼容”检查项
- processing-principles 明确了”需要埋点”
调度器就在 Phase 2 自助激活 monitor-integration;没提到”新建模块”,调度器就跳过了 scaffold-generator。此时调度器暂停,输出摘要并询问可否延续——这是关门机理的第一道确认门。
4.2 Phase 2:编写代码(执行 + 两个帮衬 Skill)
拿到 Phase 1 的三份产出,写代码就变得十分机械化。
代码实施:三个文件,一套设计
文件 1:压缩工具函数file Compress.js
核心构建是 Promise + 回调双通道:
export function compressImage(file, callbacks = {}){
 return new Promise((resolve) => {
 // ...
 new Compressor(file, {
 quality: 0.8,
 success(result) {
 callbacks.onSuccess?.({ duration, originalSize, compressedSize, savedRatio });
 resolve(compressedFile); // Promise 通道:返回压缩结果
 },
 error(err) {
 callbacks.onFail?.({ duration, error: err.message });
 resolve(file); // 关键:失败也 resolve,不 reject!
 }
 });
 });
}
设计亮点:永远 resolve,永不 reject。 压缩失败时返回原文件,调用方完全不需要 try/catch。这保证了:
- 压缩成功 → 上传压缩后的文件
- 压缩失败 → 上传原文件
- 触发方代码完全一致,零分支
文件 2:集成到 upload Component.vue
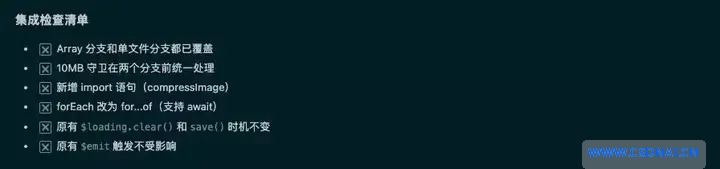
核心文件 upload Component.vue 只改了三处:
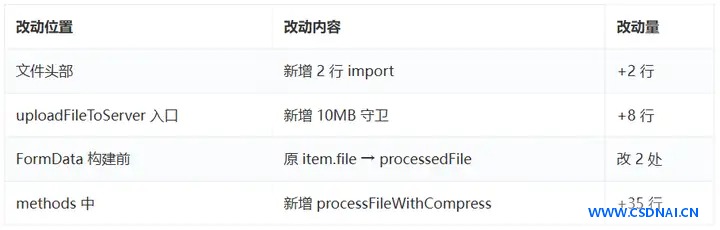
原有的 loading 管控、save 触发、差错处置——一行没动。
Agent执行过程
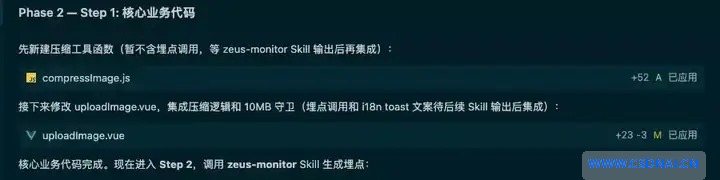
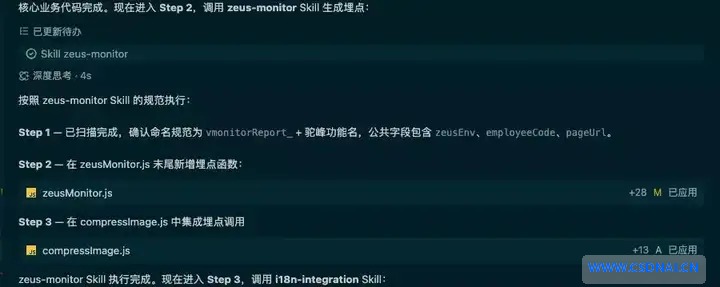
Skill 4: monitor-integration — 埋点集成
调度器自助触发了 monitor-integration Skill。,原因在于处置原则第 5 条要求”埋点观测”它扫描了 monitor Reporter.js 现有的 20+ 个埋点函数,识别出命名方式(report_ 前缀)和公共上报字段(运转环境、用户标识、页面地址),然后在文件末尾追加了 report_image Compress 函数——风格和已有函数完全一致。
上报字段包括:
status(success/fail)| duration(耗时ms)| originalSize | compressedSize | savedRatio | fileName
埋点与压缩逻辑的解耦:压缩工具函数不依赖任何埋点库,通过 callbacks.on Success / on Fail 暴露钩子:
compressImage(file, {
 onSuccess: (data) => report_imageCompress({ status: 'success', ...data }),
 onFail: (data) => report_imageCompress({ status: 'fail', ...data })
});
file Compress.js 是纯工具函数,可在任何模块复用;埋点逻辑留在场景层,由触发方敲定可否观测、怎么监控。
Agent执行过程
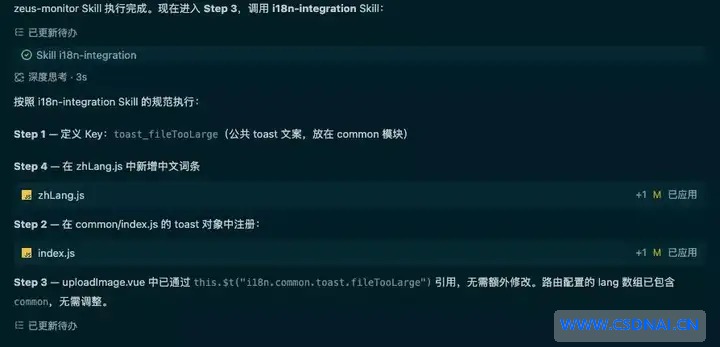
Skill 5: i 18n-integration — 国际化文案
调度器触发了 i 18n-integration Skill。,原因在于代码中有一处 Toast 提示(”文件大小不能超过10MB”)它在 zh Lang.js中加了一条词条,在 common/index.js 中注册了 key。
Agent执行过程
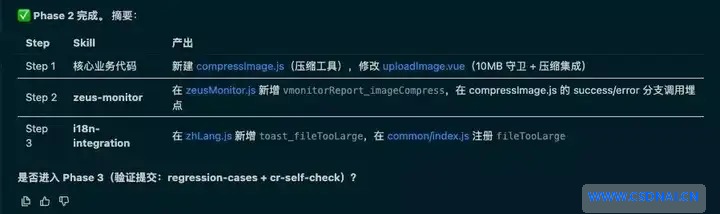
Phase 2 小结:代码执行时期的核心特质是机械化——Phase 1 早已定好了”在哪改、怎么改、改多少”,这一阶段只是按图施工。三个要害构建决策值得注意:
- file Compress.js 使用”永远 resolve”方式,压缩失败自助降级,触发方零分支
- upload Component.vue 仅改 3 处,原有 loading/save/差错处置一行未动
- 埋点通过 callback 钩子与压缩逻辑解耦,工具函数维持纯粹可复用
调度器依据 Phase 1 的结论自助激活了 monitor-integration(处置原则第 5 条要求)和 i 18n-integration(检测到硬编码 Toast),跳过了 scaffold-generator 和 api-definition。此时调度器再次暂停——这是关门机理的第二道确认门。
4.3 Phase 3:校验提交(两个 Skill 可并行)
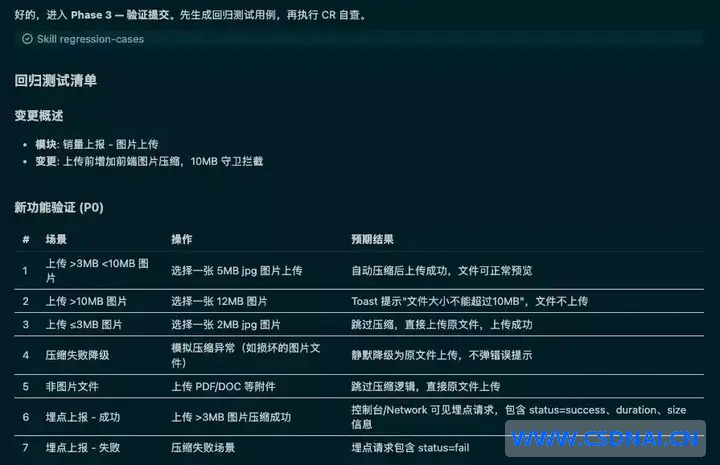
Skill 6: regression-cases — 回归用例生成
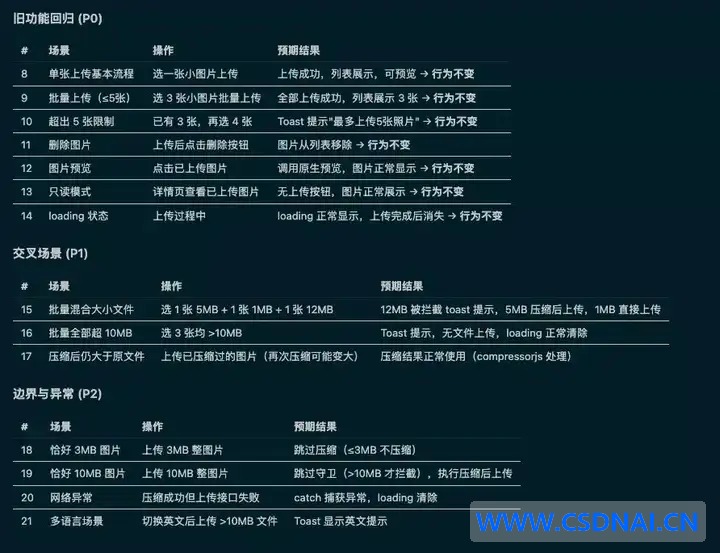
它拆解了本次改动牵扯的文件和新增逻辑,产出了 13 条回归用例:
Agent执行过程
Skill 7: cr-self-check — CR自查
它逐项检查了本次修改的所有文件,区分存量修改的专项检查(分支涵盖、API兼容、loading 状态、新逻辑失败不阻断原链路)和基础检查,输出:
- 通过项:无 ESLint 差错、无 console.log 残留、所有文案已国际化、所有分支已涵盖、原有API未变化、新逻辑失败不阻断原链路
- 需关注:观测规范 ID 为待替换(待监控基础申请后替换)
Agent执行过程
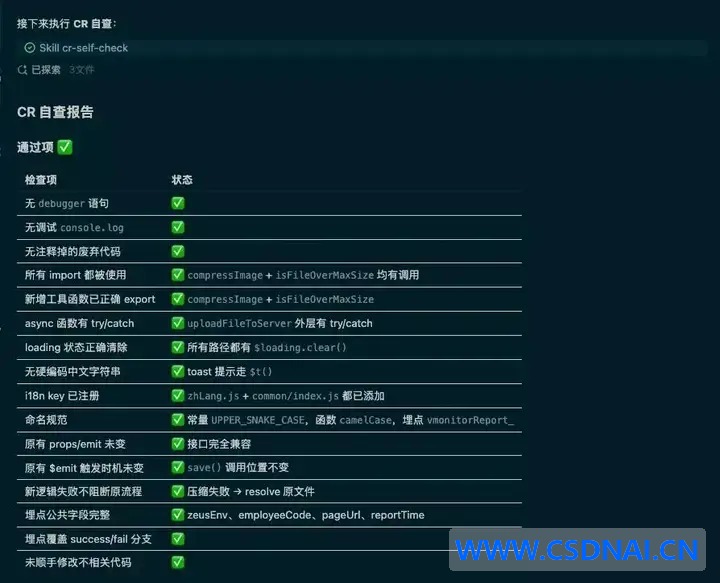
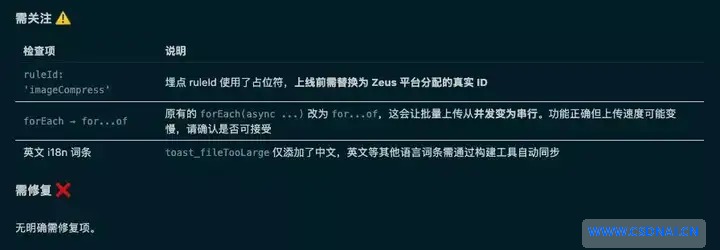
Phase 3 小结:两个验证 Skill 无依赖关系,可以并行执行。regression-cases 从变更文件和新增逻辑中自动推导出 13 条分级用例(P 0/P 1/P 2),覆盖了核心路径、交叉场景和边界条件;cr-self-check 则从代码规范、存量兼容性、埋点完整性三个维度逐项扫描,输出结构化的自查报告。
CR 自查告诉你”代码本身有没有难题”——一个朝向验证,一个面向审查,两个 Skill 的产出互补:回归用例告诉你”该测什么”。
4.4 落实资料总览
代码变更统计
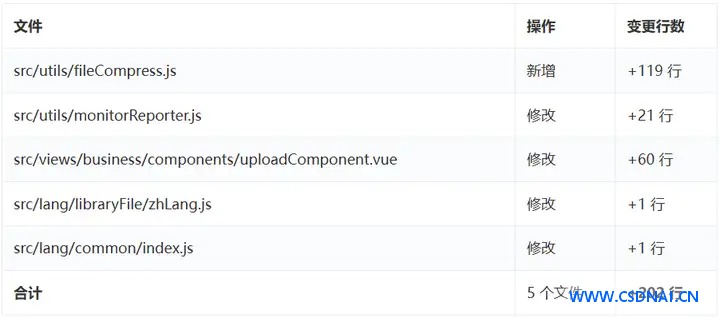
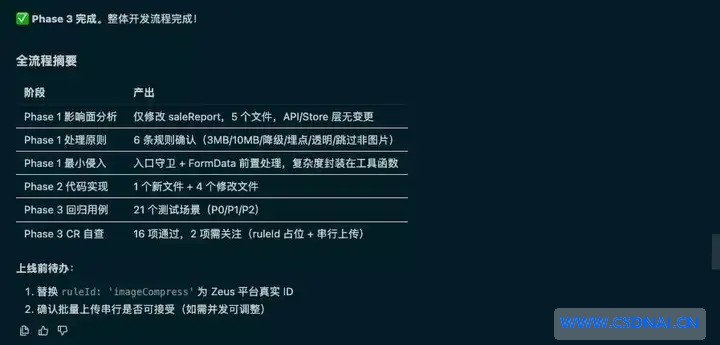
3 个 Phase、7 个 Skill 落实(跳过 2 个)、6 条处置原则、13 条回归用例、CR 自查整体通过。
流水线产出清单
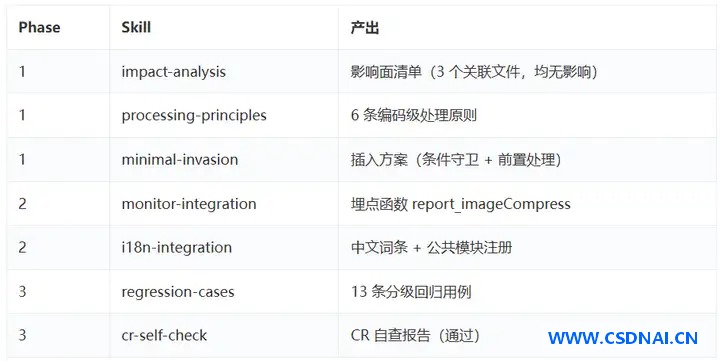
五、调度构建原则与决策
从结构构建和实操校验中,我们提炼出六条可复用的调度原则。每条原则不仅解释“做什么”,更解释“为什么”——没有它会怎样,与实操中怎样彰显。
5.1 六条原则
1. 单一职责——做螺丝刀,不做瑞士军刀
- 难题:假如把多个能力塞进一个“万能 Skill”,任何小改动都需要重新调试整个 Skill;不同情形无法按需组合。
- 构建:每个 Skill 只解决一个难题,独立成 Markdown 文件。调度器担责组合,Skill 只负责落实。
- 实证:本次实操中,monitor-integration 和 i 18n-integration 各自独立触发——假如归并为“帮衬整合 Skill”,就无法单独跳过某项能力。
2. 接力模式——上游的输出是下游的输入
- 难题:假如每个 Skill 独立取得信息(如各自重新拆解代码),不仅浪费 token,还或许产出矛盾的结论。
- 构建:Skill 之间通过自然语言“产出物”传递资料,而非 API 或数据库。LLM 天然产出自然语言,无需额外的序列化/反序列化开销。
- 实证:impact-analysis 输出“左右面极小” → processing-principles 据此跳过“跨组件兼容”检查项 → minimal-invasion 据此挑选“前置处置”而非“逻辑替换”。
3. 串行 vs 并行——有依赖的串行,无依赖的并行
- 难题:假如一律串行,浪费时间;如果一律并行,下游 Skill 拿不到上游结论。
- 构建:调度器判断 Skill 间可否存在资料依赖。Phase 1 三个拆解类 Skill 有严格依赖,务必串行;Phase 3 两个校验类 Skill 无依赖,能够并行。
- 实证:假如 processing-principles 和 impact-analysis 并行落实,processing-principles 就无法依据左右面结论跳过不适用的检查项,产出会含有海量无关的“跨组件兼容”拆解。
4. 智能跳过——不是每个 Skill 都要跑
- 难题:假如 7 个 Skill 每次都跑,增量诉求也要走完“左右拆解 → 处置原则 → 最小侵入”这条存量路线,“走链路”就变成了“走形式”。
- 构建:调度器保养一张跳过规范表,依据诉求特质和上游产出自助判断:
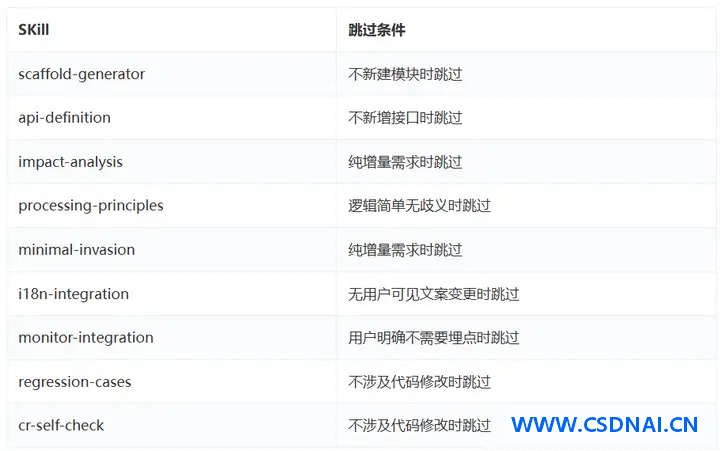
- 实证:本次实操中 9 个 Skill 落实了 7 个,跳过了 scaffold-generator 和 api-definition——调度器检测到没有“新建模块”和“新增API”的诉求特质。
5. 关门机制——每个阶段都有“确认门”
- 难题:AI 一口气写完代码,你发现路径就不对,整体要返工。越晚纠偏,开销越高。
- 构建:调度器在每个 Phase 做完后暂停,输出摘要并询问可否延续:
✅ Phase 1 完成。摘要:
- 影响面:修改封闭在 uploadComponent.vue 内部
- 处理原则:6 条编码规则
- 插入方案:条件守卫 + 前置处理

是否进入 Phase 2?或者需要调整什么?
- 实证:本次实操中,Phase 1 做完后调度器暂停,确认了左右面和插入策略后才进入 Phase 2。假如 Phase 1 的结论有误(如影响面判断遗漏),能够在此时纠正,而并非等 200 行代码写完再推翻。
6. 可拆可组——流水线是“建议”,不是“强制”
- 难题:假如调度器是唯一入口,那只想加个埋点就务必走完整个链路,使用门槛过高。
- 构建:每个 Skill 可独立触发。调度器是“推介的串联方法”,并非“唯一的采用方式”。
- 实证:紧急 hotfix 能够跳过 Phase 1 直接进入 Phase 2;其他工程可以复用单个 Skill(如只用 impact-analysis),不需要搬走整个调度器。
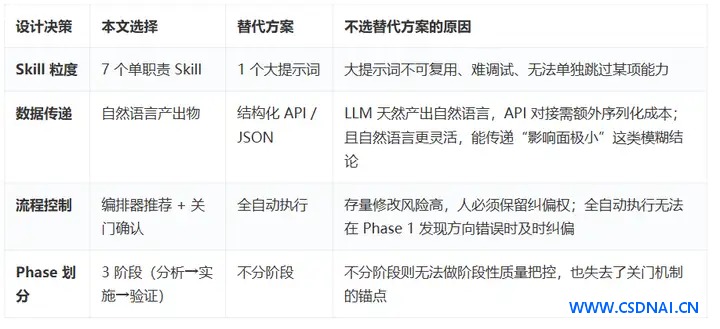
5.2 构建决策对照
调度构建的每个挑选背后,都有替代策略。以下对照解释了“为什么选这条路”:
存量代码如同有人居住的老宅,改造之道在于”微创”。本次实现说明,AI的意义不仅在于产出代码,更在于将散落的能力调度成一条严谨、可复用的”开发流水线”。对抗存量修改中的不确定性隐患,使”做得对”从一种运气,它通过链路的确定性。
这条流水线并未增添事务的复杂度,反倒将那些原本依赖个人心得、轻松遗漏的隐性工作显性化、自助化。我们以最小的切口(改动202行代码),安全地嵌入了一个新功能,最终。
AI 写代码的能力已经不稀奇了。真正有价值的,是把 AI 的能力编排成一个可复用的流程——让”做得对”变成一种习惯,而不是一种运气。
ID:1249