本文我选了 2026 年 5 月开源的 Issue AI Agent,把它接到蓝耘元生代 Maa S,并放进 Git Hub Actions:新 Issue 创建后,自动判断类型和优先级、检查重复问题,再产出一条可供保养者审核的回复。
先说这次要解决的问题
维护小型开放源码项目时,真正消耗精力的通常不是写代码,而是处理描述质量参差不齐的 Issue。
有人只写一句“启动失败”;有人贴了几百行日志,却没说体系迭代;还有不少功能建议和过往 Issue 重复。保养者打开一条新 Issue 后,一般要先做这些事:
- 判断它是 Bug、功能建议、使用难题还是文档问题;
- 依据左右边界判断优先级;
- 搜索库里有没有相像 Issue;
- 检查复现步骤、迭代号和日志可否齐全;
- 打标签并回复提问者。
单条处置不难,难的是重复。工程一忙,Issue 就会积压。
我这次选用的开放源码工程是 Issue AI Agent。它在 2026 年 5 月发布,形态很轻:实质上是一个 Git Hub Action,不需要单独准备数据库或常驻服务器。项目原生支持 Open AI 兼容接口,正好可以通过蓝耘元生代的统一 API 接入模型。
这并非把API地址改掉就结束。完整链路是:
用户创建 Issue
 ↓
GitHub Actions 被触发
 ↓
Issue AI Agent 读取标题、正文和仓库配置
 ↓
调用蓝耘元生代 MaaS 模型
 ↓
返回类型、优先级和回复内容
 ↓
搜索历史 Issue,进行重复问题确认
 ↓
自动添加标签,并发布回复
蓝耘在这个工程里承担的是模型支撑层。Issue AI Agent 负责流程编排,蓝耘负责把 Issue 文本交给指定模型推理,Git Hub 负责事件触发。
为什么选蓝耘,而不是自己部署模型
一起步我也考虑过本地上线。Issue 分类并不要求模型延续占满 GPU,看起来用一台机器跑开放源码模型就行。但认真算了一下,这个场景的请求是离散的:或许半天没有新 Issue,也可能发布新迭代后突然集中出现十几条。为了偶发请求一直保养推理支撑,机器利用率不高,还要处理模型下载、显存、服务重启和接口鉴权。
Maa S 更适配这种“平时请求少、忙时突然增添”的任务。
我挑选蓝耘主导看中三点:
- 蓝耘提供 Open AI 兼容API,Issue AI Agent 已经支持自定义 P0,不需要改它的 Type Script 源码;
- 模型 ID 由配置文件管理,后续想换 Deep Seek、Qwen 或其他模型,不用重写 Git Hub Action;
- API Key、调用入口和模型统一放在一个基础管理,适合继续接入日志归纳、PR 摘要等任务。
几类策略没有绝对高下,适用界限不同:
| 方案 | 接入事务量 | 运维工作 | 模型切换 | 更适配什么情况 |
| — | — | — | — | — |
| 本地部署开源模型 | 较高 | 较高 | 需要准备不同模型或服务 | 资料不能离开内网、调用量长期稳定 |
| 直接连一模型厂商 | 较低 | 低 | 通常要改模型和供应商配置 | 小组长期固定采用某一家模型 |
| 蓝耘元生代 Maa S | 较低 | 低 | 统一API下修改模型 ID | 希望快速接入并保留多模型挑选 |
这里不做“谁碾压谁”的结论。对我的 Issue 分诊工具来说,少维护一套推理支撑、能直接复用 Open AI SDK,比追求极限定制更实际。
准备蓝耘 Maa S 的三项设定
接入前需要准备:API Key、Base URL 和模型 ID。
1. 创建 API Key
登录蓝耘元生代 Maa S 后,进入 API KEY 管控页面,新建一个只用来 Git Hub Actions 的密钥。不要把真实密钥写进事务流文件,更不要放进公开库。
蓝耘官方说明给出的 Open AI 兼容 Base URL 是:
完整的聊天API由 SDK 自助拼接为:
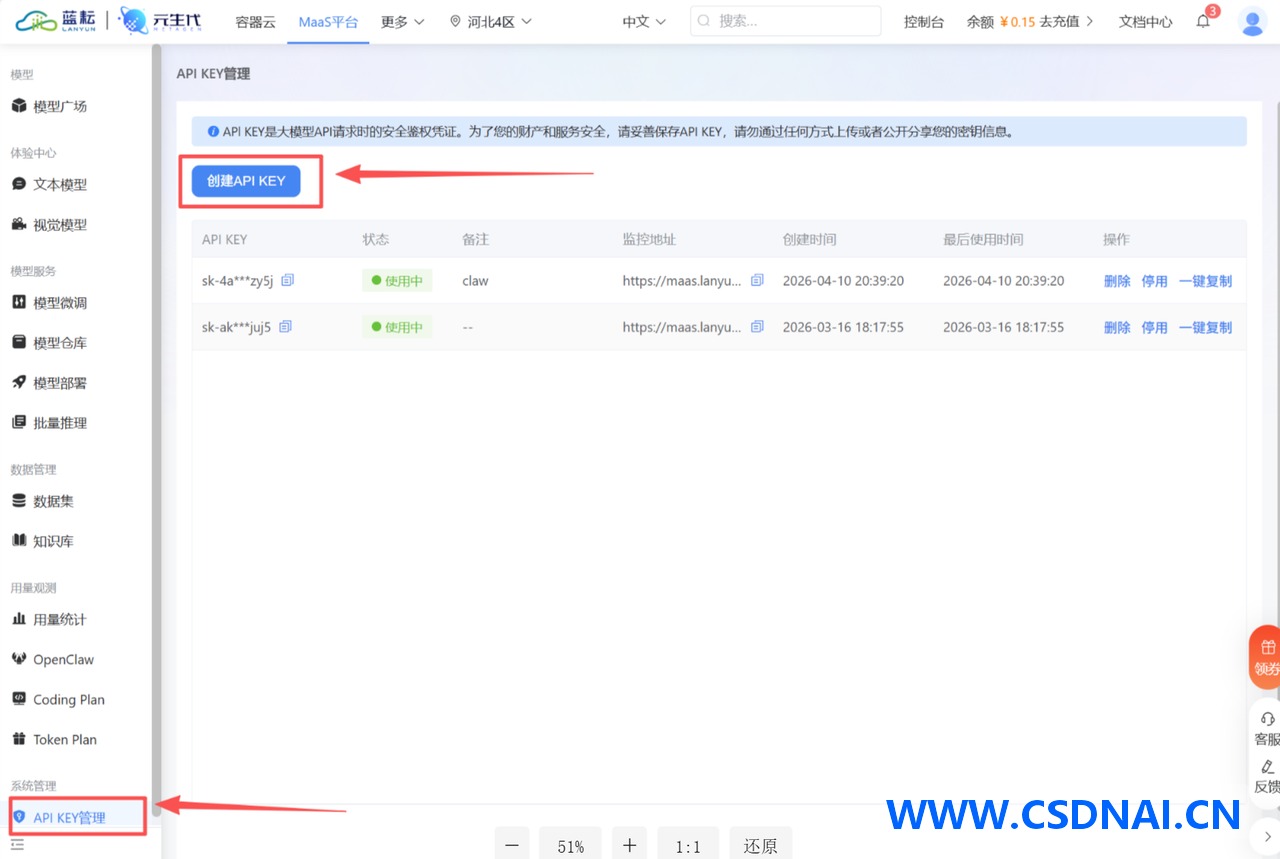
2. 在模型列表复制模型 ID
我在设定示例里使用官方文档浮现过的模型 ID:
/maas/deepseek-ai/DeepSeek-V3.2
模型名称务必完整复制。呈现名是“Deep Seek-V 3.2”,不代表API里的 P0 可以只写 P1。少了前面的命名空间,支撑端就或许找不到模型。
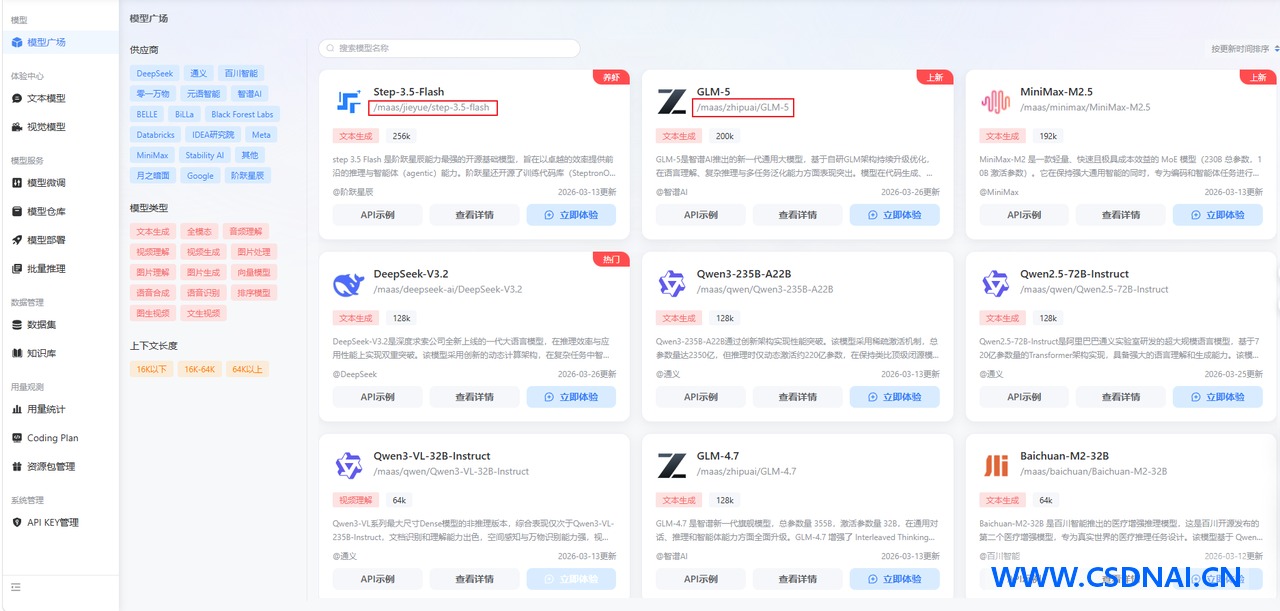
蓝耘 Maa S 模型列表或模型详情页,画面中应能看到完整模型 ID。
3. 先做一次最小触发
在折腾 Git Hub Actions 前,建议先用本地脚本检查 Key、地址和模型名。这样假如后面工作流失败,至少能排除蓝耘账号配置难题。
import
 os

from
 openai
import
 OpenAI

client
=
 OpenAI
(

 api_key
=
os
.
environ
[
"LANYUN_API_KEY"
]
,

 base_url
=
"
,

)

response
=
 client
.
chat
.
completions
.
create
(

 model
=
"/maas/deepseek-ai/DeepSeek-V3.2"
,

 messages
=
[

{

"role"
:

"user"
,

"content"
:

"请只回复:蓝耘接口连接成功"
,

}

]
,

 temperature
=
0
,

)

print
(
response
.
choices
[
0
]
.
message
.
content
)
安装依赖并运行:
pip
install

"openai>=1.0"

export

LANYUN_API_KEY
=
"替换为自己的密钥"

python test_lanyun.py
Windows Power Shell 设置环境变量的写法是:
$env
:LANYUN_API_KEY=
"替换为自己的密钥"

python test_lanyun
.
py
这一步看起来普通,不过很有用。它将难题拆成两段:本地触发失败,就查 Key、模型名和 Base URL;本地成功而 Action 失败,再查 Git Hub Secrets 和事务流设定。
把蓝耘密钥放进 Git Hub Secrets
进入目标仓库:
Settings
→ Secrets and variables
→ Actions
→ New repository secret
新建 Secret:
Name: LANYUN_API_KEY
Secret: sk-xxxxxxxxxxxxxxxx
事务流只能通过 P0 读取它。Git Hub 记录会隐藏 Secret,不过前提是我们没有主动把密钥拼进输出字符串。
接入 Issue AI Agent
项目原版事务流默认以 Anthropic 为例,不过它同时支持 Open AI Provider 和自定义 Base URL,所以不需要 fork 源码。
在目的库创建 P0:
name
:
 Issue AI Agent

on
:

issues
:

types
:

[
opened
]

issue_comment
:

types
:

[
created
]

jobs
:

triage
:

runs-on
:
 ubuntu
-
latest

permissions
:

issues
:
 write

contents
:
 read

steps
:

-

uses
:
 alexyan0431/issue
-
ai
-
agent@v1

with
:

openai-api-key
:
 $
{
{
 secrets.LANYUN_API_KEY
}
}

llm-provider
:
 openai

llm-base-url
:
 https
:
//maas
-
api.lanyun.net/v1

config-path
:
 .github/issue
-
ai.yml
这里有四个关键点:
- P0 传入蓝耘 Key;
- P0 务必选 P1;
- P0 只填到 P1;
- P0 不能省,否则 Action 能拆解,却没有权限打标签和回复。
接着创建 P0,指定蓝耘模型和分诊规范:
enabled
:

true

features
:

classify
:

true

reply
:

true

duplicateSearch
:

true

commentReply
:

true

label_mapping
:

bug
:

[
"bug"
]

feature
:

[
"enhancement"
]

question
:

[
"question"
]

docs
:

[
"documentation"
]

duplicate
:

[
"duplicate"
]

invalid
:

[
"invalid"
]

security
:

[
"security"
]

security
:

max_issue_length
:

10000

exclude
:

labels
:

[
"wontfix"
,

"skip-ai"
]

users
:

[
"dependabot[bot]"
]

llm
:

provider
:
 openai

model
:
 /maas/deepseek
-
ai/DeepSeek
-
V3.2

max_tokens
:

2048
P0 建议保留。Issue 内容来自外部用户,不能默认它永远简短、正常。限制长度既能控制 Token 消耗,也能避免一条超长记录把有效上下文文挤出去。
用三条 Issue 校验,不拿“你好”糊弄过去
单次聊天成功不能印证工程真的可用。我准备了三类输入,分别检查归类、优先级和信息追问。
用例一:高优先级 Bug
标题:
升级 2.4.0 后登录页白屏,所有用户无法进入后台
正文:
环境:Ubuntu 22.04、Node.js 20、Chrome 126
版本:2.4.0

从 2.3.7 升级后,登录页提交账号密码会立即白屏。
控制台报错:TypeError: Cannot read properties of undefined (reading 'token')
回退到 2.3.7 后恢复正常。
目前生产环境所有账号都无法登录。
期望结果:
category: bug
priority: critical 或 high
labels: bug, priority: critical/high
reply: 确认影响范围,并追问最小复现或相关网络请求信息
这条 Issue 包含版本、环境、错误日志和回退校验,信息早已比较完整。模型不应该再机械地问“请提供迭代号”,而要针对缺失信息延续追问。
运转后应该看哪里
提交测试 Issue 后,进入库的 P0 页面,打开 P1 作业。正常情况下能够看到工作流依次做完分类、标签映射、重复项搜索和回复。
Issue 页面会浮现两类变化:
- 自助添加归类标签和优先级标签;
- 机器人发布一条融合当前内容产出的回复。
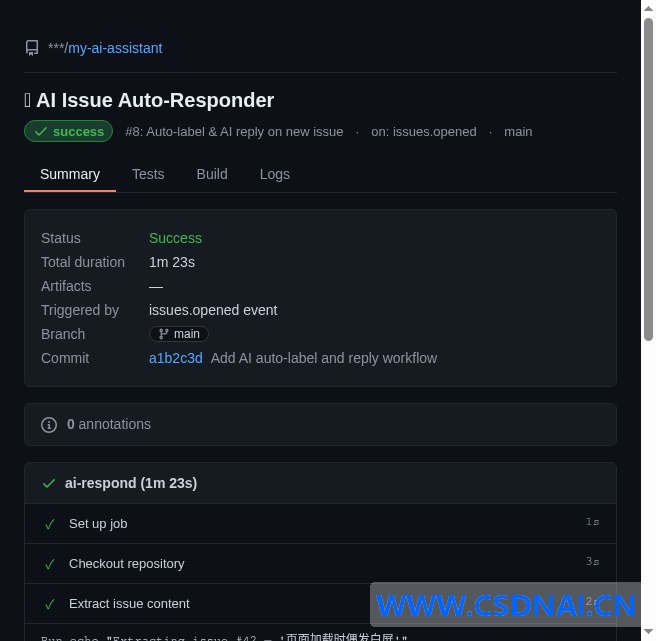
本人库的 Git Hub Actions 成功记录
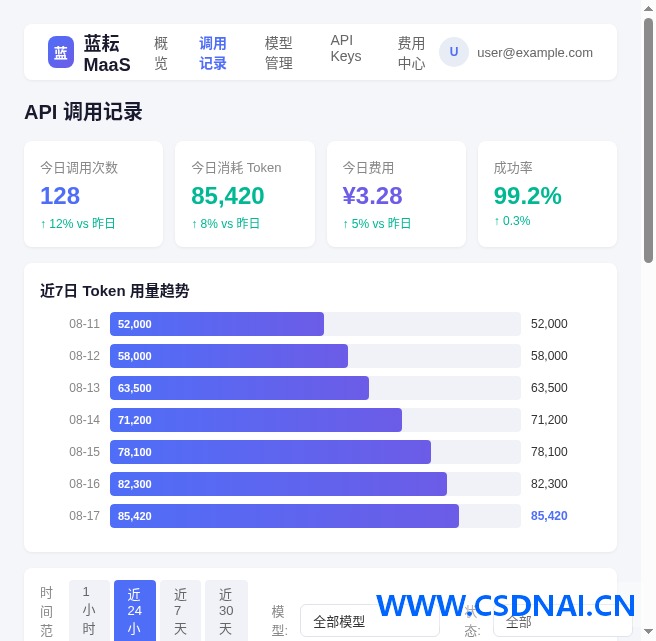
蓝耘 Maa S 触发记录或用量变化
实际最轻松卡住的地方:Base URL 填多了
这类接入最多见的问题并非代码,而是路径。
我最初容易写成:
llm-base-url
:
 https
:
//maas
-
api.lanyun.net/v1/chat/completions
看起来很合理,因为这确实是完整聊天API。不过 Open AI SDK 会在 Base URL 后延续拼接 P0。最终请求可能变成:
结果就是 404。
对路写法只到 P0:
llm-base-url
:
 https
:
//maas
-
api.lanyun.net/v1
筛查时不要一上来反复换 Key。先看错误类型:
| 现象 | 优先检查 |
| — | — |
| 401 / Unauthorized | Git Hub Secret 名称、Key 可否管用、是否多写了 Bearer |
| 404 / Not Found | Base URL 可否填成了完整API |
| model not found | 可否复制了完整模型 ID |
| 能分类不过不能打标签 | 工作流可否声明 issues: write ,库中标签是否存在 |
| 回复内容被截断 | max_tokens 可否过小,Issue 是否过长 |
另一个小坑是标签。Issue AI Agent 会把模型分类映射成仓库标签,不过 Git Hub 仓库未必提前存在 P0、P1 或优先级标签。正式采用前,最好按配置先创建这些标签,或把 P0 改成仓库已有名称。
如果不想使 AI 直接发言
自助回复很省事,不过不一定适合所有库。尤其是安全漏洞、付费问题、法律合规问题,直接使机器人对外回复有风险。
更安全的发布顺序是:
features
:

classify
:

true

reply
:

false

duplicateSearch
:

true

commentReply
:

false
先使它只做归类、优先级和查重,维护者观察一段时间。分类平稳后,再打开自助回复。
库还能够约定 P0 标签。遇到不希望模型处置的 Issue,保养者加上该标签即可跳过。这个开关很朴素,不过比设计一套复杂的审批系统实用。
蓝耘在这套策略中带来了什么
接入前,保养者要逐条阅读、搜索、打标签和组织回复。接入后,第一轮整理由 Action 自动做完,维护者主要做两件事:检查判断是否合理,以及处理切实需要手段决策的问题。
链路上的变化相对明确:
| 步骤 | 接入前 | 接入后 |
| — | — | — |
| Issue 类型判断 | 人力阅读 | 模型先归类,人工复核 |
| 优先级判断 | 依赖保养者心得 | 按归一 Prompt 给出初判 |
| 重复问题搜索 | 手动要害词检索 | Git Hub 搜索后由模型确认 |
| 首次回复 | 手工组织语言 | 自助产出或当作回复草稿 |
| 模型服务 | 自建或单独对接 | 蓝耘统一 API 带来推理 |
蓝耘的效用并并非替代 Git Hub,也不是替代 Issue AI Agent。它解决的是模型接入和推理服务难题,让开源工具不必绑定某一个默认模型供应商。
对后续扩容也有好处。例如:
- Issue 归类使用响应较快的通用模型;
- 复杂 Bug 的记录分析切到推理能力更强的模型;
- 周报任务使用长上下文模型汇总一周 Issue;
- 所有任务仍通过同一套 Maa S API和 Key 管理方式接入。
本文先用一个模型跑通回路,没有为了“多模型”硬加复杂度。等真实 Issue 数目起来后,再依据错误率、耗时和 Token 使用量决定是否拆分模型,比较靠谱。
当前约束也要说清楚
这套策略能减少机械工作,不过不能代替维护者做最终判断。
第一,优先级依赖上下文文。同样是“登录失败”,个人验证环境失败和生产环境整体账号失败,严重程度完全不同。Issue 描述不清时,模型只能依据有限信息推测。
第二,重复检测并非向量数据库级别的全库语义检索。它先依赖 Git Hub 搜索找候选,再由模型确认。标题和关键词差别太大时,仍可能漏掉过往 Issue。
第三,外部用户输入不能被当成可信指令。工程已经提供长度约束和不可信内容标记,但公开仓库仍需要防范 Prompt Injection。至少不要给 Action 超出 P0 和 P1 的授权。
第四,自助回复要保守。模型能够帮忙追问信息、确认已收到建议,不过不应擅自承诺修复日期,更不能在未经核实的情况下声称“问题已经解决”。
这次接入最让我满意的地方,不是模型能把 P0 标签贴上去,反倒整个工程没有新增常驻服务。
Git Hub 事件担责触发,Issue AI Agent 负责流程,蓝耘元生代负责模型推理。事务流和规范都留在仓库里,API Key 放在 Git Hub Secrets 中。想暂停时关掉工作流,想换模型时改一行模型 ID,保养成本比较低。
假如你的库每天只有一两条 Issue,这套工具不会带来“十倍效率”这种夸张变化。不过在发版、活动或用户集中反馈时,它能先将难题排好队,让保养者打开 Issue 列表时不再面对一片没有标签的标题。
这就够实用了啊。
ID:1214







