传统 RAG 的召回环节大多只挂一路向量检索。语义相似度确实能兜住泛化表达,但遇到产品型号、条款编号、错误码这类精确串就明显吃力;反过来纯关键词检索又接不住”适合夏天穿的鞋”这种转述。检索增强要解决的就是这个覆盖缺口,排序增强则负责把召回结果里真正对的那几条顶到前面。两件事分开做,再合起来看协同效果。
双路召回怎么拼才不打架
混合检索的本质是把 BM25 和向量相似度两路候选合并打分。最直观的做法是线性加权:
综合得分 = α · BM25_norm + (1 - α) · Semantic_norm
BM25 由 TF-IDF 演化而来,带词频饱和与文档长度归一化,对精确串敏感;语义分一般来自 Sentence-BERT 一类双塔模型。两者量纲差得远,BM25 原始分可能落在 0 到几十,余弦相似度在 0 到 1 之间,直接相加没有意义,必须先归一化。
Min-Max 归一化是最常见的处理,把每路得分压到 0-1 再融合。但它有个隐患:归一化依赖当前批次的极值,同一篇文档在不同查询批次里得分会漂移,线上表现不稳定。工程上更稳的选择是排名融合。Elasticsearch 8.8 之后内置了 RRF(Reciprocal Rank Fusion),用排名倒数求和代替分数加权:
score = Σ 1 / (rank_constant + rank_i)
rank_constant 默认 60,调大能削弱头部排名的绝对优势,适合两路召回质量接近的场景;调小则更信任各自的前几名。RRF 完全不看原始分数,天然免疫量纲问题,多路召回扩展也方便。代价是丢掉了分数里蕴含的置信度信息,如果某一路召回明显更可靠,线性加权仍有优势。
α 的取值没有通用答案。电商场景里语义略占上风,0.4 到 0.6 是常见区间;法律、工单这类精确匹配权重高的场景可以往 0.6 以上压。调参别拍脑袋,在验证集上跑网格搜索或贝叶斯优化,指标用 Recall@K 和 MRR 一起看。融合后的候选保留 Top-50 左右交给下一级,再多就是给重排序白送计算量。
重排序模型选型与显存账
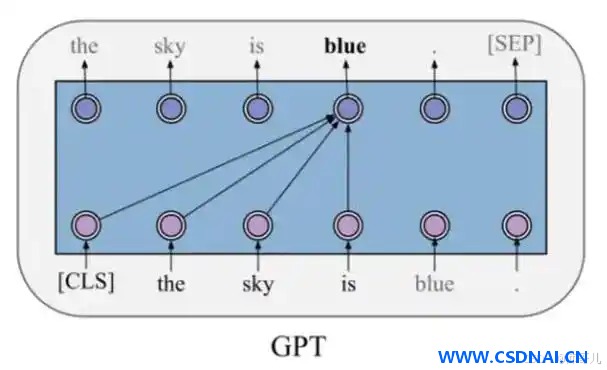
召回给的是粗排结果,Top-50 里”沾边但不核心”的文档经常排在真正答案前面。重排序用交叉编码器把 query 和 document 拼成一个序列送进 Transformer:
[CLS] Query [SEP] Document [SEP]
自注意力直接建模两者的细粒度交互,取 [CLS] 的隐状态过一层 MLP 输出相关性概率。这比双塔各自编码再算余弦要准得多,代价是无法预计算文档向量,每个 query-doc 对都得跑一次前向。
模型选择上,bge-reranker 系列开源、中等硬件可跑,通用 RAG 场景够用;mxbai-rerank-v2 主打长上下文和推理速度,适合长文档切块后的段落级重排;Cohere Rerank 是多语言企业场景的付费选项。选型时别只看榜单分数,先确认自己的文档长度分布和延迟预算。
部署阶段最容易翻车的是显存。以 bge-reranker-base 为例,FP16 下模型权重约 0.5GB 量级,但激活值和 KV 缓存随批大小线性增长。批大小设 32、序列长度 512 时,单卡 16GB 通常能跑;一旦把批大小拉到 128 又没截断长度,OOM 几乎是必然的。定位方法很直接:先用 nvidia-smi 观察显存峰值,再把批大小二分下调,同时用 torch.cuda.max_memory_allocated() 打印实际分配量,确认是权重占满还是激活撑爆。INT8 量化能把权重压到约四分之一,但要注意 bge-reranker 的量化版本需要匹配对应的推理后端,直接对 FP16 权重做动态量化可能掉点,上线前务必在验证集上对比 NDCG@10。
批处理本身是提速关键,一次喂 10 到 32 个候选比逐条推理快数倍。候选数量控制在 Top-50 是有依据的:继续扩大候选池,核心相关文档的边际召回收益迅速衰减,而延迟线性上涨。
两段增强的耦合关系
混合检索和重排序不是两个独立模块拼起来就完事。召回阶段决定了重排序的上限——如果精确匹配那一路被 α 压得太狠,正确文档压根没进 Top-50,交叉编码器再强也救不回来。反过来,重排序能纠正召回阶段的排序噪声,把”语义沾边但答非所问”的文档压下去。
一个实用的验证方法是构造分层测试集:精确串查询、语义转述查询、长尾罕见查询各取一批,分别统计仅向量召回、混合召回、混合召回加重排序三档的命中率。如果混合召回相对纯向量提升不明显,先查 BM25 分词器和归一化逻辑,而不是急着换重排序模型。
实现时的几个边界条件
混合检索不是万能药。语料本身极短(比如单句 FAQ)时,BM25 的文档长度归一化失去意义,两路召回高度重合,融合收益有限。重排序也有不适用场景:候选文档极长且需要跨段推理时,单条拼接会截断关键信息,得先做段落切分再重排。
成本上要算清楚。交叉编码器的推理开销与候选数成正比,QPS 高的在线服务要么缩候选池,要么上蒸馏后的小模型,把深层交互能力迁移到双塔结构里换取吞吐。动态权重是另一个方向:事实型查询把 α 往关键词侧推,开放语义查询往向量侧推,按查询意图路由。元数据过滤同样值得加,时间、领域、作者这些字段在召回前做硬过滤,比事后重排更省算力。
整条链路的调优顺序建议是:先把召回覆盖率做上去,再调重排序模型和批大小,最后才抠 α 和 rank_constant 这类融合参数。顺序反了,后面调得再细也是在错误的候选集上做文章。
ID:7449