训练一个神经网络,写出前向传播和反向传播只是起点。真正让模型收敛、且收敛得漂亮的,是调优。这篇文章围绕损失曲面上的导航问题展开,把动量、自适应学习率、参数初始化、批归一化这几件事串起来讲清楚。
损失曲面上的麻烦
神经网络训练的本质,是在一个非凸的损失曲面上找全局最小值。凸优化里只有一个最优值,没有局部最优的概念,所以好解。非凸优化不一样,函数有多个极值点,其中只有一个全局最优,其余都是局部最优或鞍点。
学习率选多大是个绕不开的问题。太小,收敛慢到让人失去耐心;太大,网络可能根本不收敛。
更麻烦的是,损失曲面本身会变。如果训练集不能代表真实数据分布,换到新数据上,曲面就变了。这就是为什么训练集和测试集必须能反映总体分布。用户对音乐或电影的偏好在变,数据分布也在变,曲面跟着变。
局部最优其实没那么可怕
早期研究把局部最小值当成神经网络调优的头号敌人。后来发现,足够大的网络里,大多数局部最小值带来的误差已经足够低。找到真正的全局最小值,没那么重要。误差低的局部最小值完全可以接受。

鞍点才是更隐蔽的坑
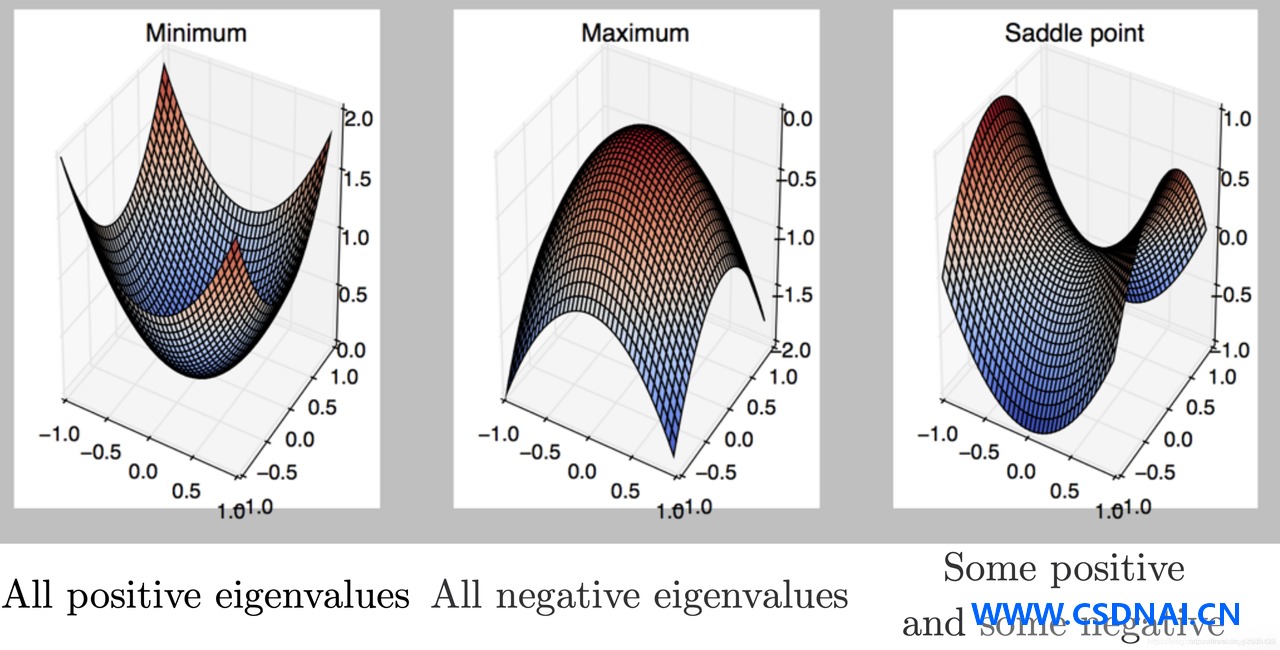
高维空间里,鞍点比局部极小值更常见。鞍点的麻烦在于,接近它时梯度可能非常小。梯度下降在这里几乎不更新网络,训练就停住了。
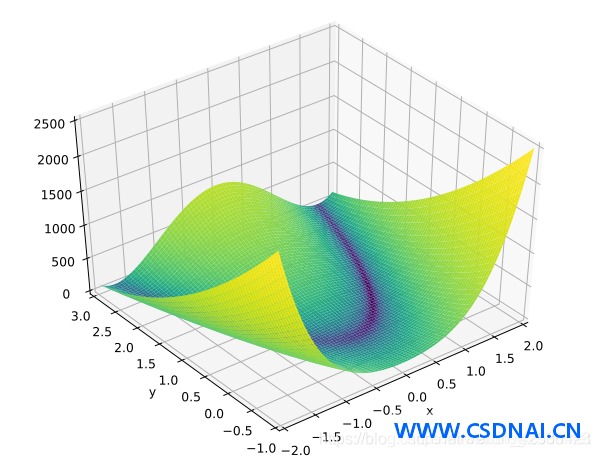
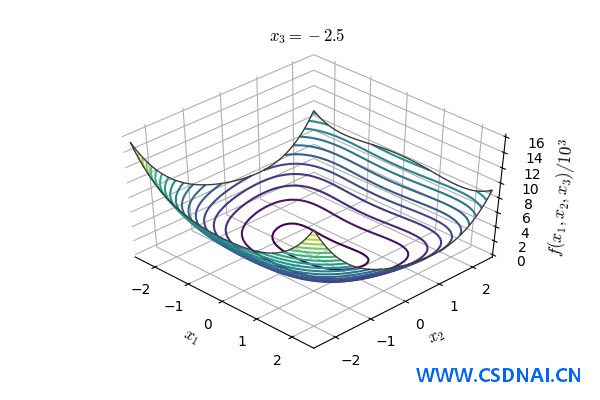
鞍点在一个方向上是极小值,在另一个方向上是极大值。Rosenbrock函数常被用来测试优化算法在鞍点附近的表现。它的全局最小值落在一个长而窄的山谷里,找到山谷不难,难的是收敛到谷底。山谷太平坦,梯度太小,依赖梯度的优化过程很难走完最后一段。
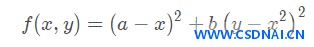
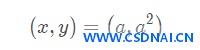
病态条件让训练变慢
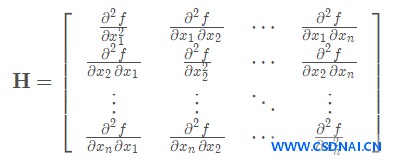
误差函数的导数常常是病态的。Hessian矩阵,也就是二阶偏导数方阵,描述了多变量函数的局部曲率。可以用Hessian判断一个固定点是不是鞍点:如果Hessian在该位置是indefinite的,那这个固定点就是鞍点。看特征值也能得到类似结论。
完整计算和存储Hessian需要O(n²)内存,对神经网络这种高维损失函数来说不现实。实践中常用truncated-Newton和quasi-Newton方法,后者用近似Hessian的算法,BFGS是其中最流行的之一。
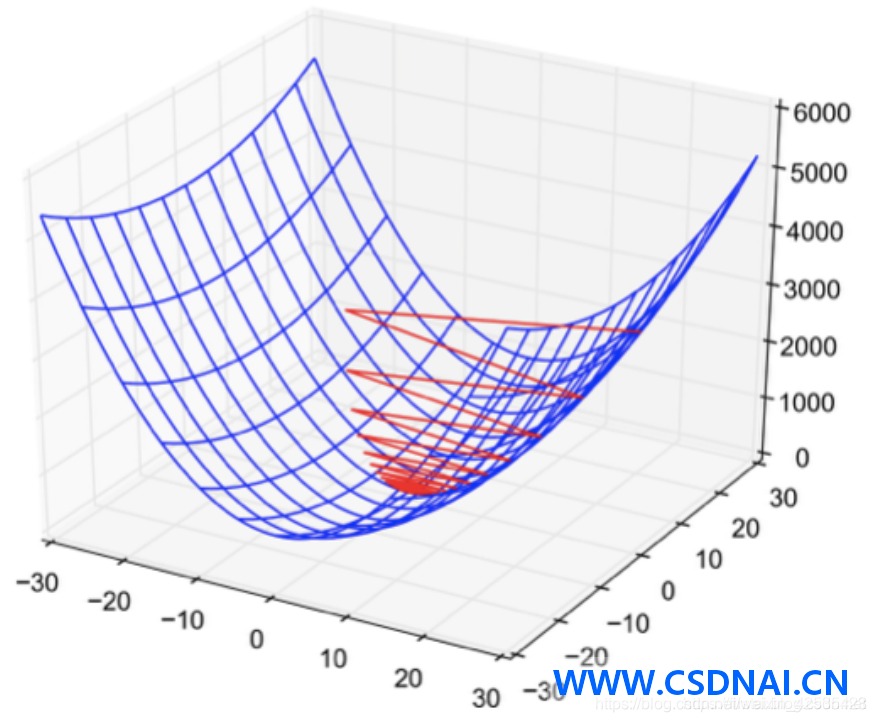
神经网络的Hessian通常是poorly conditioned的,输出随输入微小变化而快速变化。这意味着优化过程不平稳。即使梯度很强,训练仍然很慢。
梯度消失与爆炸
前面讨论的是目标函数的结构问题。神经网络架构本身还有另一类问题,在深度网络中尤其突出。
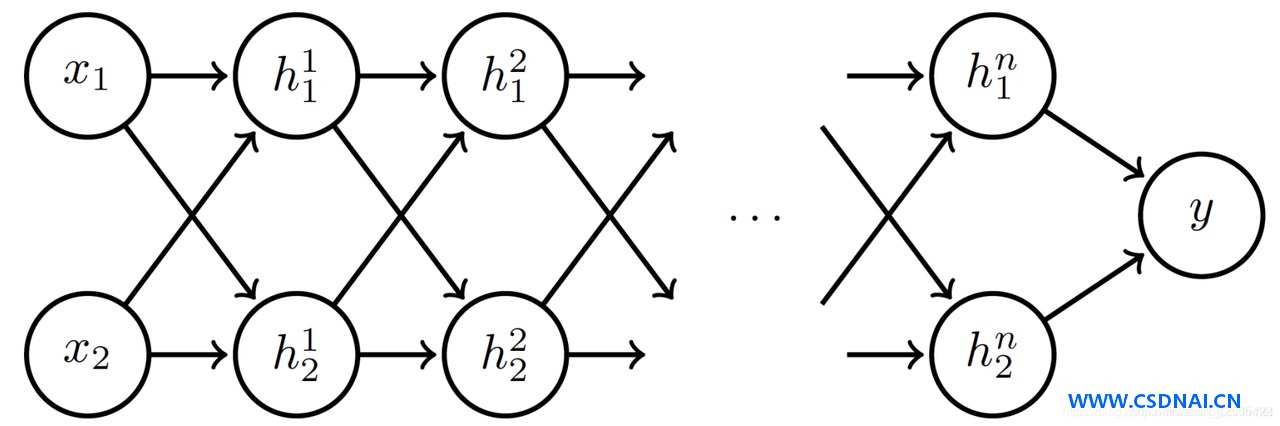
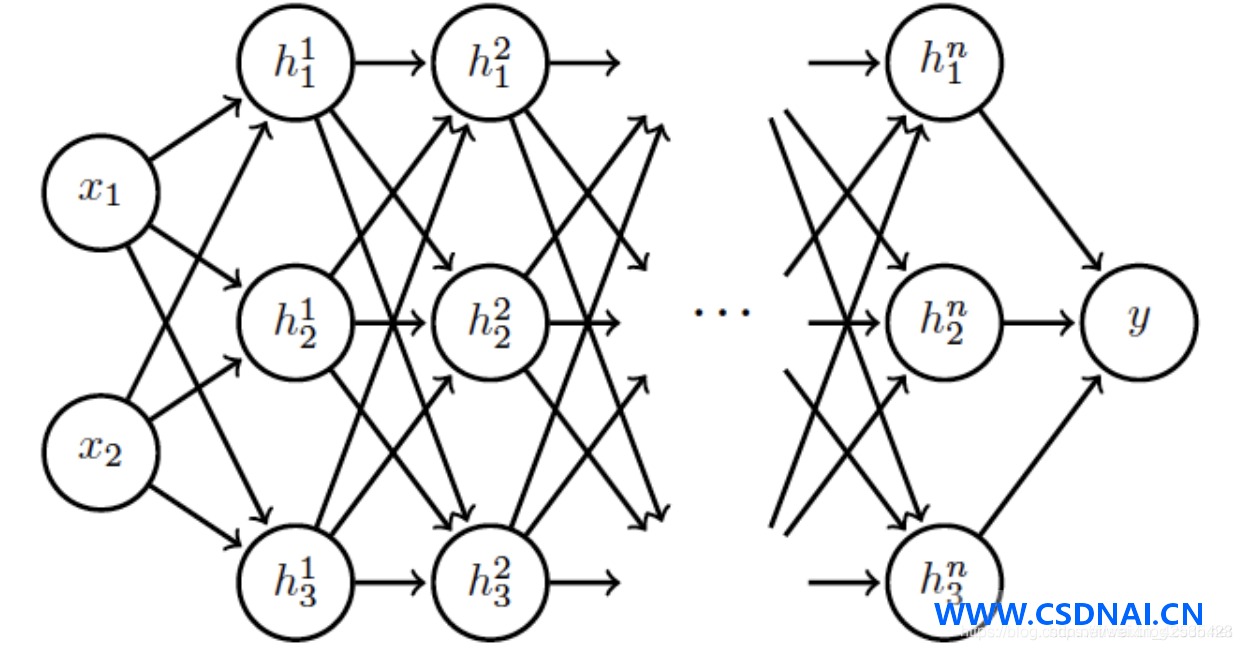
一个n层隐藏层的网络,每层做仿射变换再套激活函数。把单层公式展开成n层输出后,根据权重和偏置的大小,会出现两种极端。
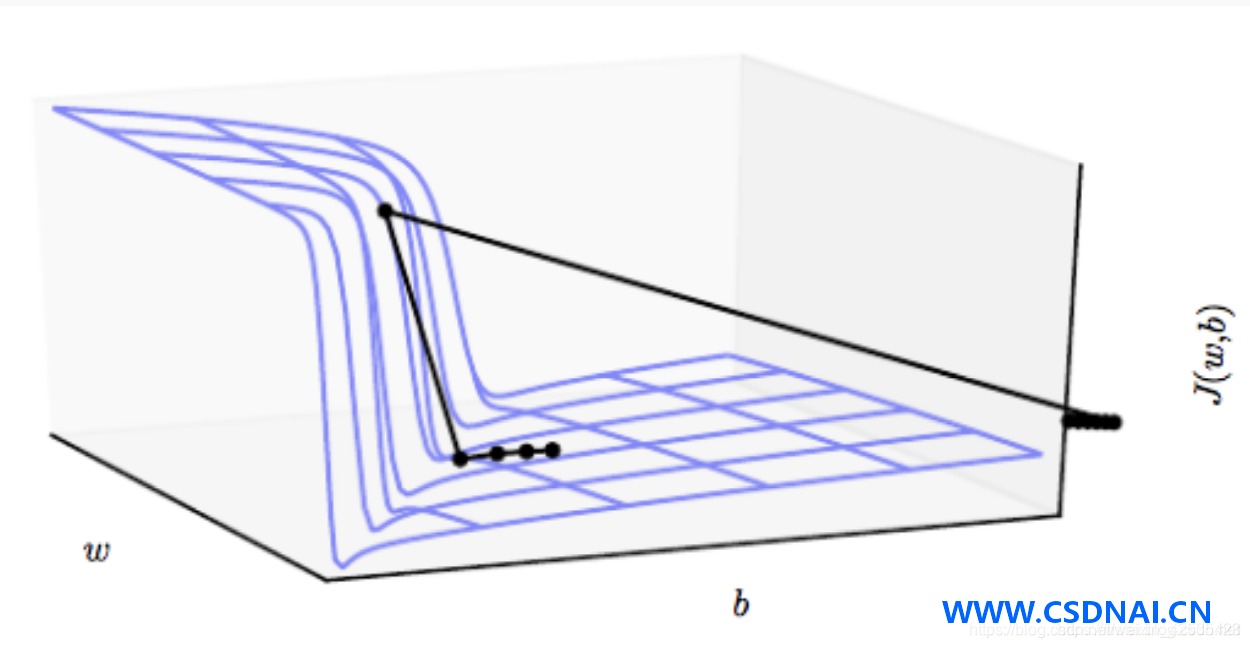
值大于1时,深层网络中梯度在传播过程中快速爆炸。除非做梯度裁剪,否则爆炸的梯度会产生悬崖。梯度裁剪规则就是超过某个阈值就截断。
值小于1时,梯度迅速趋近于零。计算机只能存储有限小数位,梯度小到一定程度就被当成零。
动量:让更新带点惯性
动量来自物理概念,是物体质量和速度的乘积。放在优化里,它让参数更新沿之前的方向保持一定惯性。
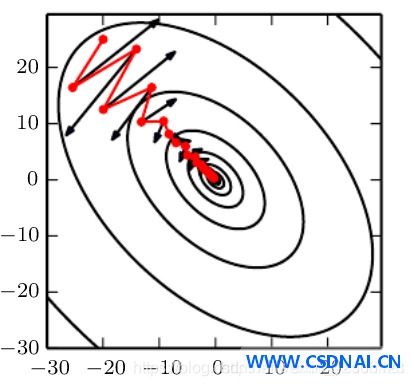
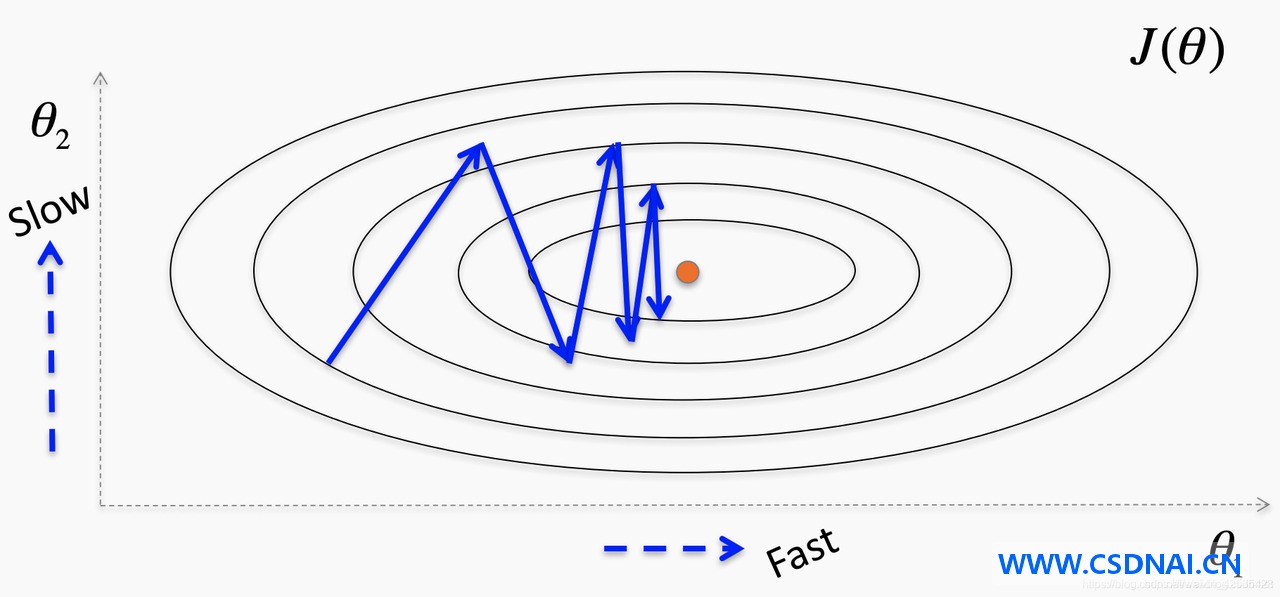
随机梯度下降有个振荡问题,因为更新时没有充分利用曲率信息。曲率高的时候,SGD会变慢。用平均梯度可以得到更快的优化路径,相反方向的梯度互相抵消,振荡被抑制。
动量项让优化算法沿一般路径移动时抵抗路径变化,高曲率表面的振动因此衰减。动量是目标函数里的附加项,取值在0到1之间,通过尝试从局部最小值跳出来增大向最小值迈进的步长。
动量值大,学习率应该保持小。动量值大也意味着收敛会快。但如果动量和学习率都大,可能一步跳过最小值。动量值小不能安全避开局部最小值,还可能拖慢训练。梯度方向持续变化时,动量还能平滑变化。合适的动量值靠随机尝试或交叉验证确定。
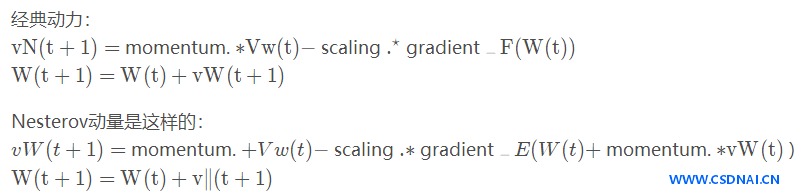
动量用过往梯度更新,相关值v通常叫velocity。最近的梯度权重更大,形成梯度的指数加权平均。
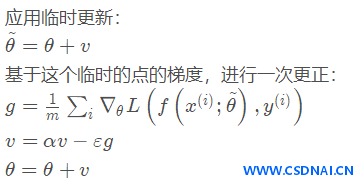
计算梯度、更新速度、更新参数三步走:
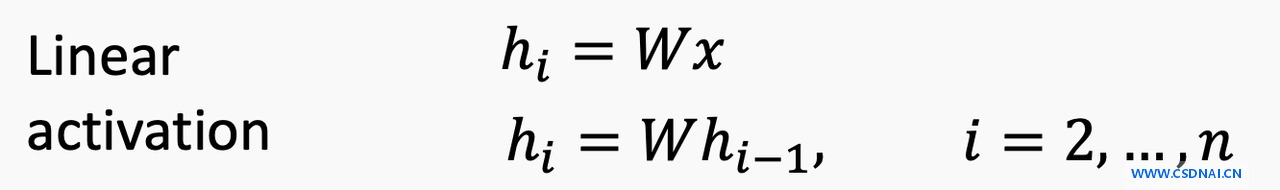
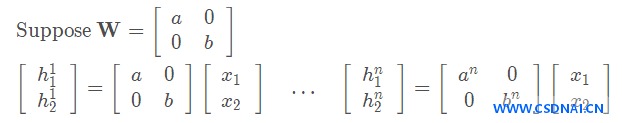
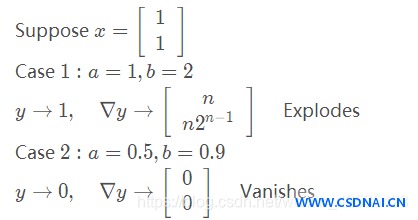
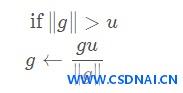
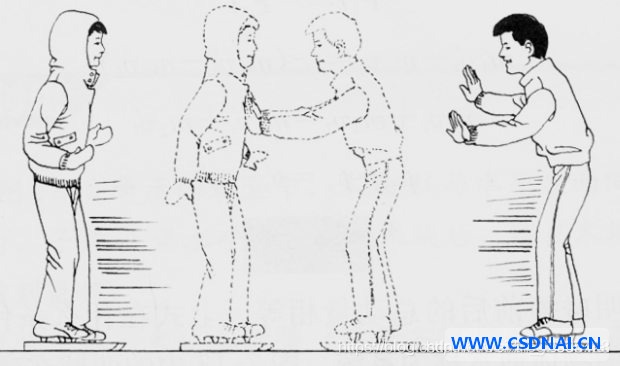
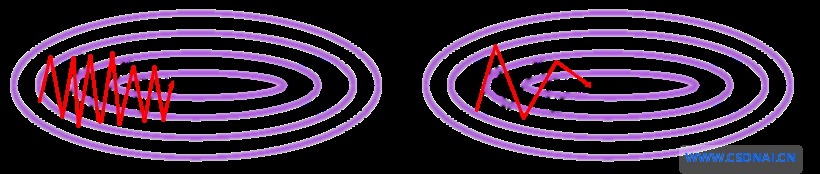
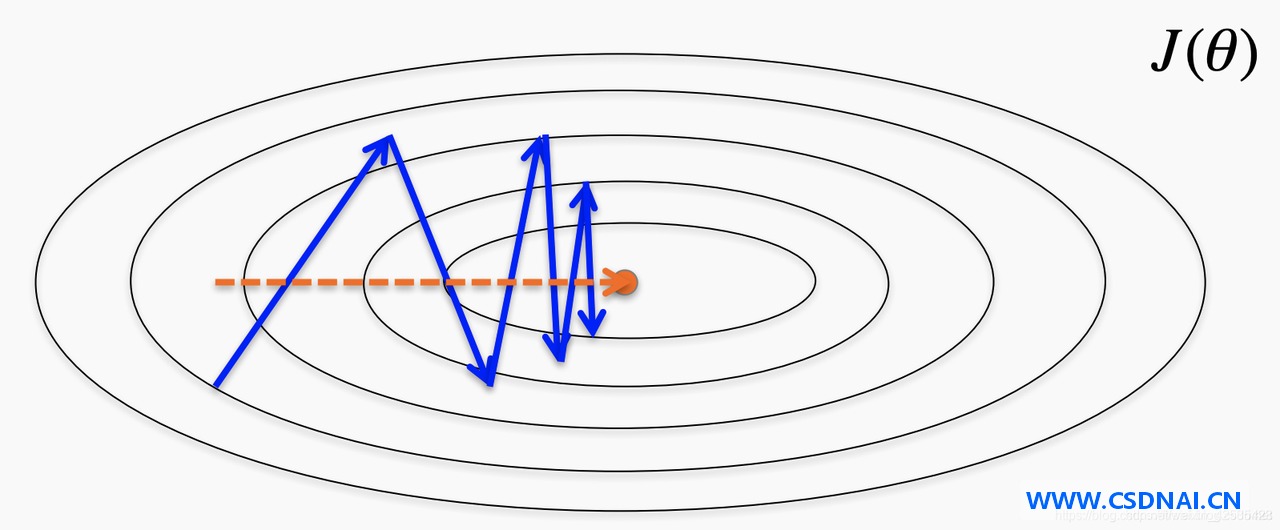
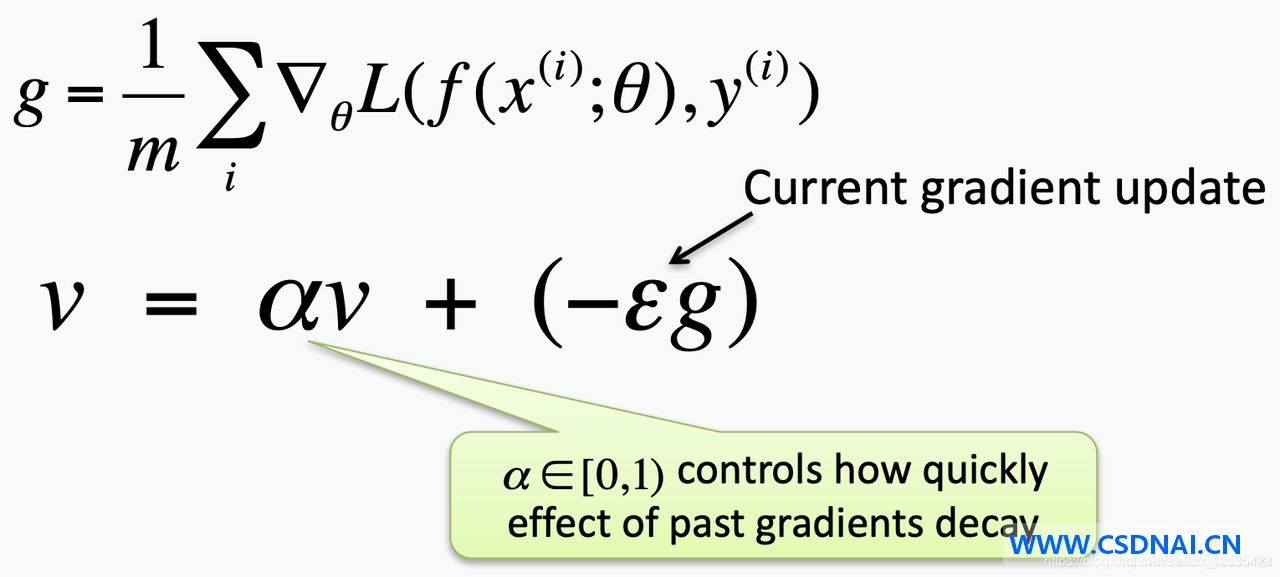
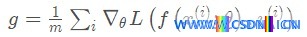
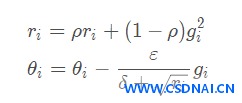
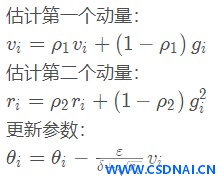
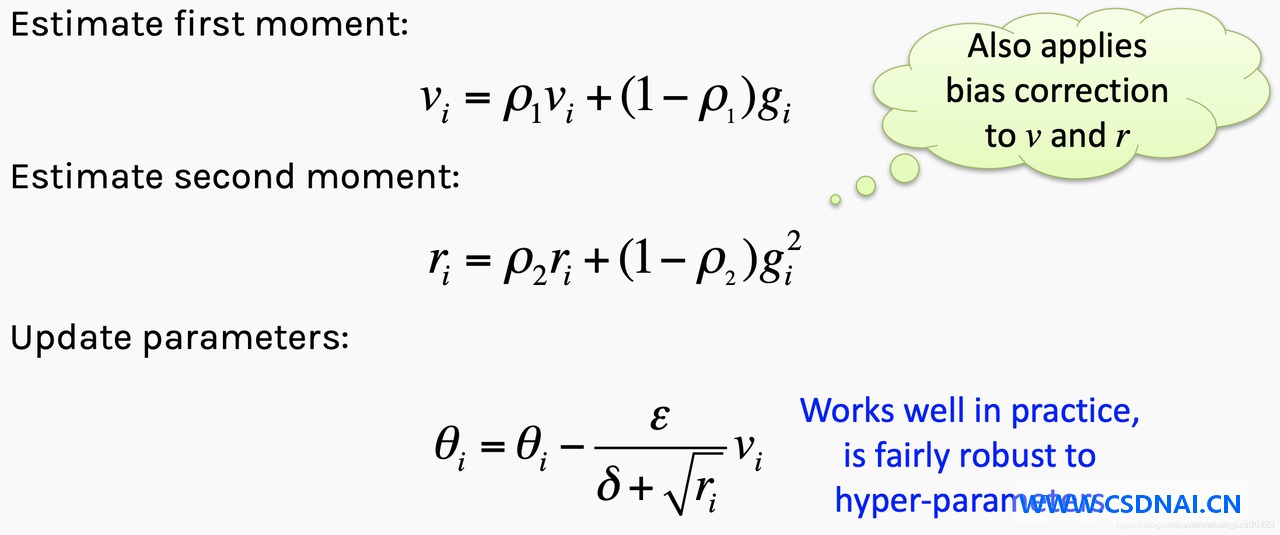
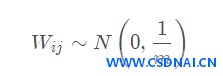
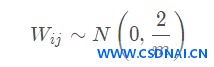
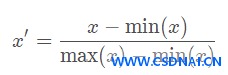
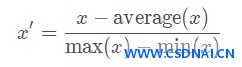
前几次更新看不出比原始SGD有明显优势,因为没有之前的梯度可用。随着更新次数增加,动量开始起作用,收敛更快。
Nesterov动量:先看路再迈步
Sutskever、Martens等人在2013年的论文On the importance of initialization and momentum in deep learning里对Nesterov动量做了详细研究。
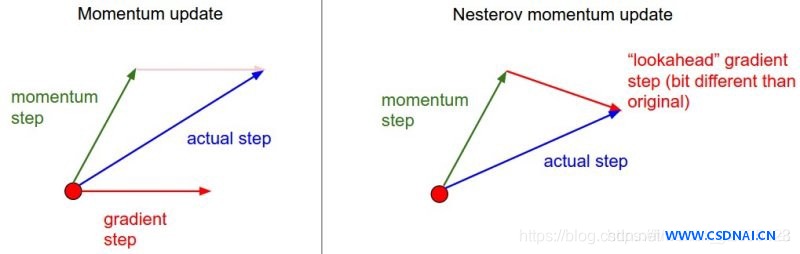
经典动量的做法是:先修正速度,再按速度大步前进,然后重复。Nesterov动量反过来:先按当前速度方向更新位置,再在新位置修正速度矢量,然后重复。差别很微妙,实际效果可能差很多。
自适应学习率:每个参数走自己的步长
沿垂直方向的振荡意味着参数2的学习率必须慢一些。能不能给每个参数用不同的学习率?
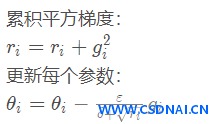
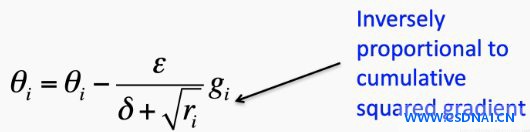
Adagrad让更新适应每个单独的参数,根据参数的重要性决定更新幅度。它的好处是不用手动调学习率,在平缓倾斜的方向上能获得更大进步。
Adagrad的缺点是分母里累加平方梯度。每个加法项都是正数,累加和在训练中不断攀升,学习率持续下降,最终变得无限小,算法不再学到新东西。
RMSProp用指数加权平均做梯度累积,解决非凸问题中Adagrad学习率过早降低的问题。
Adam是RMSprop和动量的组合,Nadam是RMSprop和Nesterov动量的组合。Adam指自适应矩估计,是当前最流行的神经网络优化器。它为每个参数计算自适应学习率,除了存储过往平方梯度的指数衰减均值,还保留历史梯度的指数衰减平均值,类似动量。
参数初始化:别让网络一开始就歪了
前面讲的是怎么在损失曲面上导航。现在换个角度,看怎么操纵网络本身来帮助优化。
权重初始化是训练神经网络的重要一步,却常被忽略。初始化不好,网络性能会受拖累。
把所有零值初始化会怎样?网络根本学不到东西。梯度更新之后,所有权重仍然是零。
那把所有权重都设成0.5呢?网络能学到一些东西,但神经单元之间的对称性被过早固定了。
通常的做法是按正态分布随机分配权重,避免对网络结构做任何预设。Keras里通过指定随机状态来实现,随机状态保证结果可重复。
初始化数值边界选多少?权重太大会梯度爆炸,太小会梯度消失。存在一个最佳折中点,但无法先验知道,只能反复试验。
Xavier初始化与He Normal初始化
Xavier初始化是一种简单的启发式方法。目标是让每层经过后方差保持一致,防止信号爆炸到高值或消失为零。权重从零均值和特定方差的分布中抽取。对于有m个输入的完全连通层,m有时叫fan-in,即输入神经元数量。
这是启发式方法,没有特别的理论支持,只是经验上表现不错。
He Normal初始化和Xavier初始化基本一致,区别在于方差乘以两倍。权重初始化考虑前一层的大小,有助于更快更有效地达到全局最小值。权重仍然是随机的,但边界取决于前一层神经元数量。这带来受控的初始化,梯度下降更快更有效。对ReLU激活函数,推荐用He Normal。
Bias初始化:多数情况设为零
权重需要随机初始化来打破对称性,Bias怎么处理?
最简单也最常用的做法是把Bias设为零,因为对称性破坏已经由权重中的随机数提供了。对ReLU非线性,有人喜欢给所有Bias设一个较小常量,比如0.01,确保所有ReLU单元一开始都触发,从而获得并传播梯度。但这能否带来一致改进并不清楚,更常见的做法还是设为零。
Bias初始化的一个主要问题是避免隐藏单元内的初始化饱和。在ReLU中,可以通过把偏置初始化为0.1而不是零来缓解。
预初始化:站在别人的肩膀上
预初始化是另一种权重初始化方式,在图像处理的卷积网络中很常见。做法是导入已经训练好的网络权重,比如VGG 16,用作待训练网络的初始权重。
这其实就是迁移学习。但只对与训练网络相似的数据可行。VGG 16是为图像分类开发的,如果你要分析图像但数据集样本很少,预初始化是个可行选择。预初始化和迁移学习不一定是同义词。
批归一化:从数据层面帮优化
前面讲了用动量和自适应学习率导航损失曲面,也讲了参数初始化。现在看怎么操纵数据本身来帮助模型调优。
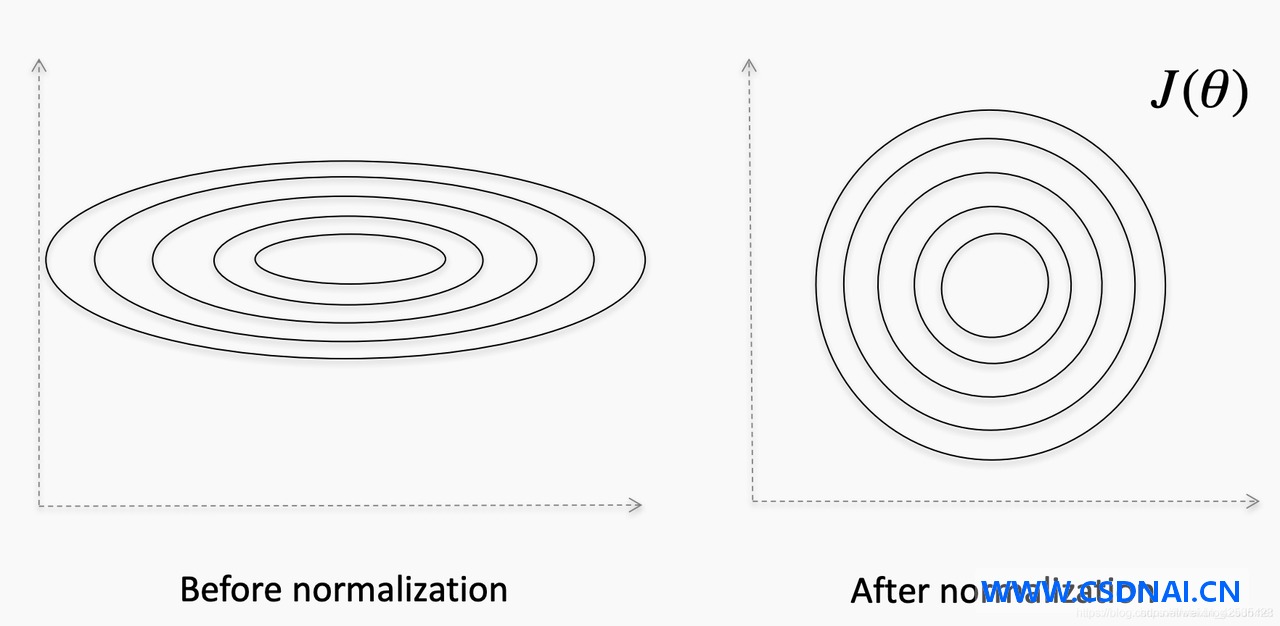
特征归一化就是在应用优化算法之前对特征做归一化,通常在预处理阶段完成。Batch Normalization那篇论文指出,使用特征缩放比不使用能更快地梯度下降并收敛。
常见缩放方法有几种。min-max normalization缩放到[0,1]或[-1,1],每个值减去最小值再按数据边界缩放。数据分布高度不均匀时,很多值会聚集在一处,这时可以用特征变量的对数来缓解,因为对数有让异常值柔和的趋势。
mean normalization和min-max normalization基本一致,只是从每个值中减去均值。
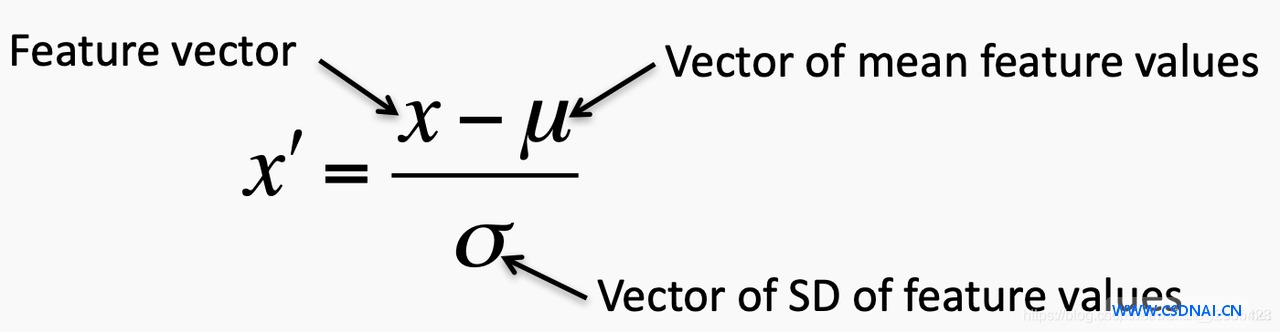
特征标准化让每个特征的值具有零均值和单位方差。先确定每个特征的分布均值和标准差,从每个特征中减去均值,再除以标准差。这在基于距离的机器学习算法中广泛使用。
归一化改进了数据集的distortion,让数据更均匀。
内部协方差平移
这个概念来自Batch Normalization那篇论文。作者的定义是:Internal Covariate Shift指训练过程中网络参数变化导致网络激活分布的变化。
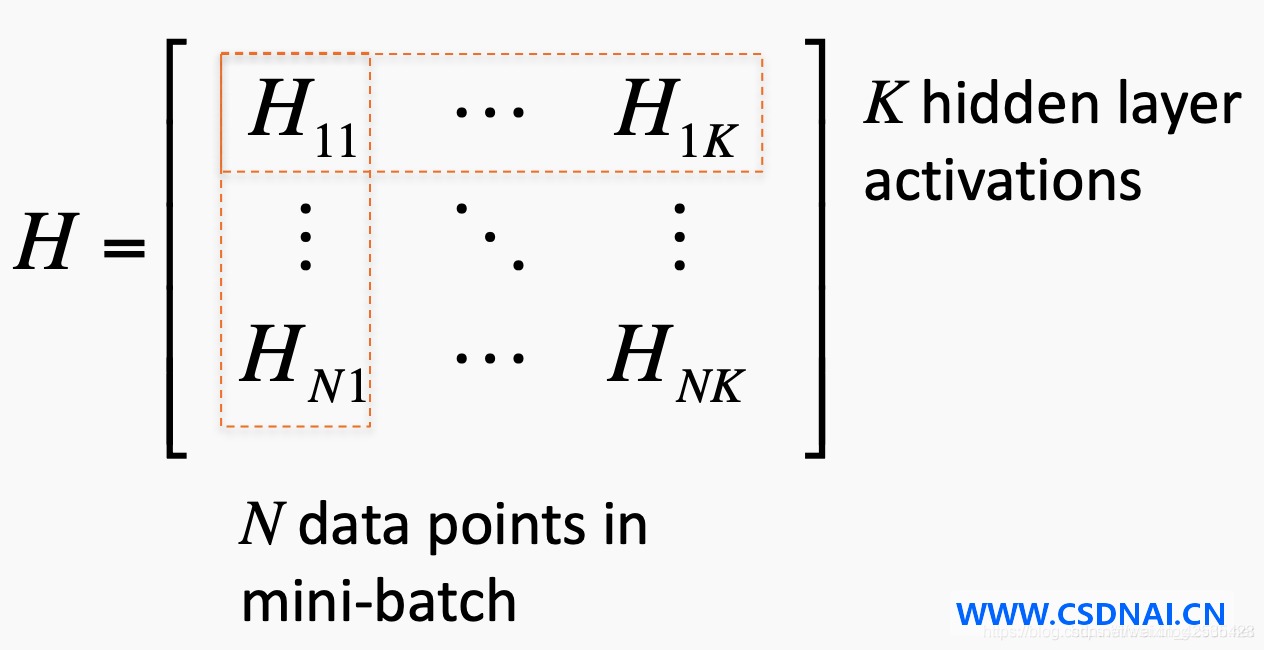
解释一下:第一层输出进入第二层,第二层输出进入第三层。当某层的参数改变,后续层的输入分布也跟着变。这种输入分布的变化会减慢训练速度,在深层网络中尤其明显。
如果输入已经被白化,即零均值、单位方差且不相关,训练会更好。内部协变量平移导致相反的效果。批归一化就是为减轻内部协变量平移而设计的。
批归一化怎么工作
批归一化是对神经网络其他层特征标准化思想的扩展。输入层能从标准化中受益,其他层为什么不可以?
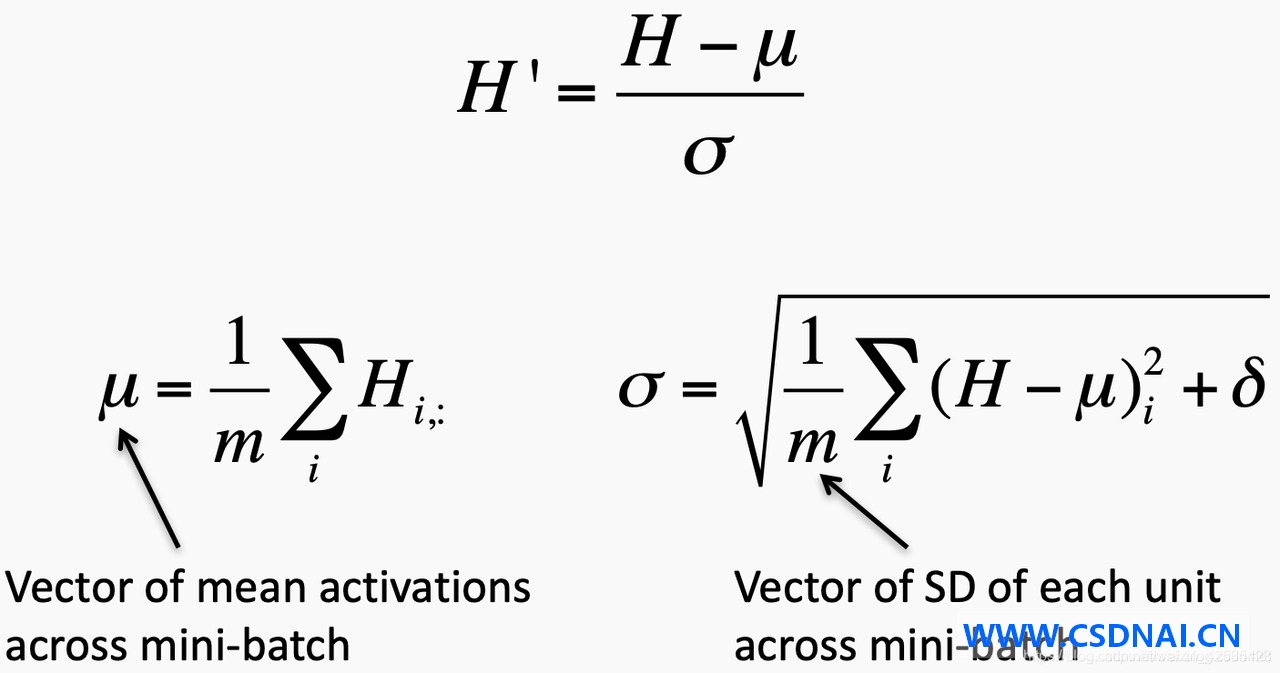
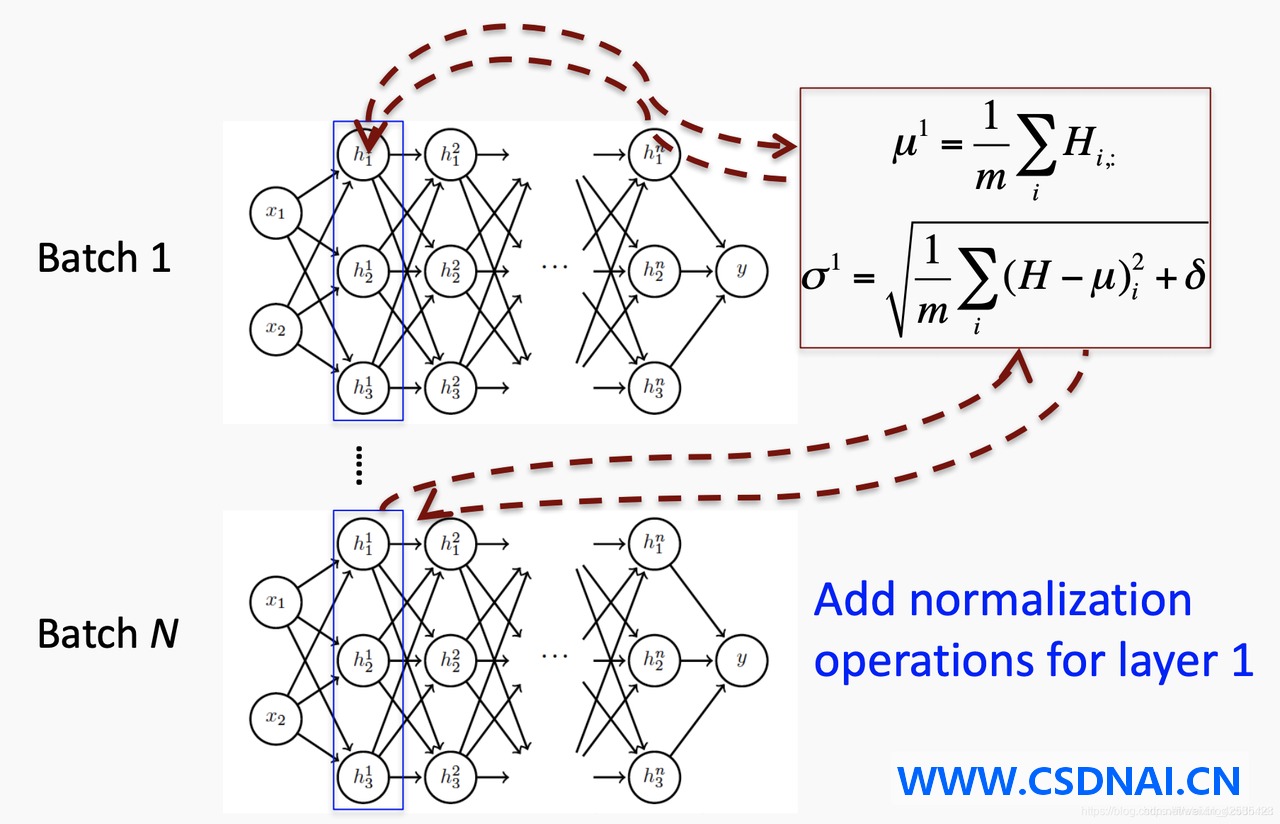
批归一化通过减去批均值和除以批标准差来归一化前一激活层的输出,提高神经网络训练的平稳性。它让每一层可以独立于其他层学习。
但经过随机初始化参数的激活输出做shift/scale之后,下一层的权重不再是最优的。如果SGD是让损失函数最小化的方式,它会取消这个标准化。
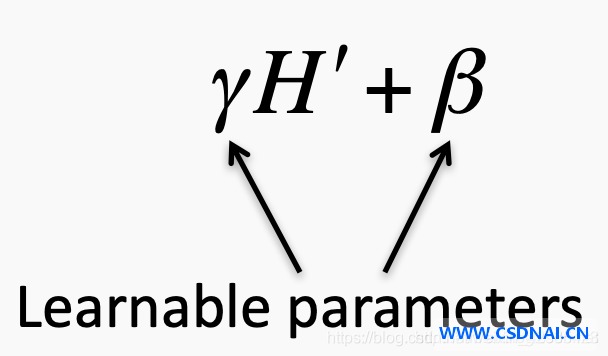
批归一化给每层添加两个可调参数,把归一化输出乘以标准差参数γ。SGD只需为每次激活改变这两个权重来做denormalization,不用改变所有权重而失去网络平稳性。这个过程叫批归一化变换。
具体操作:看输入层之后的第一个隐藏层,对N个小批量中的每一个计算输出的均值和标准差。对所有后续隐藏层重复。然后区分N个迷你批次的联合损失,通过归一化操作反向传播。
批归一化有轻微正则化效果,能压缩过拟合。和dropout类似,它给每个隐藏层的激活添加了一些噪音。
验证期间,均值和标准差替换为训练期间收集的滑动平均值,使用全局统计信息而非小批量统计信息,确保输出确定性地取决于输入。
批归一化的几个好处:压缩internal covariant shift,压缩梯度对参数或初始值比例的依赖;对模型正则化,减少对dropout、光度畸变、局部响应归一化等正则化手段的需求;允许使用饱和非线性和较高的学习率。
几个容易踩的坑
Adam虽然流行,但在某些图像分类任务上泛化不如SGD加动量。如果追求最佳测试精度,SGD加动量配合学习率衰减往往更稳。Adam适合快速原型验证。
批归一化在batch size很小时表现不稳定,因为小批量的均值和方差估计噪声大。这时可以考虑Group Normalization或Layer Normalization。
Xavier初始化适合tanh和sigmoid激活函数,He Normal适合ReLU及其变体。用错了初始化,训练初期就可能梯度消失或爆炸。
梯度裁剪对RNN尤其重要,因为序列长度带来梯度爆炸风险。裁剪阈值通常设在1到5之间,具体值需要根据任务调整。
验证批归一化是否生效,可以观察训练损失曲线。如果加入批归一化后损失下降更平滑、收敛更快,说明起作用了。也可以对比训练集和验证集的准确率差距,批归一化的正则化效果会缩小这个差距。






