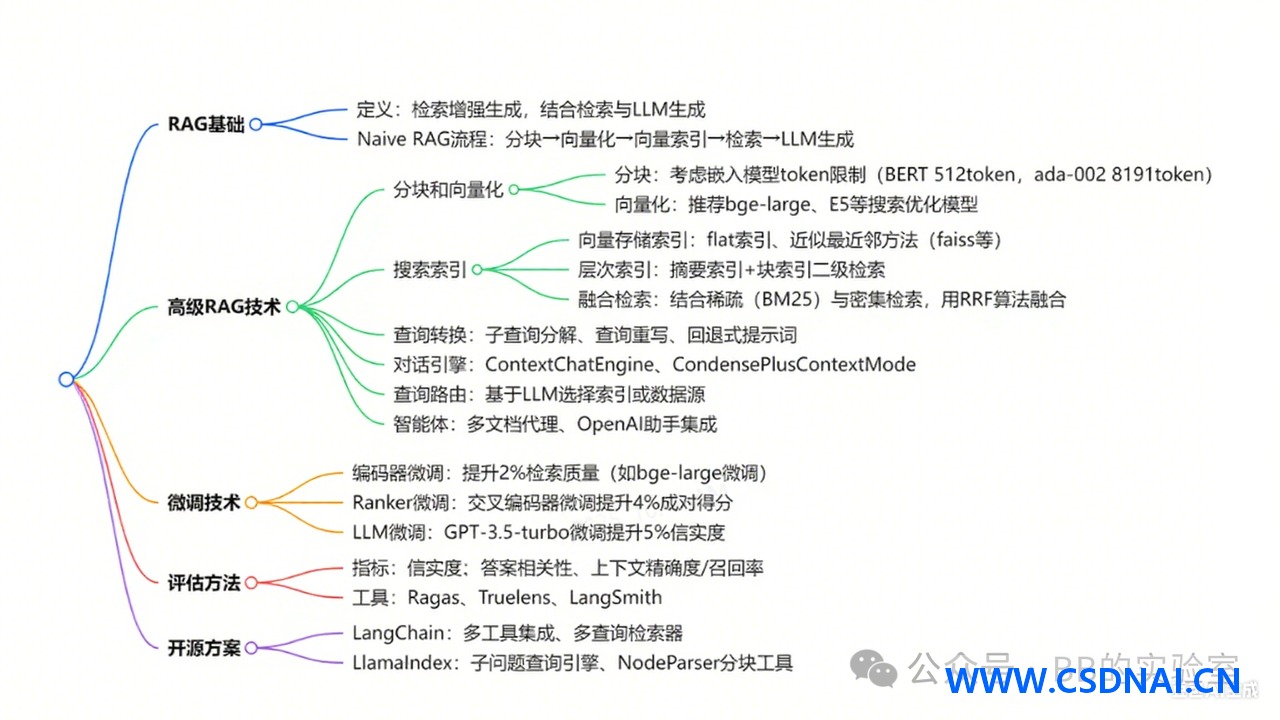
RAG(Retrieval-Augmented Generation,检索增强生成)的核心思路不复杂:在LLM开口回答之前,先从外部文档库里捞出相关资料,再让模型基于这些资料组织答案。这样做能提升准确性、缓解幻觉、加快知识更新,顺带让生成结果可追溯。
但它真正落地时的复杂度,远不是”检索+拼接”四个字能概括的。下面按工程视角拆开讲。
三代架构演进:从线性到可插拔
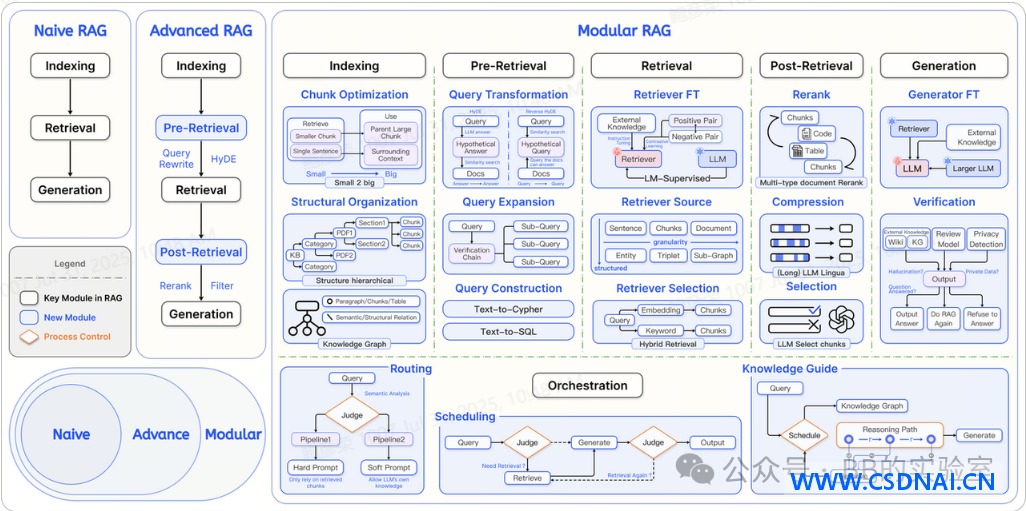
最早期的Naive RAG是一条直线:索引→检索→生成。文档转纯文本、切块、用BM25或TF-IDF建倒排索引;用户提问后做关键词匹配召回Top-K,直接拼进提示词交给模型。
问题很明显。关键词匹配抓不住语义,”自动驾驶事故责任”未必能召回”AI算法缺陷”的文档;拼接的上下文里混入无关段落,模型注意力被打散;检索不全时,模型又退回去用自己过时的内部知识编答案。
Advanced RAG针对这几点做了补强:用Sentence-BERT、DPR这类模型生成稠密向量,靠余弦相似度提升召回;索引端引入滑动窗口,把文档切成有重叠的细粒度块(如200字/块)保住语义连续性;召回后用交叉编码器重排序,再用摘要模型压缩上下文。生成侧则靠结构化提示强制模型依据检索内容,并加一道事实核查比对回答与资料的一致性。
Modular RAG把系统彻底拆成可插拔模块:索引模块支持文档→章节→段落的多级结构和知识图谱;预检索模块负责查询重写和多查询扩展,比如把”血糖控制”扩成饮食、运动、药物三个维度的问法并行检索;后检索模块做迭代检索(生成→检索→再生成)和结构化解析;编排模块用状态机或LLM动态选路。多模态、动态路由、长期记忆都在这一层展开,比如法律咨询优先查法条库、医疗问题优先查临床指南。

检索器与生成器:两个组件的职责边界
RAG架构只有两个核心角色。检索器是信息搜索引擎,负责从外部语料里找出最相关的内容;生成器是语言综合器,负责把原始问题和检索到的上下文揉成一个连贯回答。
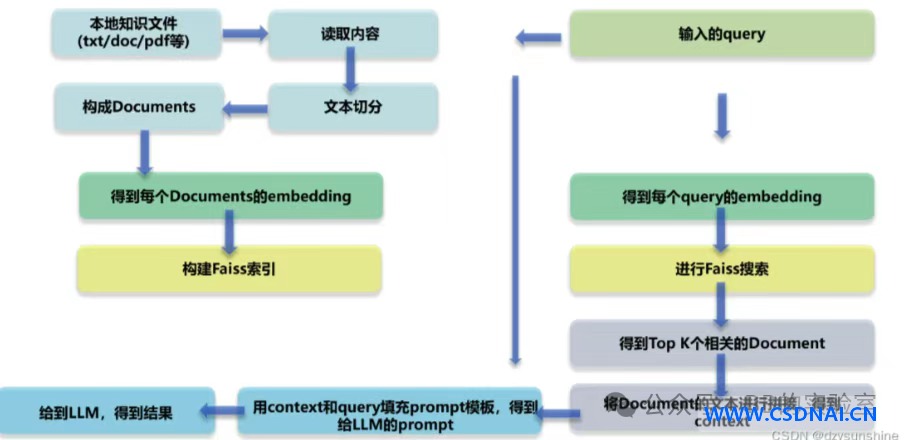
检索器的工作分三步。第一,把PDF、文本、数据库记录等语料预处理、切块,每块经嵌入模型转成数值向量,存进向量数据库(Pinecone、Chroma、FAISS等)。第二,用户查询用同一个嵌入模型转成向量,通过余弦相似度等度量找到最近的文档向量。第三,把原始提示和命中的文档块文本一起交给生成器。
这里有个容易被低估的点:检索器质量直接决定上限。捞回来的文档不相关,生成器再强也只能产出垃圾。
生成器通常是预训练LLM(GPT-4、Llama 3、T5等)。它拿到的增强提示结构长这样:
retrieved_context = """Document 1: RAG检索器通过将文档和查询转换为嵌入向量工作...
Document 2: 像Pinecone这样的向量数据库使用近似最近邻算法..."""
user_query = "RAG系统中的检索器如何工作?"

final_prompt = f"""使用以下上下文回答问题。若答案不在上下文中,请说明未知。

上下文:{retrieved_context}
问题:{user_query}"""
注意最后那句”若答案不在上下文中,请说明未知”——这是降低幻觉的关键约束,别省。
标准LLM的短板在于知识固化在参数里,更新困难且容易编造。RAG用非参数化记忆(外部可更新的数据源)补上这块,参数化记忆提供通用智能,非参数化记忆提供事实依据,两者配合。
数据索引:分块策略决定检索质量
索引从数据提取开始。数据Loader负责吃进PDF、Word、Markdown以及数据库和API数据;数据处理环节做格式清洗、剔除无法识别的内容、压缩格式化;元数据提取同样关键,文件名、时间、章节title、图片alt这些信息后面过滤和溯源都要用。
分块(Chunking)是最容易踩坑的一步。固定大小切分常见的是256/512个token,具体取决于嵌入模型的能力。但这种切法会切断语义——”我们今天晚上应该去吃个大餐庆祝一下”很可能被切成”我们今天晚上应该”和”去吃个大餐庆祝一下”,检索效果直接受损。缓解办法是留冗余:512 token的块实际只存480 token,让相邻块的头尾内容有重叠。
基于意图的分块更讲究。句分割靠句号和换行处理,也可以用NLTK、spaCy这类意图包;递归分割用分治思路一路切到最小单元;还有面向特殊场景的专用切法。
选哪种策略取决于四件事:索引内容的类型和长度(文章和微博推文切法差异极大)、所用LLM的token限制(ChatGLM、ChatGPT、Claude的窗口长度不同)、问答文本的长度和复杂度(问答长度和块尺寸接近时检索效率更友好)、以及应用类型(检索、问答、摘要各有偏好)。
向量化(embedding)把文本、图像、音频、视频转成向量矩阵,让计算机能处理。嵌入模型的好坏直接决定检索相关度。常见选择:BGE是国人在MTEB上排名靠前的中文模型;M3E也是国产,按场景选用;通义千问的嵌入模型是1500+维;OpenAI的text-embedding-ada-002是1536维,在国内可用性受限;也可以基于既有模型自训练,通常能带来3%-10%的性能提升。
查询编码、增量索引与混合检索
DPR用两个独立的Transformer编码器(通常源自BERT)分别处理查询和文档。查询编码器把输入查询x转成单个稠密向量,每个维度代表学到的文本特征;段落编码器对语料中每个文档d做同样的事,关键在于文档嵌入是预先算好存进索引的,推理时检索极快。
训练目标是让语义相关的查询和文档在共享向量空间里靠得更近:最大化查询嵌入与相关段落的点积相似度,同时压低与无关段落的相似度。
索引更新有两条路。Delta Indexing只处理上次索引后变化的数据,快、省资源,但要额外维护跟踪变化的结构,更新量大时会变复杂,适合更新频繁且量小的场景。Full-Indexing重刷整个数据集,简单、一致性好,但成本高、耗时长,适合数据变化不频繁或对准确性要求极高的场景。工程上按业务更新频率和资源情况权衡。
不同存储的增量能力差别很大:FAISS自带index.add()增量加向量,但持久化和合并要手动保存或重构;Elasticsearch/OpenSearch原生支持增量索引,新文档直接写分片;Milvus、Weaviate、Vespa支持实时插入和查询。
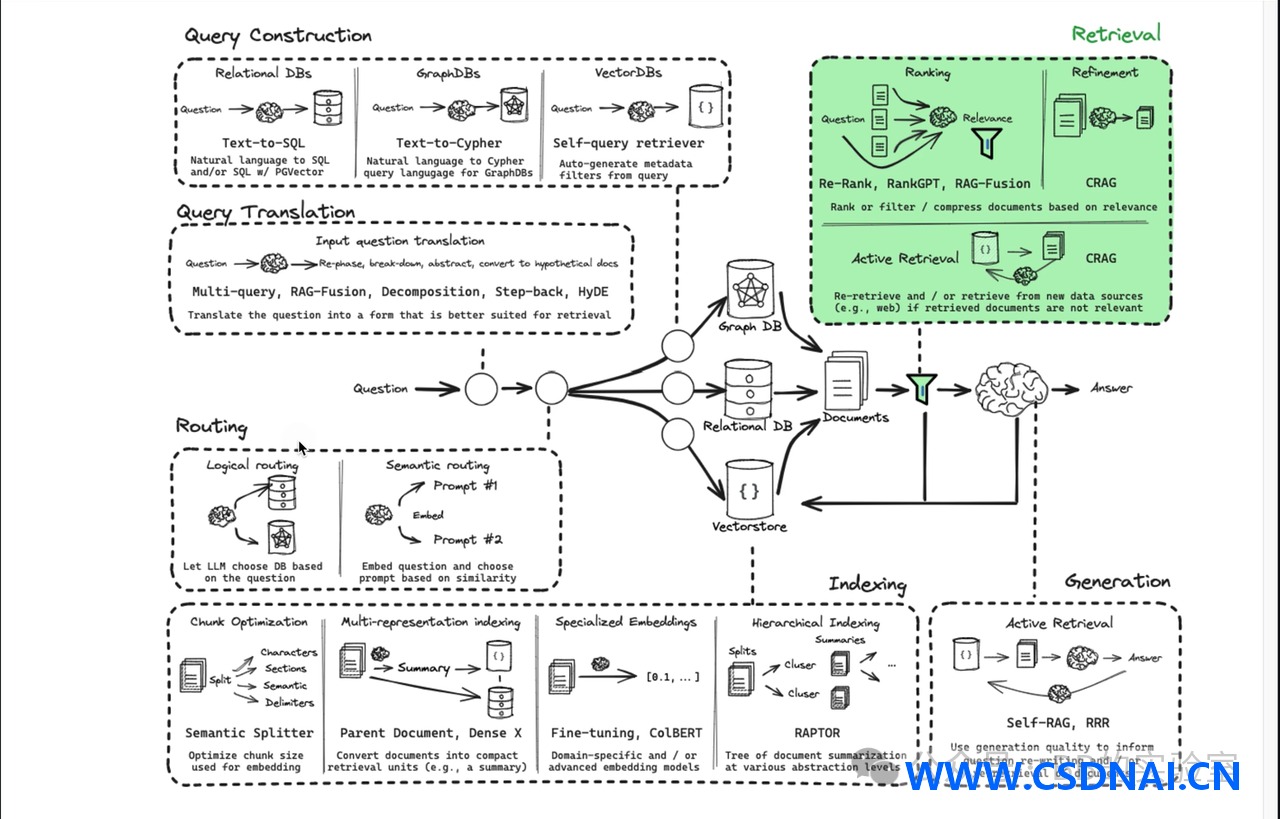
查询重写是提升性能的关键一环。查询扩展让LLM对原始查询做多次改写,生成多个变体后并行检索,覆盖语义多样性——这对向量检索和关键词检索都有帮助,BM25需要更多同义词和变体词才能命中更多文档,向量检索也需要更完整明确的语义。
伪相关反馈(PRF)是另一种扩展方式:拿原始查询检索到的顶部文档当”伪相关”文档,从中提取新查询项拼接到原查询上(q’ = Concat(q, LLM(prompt q)))。风险在于,如果初次检索因查询写得差而不够相关,结果会更糟。实验显示CoT/PRF提示通常表现最好。
常见做法包括同义词扩展(”医生执业证”改成”医生执业证 OR 医师资格证 OR 行医证”)、查询补全(”巴黎”补成”巴黎 法国 首都 历史 景点”)、多轮对话上下文补全(”那他的出生地呢?”补成”爱因斯坦的出生地”),以及生成多个改写版本分别检索后合并结果。
混合检索与FAISS高效搜索
单一检索方式各有短板。BM25靠词频和IDF评估相关性,精确匹配强但抓不住语义;向量检索(HNSW、IVF-PQ等)把文本转高维向量用余弦相似度度量,能捕捉概念相关但用词不同的文档。混合检索把两者输出融合,在复杂查询场景下通常比单用任一种更稳。
面对数百万文档向量,暴力计算最高点积相似度不可行。FAISS构建专用索引结构,用量化和分区技术实现最大内积搜索(MIPS),速度远快于穷举,能在亚线性时间内找到前k个最相似向量,支撑实时检索。
用DPR加FAISS搭检索器的核心逻辑如下:
import torch
from transformers import DprContextEncoder, DprContextEncoderTokenizer
from transformers import DprQuestionEncoder, DprQuestionEncoderTokenizer
import faiss

# 1. 加载预训练DPR模型和分词器
ctx_tokenizer = DprContextEncoderTokenizer.from_pretrained("facebook/dpr-ctx_encoder-single-nq-base")
ctx_encoder = DprContextEncoder.from_pretrained("facebook/dpr-ctx_encoder-single-nq-base")
question_tokenizer = DprQuestionEncoderTokenizer.from_pretrained("facebook/dpr-question_encoder-single-nq-base")
question_encoder = DprQuestionEncoder.from_pretrained("facebook/dpr-question_encoder-single-nq-base")

# 2. 创建虚拟知识语料库
knowledge_corpus = [
    "埃菲尔铁塔是巴黎战神广场上的锻铁格子塔。",
    "中国长城是一系列由石头、砖块和其他材料建造的防御工事。",
    "光合作用是植物用来将光能转化为化学能的过程。",
]

# 3. 预计算文档嵌入(实际应用中仅需计算一次并存储)
with torch.no_grad():
    ctx_inputs = ctx_tokenizer(knowledge_corpus, return_tensors="pt", padding=True, truncation=True)
    passage_embeddings = ctx_encoder(**ctx_inputs).pooler_output
print(f"文档嵌入形状: {passage_embeddings.shape}")  # (文档数量, 嵌入维度)

# 4. 构建FAISS索引
embedding_dim = passage_embeddings.shape[1]
index = faiss.IndexFlatIP(embedding_dim)  # 精确最大内积搜索索引
index.add(passage_embeddings.numpy())     # 向索引添加文档向量

# 5. 执行搜索
query = "什么是埃菲尔铁塔?"
with torch.no_grad():
    question_inputs = question_tokenizer(query, return_tensors="pt")
    question_embedding = question_encoder(**question_inputs).pooler_output
D, I = index.search(question_embedding.numpy(), k=2)  # 搜索前2个最相似段落
print("检索结果:")
for i in range(len(I[0])):
    print(f"排名{i+1}: 文档 '{knowledge_corpus[I[0][i]]}',得分{D[0][i]}")
细化排序:把最相关的顶到前面
FAISS和BM25的打分都比较粗——只看向量相似度或词频匹配,混合检索也只是把两个粗排结果合并,噪声仍在。细化排序用更复杂的深度模型做精细语义判断。
Cross-Encoder把查询和文档拼在一起输入单塔模型,直接输出相关性分数,精度高但速度慢,只能用于最终重排。DistilBERT、MonoBERT等轻量版准确率略降但更快。融合排序则把初排分数(FAISS/BM25)与重排分数加权得到最终顺序。
ColBERT走的是另一条路。它采用双编码器策略,查询和文档分别用独立编码器编码,文档编码可离线完成,查询时只编码Query,速度远高于Cross-Encoder。同时它通过延迟交互机制(late interaction)结合BERT的上下文表示,能捕捉查询和文档间的复杂关系,在保持高效推理的同时完成检索和重排序。
选型建议:对延迟敏感的在线服务优先考虑ColBERT这类双塔方案,离线或小规模重排可以上Cross-Encoder换精度。
生成器输入构建与完整工作流
检索器拿到前k个相关文档后,生成器要把它综合成单一连贯回答。RAG常用预训练的seq2seq模型,BART是常见且有效的选择——它的双向编码器加自回归解码器架构很适合这个任务,去噪预训练让它在处理”查询+多个检索文档拼接”这种复杂输入时尤其擅长重建信息。
生成器的输入构造方式是把原始查询x加到每个检索文档dᵢ内容之前,格式大致为:[CLS] 查询 [SEP] 文档1标题 [SEP] 文档1文本 [SEP] 文档2标题 [SEP] 文档2文本 …
BART解码器逐token生成答案,每一步都关注完整输入序列,既能从原始查询提取上下文,又能把回答锚定在检索文档的事实上。这种对外部知识的直接依赖,让RAG输出比标准LLM更具事实性,幻觉率明显下降。
from transformers import RagTokenizer, RagRetriever, RagSequenceForGeneration

tokenizer = RagTokenizer.from_pretrained("facebook/rag-sequence-nq")

query = "什么是埃菲尔铁塔?"

retrieved_docs = [
 {
 "title": "Eiffel Tower",
 "text": "The Eiffel Tower is a wrought-iron lattice tower on the Champ de Mars in Paris."
 },
 {
 "title": "Champ de Mars",
 "text": "The Champ de Mars is a large public greenspace in Paris, France, located in the seventh arrondissement."
 }
]

retrieved_doc_texts = [doc['text'] for doc in retrieved_docs]
retrieved_doc_titles = [doc['title'] for doc in retrieved_docs]

分词器处理查询与文档拼接
prepared_inputs = tokenizer.prepare_seq2seq_batch(
 src_texts=[query] * len(retrieved_doc_texts), # 每个文档均关联同一查询
 doc_texts=retrieved_doc_texts,
 return_tensors="pt"
)

查看解码后的输入格式
for i in range(len(retrieved_doc_texts)):
 print(f"\n--- 生成器输入(文档{i+1}) ---")
 print(tokenizer.decode(prepared_inputs['input_ids'][i], skip_special_tokens=False))
完整工作流串起来是这样:
用户提交自然语言问题(如”Python中如何实现快速排序?”)。检索器接收查询,基于DPR这类稠密检索或BM25这类稀疏检索,从维基百科、领域数据库或文档集合中返回Top-K相关片段。
上下文与查询融合:把查询和上下文拼成[Query] [SEP] [Context]等格式,高级方案会用Cross-Attention增强两者的语义关联。
生成器处理:Encoder-Decoder模型(T5、BART)编码输入后生成输出,Decoder-only模型(GPT系列)自回归生成。模型结合预训练语言知识和输入上下文,理解意图并产出内容。
生成过程:自回归逐词预测适合Decoder-only,序列到序列映射适合Encoder-Decoder。解码策略上,贪婪搜索取概率最高的词,束搜索保留多个候选提升质量,Top-k或Nucleus采样增加多样性。
后处理:事实验证检查生成内容与检索上下文是否一致,减少幻觉;格式化按任务需要输出简洁答案或详细解释。
整套流程里,索引质量、检索召回、重排精度、生成约束四环相扣,任何一环松了,最终答案都会露馅。






