被领导叫进办公室训了二十分钟,起因是部门那套知识库系统没人用。五年积累的技术文档、故障手册、规范流程,全躺在那里当摆设。关键词搜索搜“服务器宕机怎么办”,返回一堆含“服务器”三个字的文档,真正有用的那篇排在第三页。新同事宁可群里@人问,也不愿去查。
领导拍板:你不是研究大模型吗,搞个智能问答出来。
我拍胸脯应了。第一版上线三天就被打回来——用户问公司MySQL主从切换流程,模型答得头头是道,内容全是编的,跟公司实际流程毫无关系。这就是幻觉。当时我对RAG的理解还停留在“把文档丢进去就行”,太天真。后面花三周重构,系统成了部门标配,月活从0涨到200多。踩过的坑记录如下。
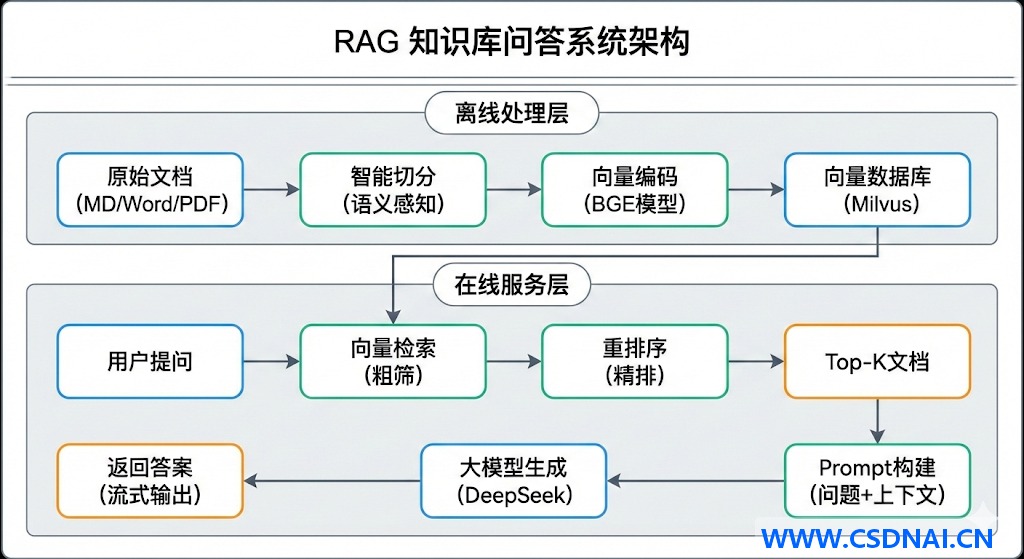
RAG补的是模型的两个短板
大模型有两个硬伤。一是知识有截止日期,不知道公司上周发的新规范。二是遇到不知道的问题不会老实说不知道,而是拿通用知识编一个看起来合理的答案。
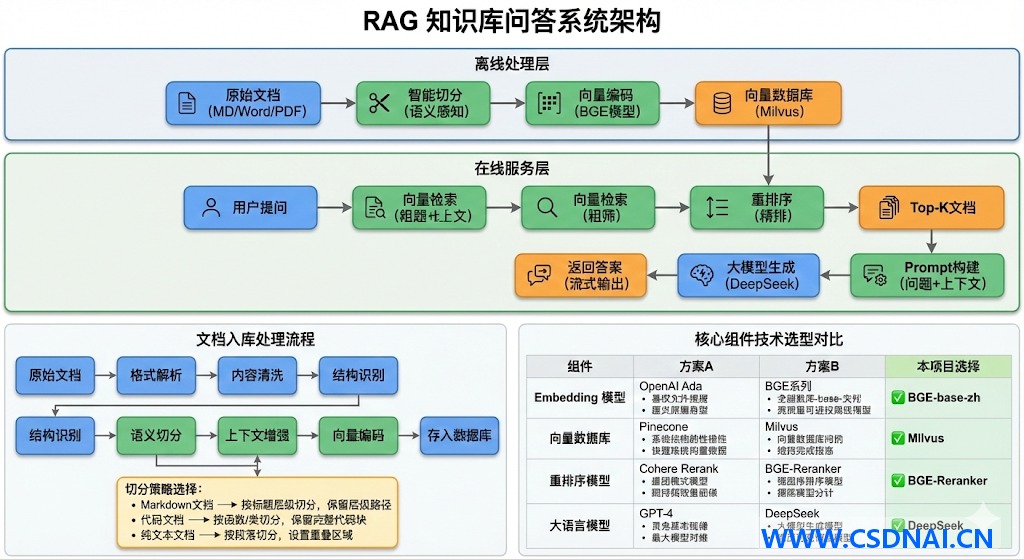
RAG的思路很直接:别让模型靠想象力答题,先把参考资料找出来,让它照着材料回答。流程分三步——私有文档切块转向量存起来;用户提问时检索最相关的片段;把问题和片段一起喂给模型生成答案。
听着简单。坑全在细节里。
切分:机械按字数切会切断语义
最初用 RecursiveCharacterTextSplitter,chunk_size=500、overlap=50,一把梭。代码几行就写完了:
from langchain.text_splitter import RecursiveCharacterTextSplitter

def naive_split(text):
 splitter = RecursiveCharacterTextSplitter(
 chunk_size=500,
 chunk_overlap=50,
 separators=["\n\n", "\n", "。", "!", "?", ",", " "]
 )
 return splitter.split_text(text)
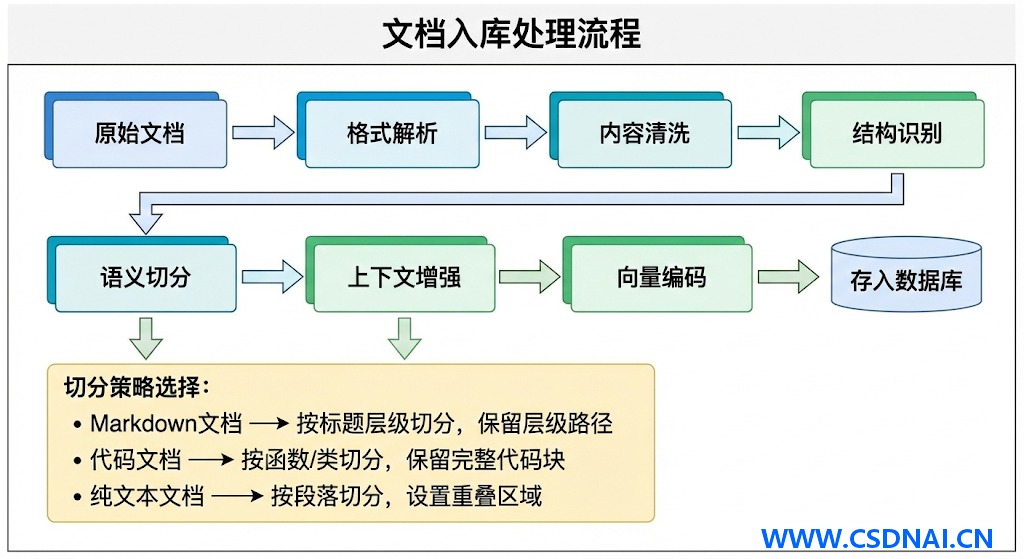
实际用起来出了事。用户问“MySQL切换前需要做哪些检查”,返回的片段恰好从检查清单中间切开,第一条“确认从库同步状态正常”被切进了上一个chunk。用户问检查项,参考资料里第一条检查项却缺席了。
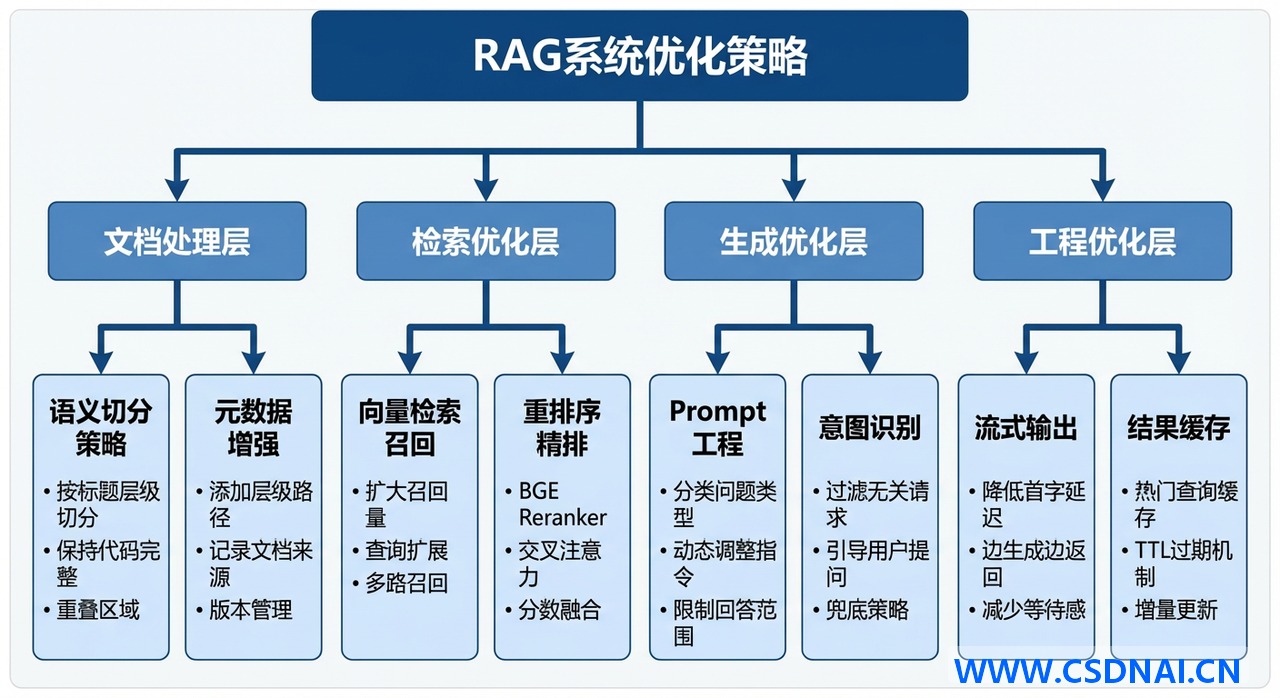
改成按Markdown标题层级切分,每个chunk带上完整上下文路径,比如“MySQL主从切换 > 前置检查”。这样即使片段单独拿出来,模型也知道它属于哪个章节。核心逻辑是识别 #{1,3} 标题、维护当前层级字典、内容超长时优先在段落边界强制切分,最后给每个chunk拼上 [文档路径:xxx] 前缀。
格式不规范的老文档没有清晰标题结构,这套方案效果依然一般,后来按文档类型做了差异化处理。
检索:口语化提问和正式文档之间有语义鸿沟
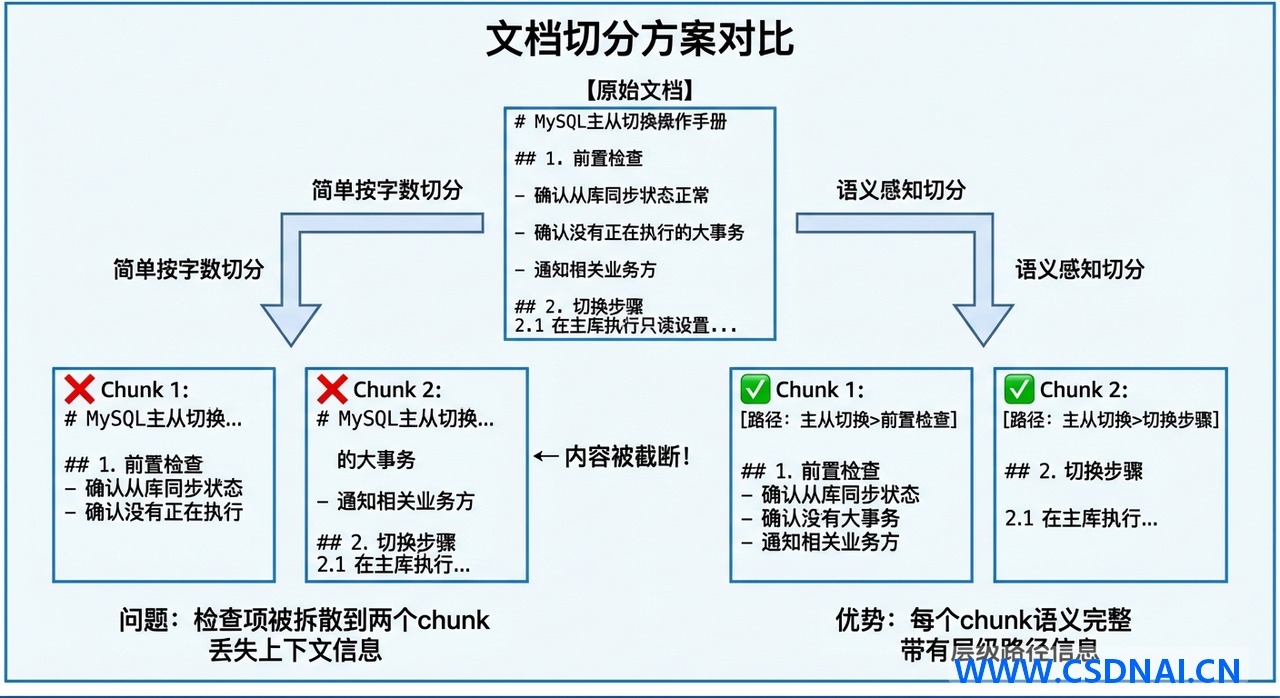
向量化用BGE,向量库用Milvus。第一版检索就是纯向量Top-K,问题很快暴露:用户说“数据库挂了”,文档标题是“MySQL服务异常恢复操作手册”,语义相关但向量相似度不高。更麻烦的是Top 5里真正相关的那篇常排第三第四,只取Top 3就漏了关键信息。
这里有个原文没提但必须注意的点:BGE系列模型对query和文档的编码不是对称的。检索query需要加指令前缀,官方推荐 为这个句子生成表示以用于检索相关文章:,文档侧则不加。两边用同一套编码方式,召回率会明显下降。这个细节在 bge-base-zh-v1.5 和 bge-large-zh-v1.5 上都成立,换成 bge-m3 则不需要前缀,直接对称编码即可。版本选型时别搞混。
解决方案是两阶段检索:向量粗筛召回20个候选,再用 BAAI/bge-reranker-base 精排取Top 5。重排序模型输入是 [query, document] 对,输出相关性分数,max_length=512、truncation=True。
另一个有效手段是查询扩展。让大模型把“数据库挂了怎么办”改写成三到五个不同表述,分别检索后合并结果,被多个查询命中的文档加权。命中次数乘最高得分做综合排序,覆盖面明显变宽。
Milvus这边有个部署期高频报错值得单独说。集合插入数据后如果不 load() 就检索,会直接抛 collection not loaded。正确姿势是插入并 flush() 之后调用 collection.load(),检索完如果内存吃紧再用 utility.release_collection() 释放。另外 nprobe 参数只对 IVF_FLAT 这类索引有效,如果建的是 HNSW 索引,传 nprobe 会报参数不识别,得换成 ef。索引类型和检索参数必须配对,这是新手最容易栽的地方。
Prompt:指令塞太多模型反而顾此失彼
检索搞定,Prompt这步本以为最简单,结果也翻车。最初版本就一句“根据以下参考资料回答用户问题”,三个毛病:资料里没有答案时模型照样编;不标注来源,用户没法追溯;复杂问题回答结构混乱。
迭代后的生产版Prompt做了几件事:明确角色是企业内部知识库助手;硬性要求只用参考资料、没有就说“根据现有资料无法找到”并建议联系相关部门;要求标注【资料X】;操作类问题按步骤列,概念类先给定义再展开;资料冲突时指出差异。
有个重要经验:别在一个Prompt里堆太多指令。一开始把准确、简洁、友好、专业、标来源、分步骤、不确定要说不知道全写进去,模型反而被绕晕。后来拆成核心指令(任何情况必带)和按问题类型动态附加的格式指令——操作类要求编号步骤和⚠️警告标记,概念类要求一句话定义加展开,排查类要求先列原因再给排查方法。问题类型用关键词粗分类就够用,怎么做/如何操作/步骤 归操作类,是什么/定义/区别 归概念类,为什么/报错/失败 归排查类。
多轮对话场景还要带最近五轮历史,并提示模型处理代词指代。
意图识别:用户不按套路提问
上线后遇到大量非知识库问题。“上次那个事故怎么处理的来着”——没有上下文,系统不知道指哪个事故。“帮我写个SQL”——这是代码生成需求。“在吗”——纯闲聊。
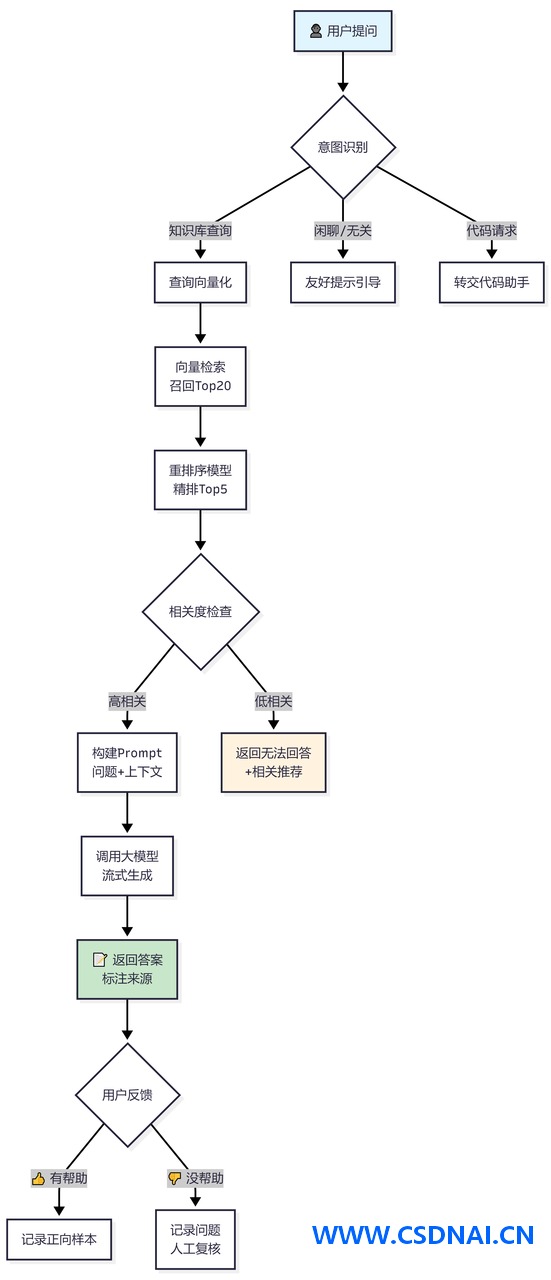
加了一层意图识别,用LLM判断输入属于 knowledge_query、code_request、chitchat 还是 other,非知识库意图给友好提示而不是硬检索。max_tokens 设小一点,只要类别名。
冷启动也有坑。文档少、覆盖窄,用户问几个答不上来就不来了。对策是上线前梳理高频问题确保能答好,加问题收集功能把答不上的反馈给内容团队补文档,检索不到高相关内容时展示相似度尚可的文档标题做兜底推荐。
文档更新同步同样麻烦。老版本手册废弃了但向量库里还留着,用户会检索到过时信息。方案是入库时记录版本号和更新时间,每周全量重建,紧急更新的重要文档支持单篇手动重入库。
性能:流式输出比优化检索更管用
整条链路跑一遍——编码、检索、重排、生成——好几秒,用户等得难受。做了几件事:query embedding 用 lru_cache 缓存,相同问题不重复算向量;热门查询结果加TTL缓存;LLM调用开 stream=True 流式输出,首字符延迟降到0.8秒左右,用户看到回答在打字,心理等待感大幅下降。
完整Pipeline的组装顺序是:文档切分入库 → 检索(向量粗筛+重排精排)→ 按意图和问题类型构建Prompt → 调LLM生成 → 提取引用来源返回。temperature 设0.1,知识库问答不需要创造性。返回结构里带上 answer、sources、retrieved_docs,方便前端展示引用和后续排查。
适用边界与上线后的真实数据
RAG适合有明确知识库、答案可追溯的场景。如果需求是让模型发挥创造力写文案做创意,RAG反而是约束。切分和检索是根基,前面做不好,换再强的模型也是巧妇难为无米之炊。Prompt工程没有捷径,多试多迭代。
目前日均查询200多次,平均响应2.3秒,流式首字符约0.8秒,点赞率约72%,无法回答比例约22%——这部分定期分析推动补文档。数字不算亮眼,但比没人用的关键词搜索已是质变。
ID:7141







