被领导叫进办公室训了二十分钟,起因是一套没人用的知识库。公司五年的技术文档、故障手册、规范流程全堆在里面,搜索却只认关键词。你输入”服务器宕机怎么办”,返回一堆含”服务器”三个字的文档,真正管用的那篇躺在第三页。新同事宁可群里@人,也不愿打开它。
领导问我:你不是天天研究大模型吗,搞个能直接问答的东西出来。我拍了胸脯。第一版上线三天就被打回——有人问公司 MySQL 主从切换流程,模型答得条理清晰,内容全是编的,跟我们实际流程毫无关系。
这就是幻觉。我当时的理解停留在”把文档丢进去就行”,太天真。后面花了近三周重做,系统现在月活两百多,季度会上被点名表扬。下面把重构过程和技术细节摊开讲。
先搞清楚 RAG 补的是哪块短板
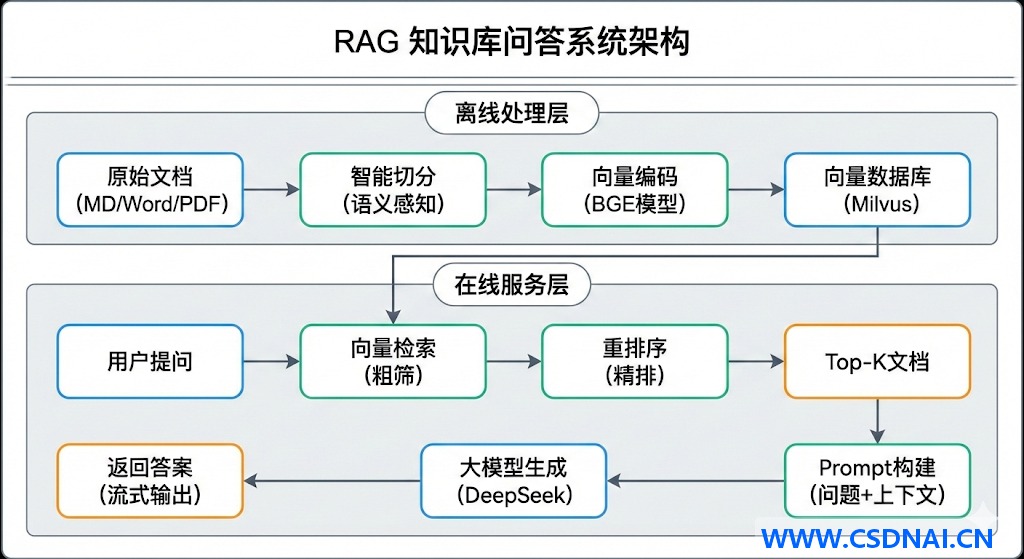
大模型有两个硬伤。一是知识有截止时间,你们公司上周发的规范、昨天修的 bug,它一概不知。二是遇到不知道的事不会老实说不知道,而是拿通用知识拼一个看起来合理的错误答案。
RAG 的思路是把”查资料”和”写答案”拆开:先从你的私有语料里检索出相关片段,再把片段作为上下文喂给模型,让它基于给定材料作答。检索负责事实,生成负责表达。检索这一环做不好,后面全是空中楼阁——我第一版就死在这里。
检索层才是命门,索引配置别照抄教程
第一版我用的是最朴素的方案:文档按固定字数切块,全部向量化塞进向量库,查询时取 top-k。问题很快暴露:切块把一张表格从中间劈开,上下文断了;top-k 取 5 条,其中三条是同一段落的重复片段,真正相关的反而没进来。
向量库选型上,小团队用 pgvector 最省事,跟业务库同源,运维成本低。但索引类型要分清:pgvector 0.5.0 起支持 HNSW,召回和延迟都明显优于早期的 IVFFlat,代价是建索引慢、内存吃得多。HNSW 的两个关键参数,M 控制每个节点的连接数,efConstruction 控制建索引时的候选集大小。M 调大召回上升但内存线性增长,efConstruction 调大建索引更慢、查询质量更好。数据量在十万级以内,M 取 16、efConstruction 取 64 是安全起点,别一上来就拉满。
如果语料规模到百万级、对延迟敏感,专用向量库更合适,但要多一套服务要养。选型没有标准答案,看团队运维能力。
分块不是切香肠,按结构走
固定长度切块是最省事也最坑的做法。我改成按文档标题层级切:一级标题下的内容作为一个父块,二级标题作为子块,检索命中子块时把父块一起带进上下文。这样既保证片段聚焦,又不丢上下文。
块之间留 10% 到 15% 的重叠,防止一句话被切断。代码块和表格单独成块,不参与文本切分,避免结构被破坏。这一步做完,检索命中率肉眼可见地上升。
怎么证明它真的变好了
光靠感觉不行。我建了一个固定问题集,从真实工单里挑 50 个高频问题,每个问题人工标注出正确答案所在的文档段落。每次改动检索策略,跑一遍这个集合,统计两个指标:命中率,即 top-5 结果里是否包含标注段落;答案忠实度,即模型输出是否只引用了检索到的内容。
校验命令层面,用脚本批量调接口,把每条结果和标注比对,输出命中率报表。命中率低于 80% 就别急着上线,先回去调分块和索引参数。这套流程让我在第二周定位到问题根源:不是模型不行,是检索压根没把对的段落捞出来。
重排和查询改写,用对场景才有效
检索回来的 top-k 片段顺序未必靠谱。加一层重排模型,对候选片段重新打分,能显著提升相关性。但重排有延迟成本,每次查询多几十到上百毫秒,对交互式问答可以接受,对高并发批量场景就不划算。
查询改写同理。用户问”主从切换咋整”,直接拿这句话去检索效果一般,先让模型把它改写成”MySQL 主从切换操作步骤”再检索,命中率会好很多。但改写本身也调模型,多一次调用就多一份延迟和费用。我的做法是只在首轮检索命中率低于阈值时触发改写,做二次检索,兼顾效果和成本。
提示词里必须写死约束
检索到材料只是第一步,模型照样可能自由发挥。系统提示词里我明确要求:只依据提供的上下文回答,上下文没有的信息直接说”文档中未找到相关内容”,禁止推测。同时要求输出时标注引用来源的文档标题和段落,方便用户核对。
这条约束加上检索质量提升,幻觉基本被压住了。偶尔模型还是会润色过度,但至少事实来源可追溯,用户能自己判断。
上线之后的事
系统稳定运行后,我加了查询日志分析,每周看哪些问题检索命中率低,反过来补充和修订知识库文档。RAG 不是一锤子买卖,语料质量和检索策略要持续迭代。现在这套东西成了部门标配,但真正让它好用的不是某个模型,是检索层那些不起眼的工程细节。
ID:6926







