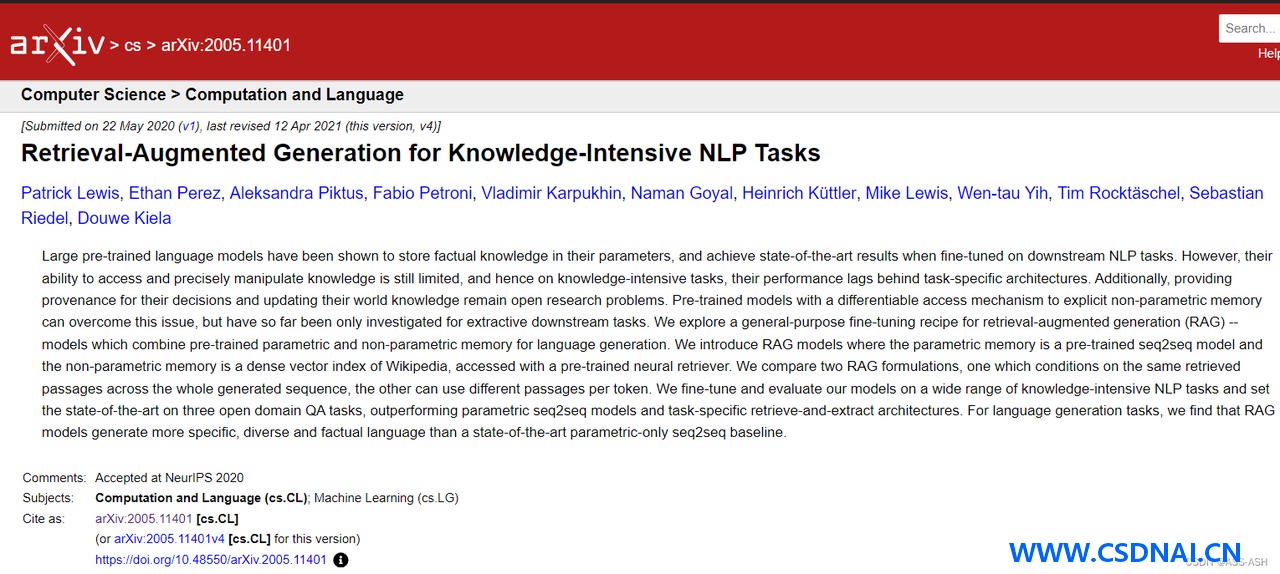
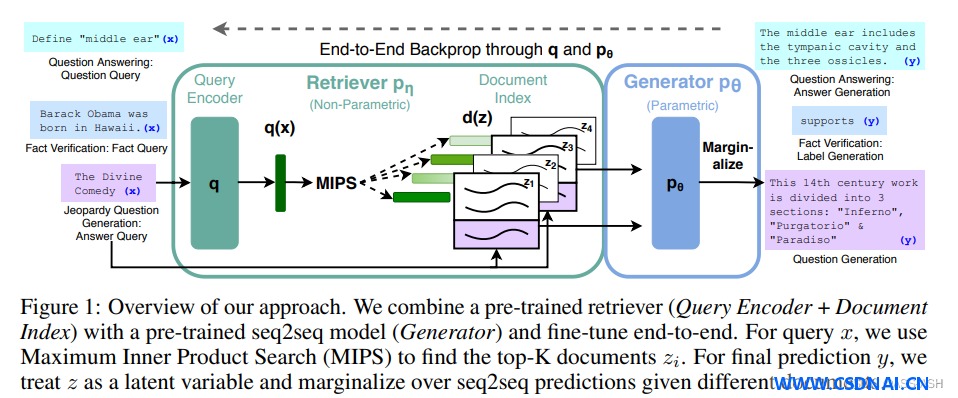
把大模型的参数知识想象成闭卷考试背下来的东西,RAG 就是允许它带资料进考场。考的是推理,不是记忆。事实性知识从权重里剥离出来,放进可随时更新的外部知识源,模型只负责读懂资料再作答。这套思路由 Lewis 等人在 2020 年的论文中系统提出(arXiv:2005.11401),检索器与生成器解耦,知识维护成本从”重训模型”降到”更新索引”。
为什么需要外挂知识
LLM 有三个绕不开的短板。其一是幻觉:输出本质是概率采样,语言通顺和事实正确是两回事,模型自己也没有校准能力。其二是知识时效:训练语料有截止日期,越大的模型重训越贵,靠持续预训练追新不现实。其三是数据安全:企业不可能把私有数据喂给公网模型,私有化部署能解决这一条,但前两条还得靠 RAG。
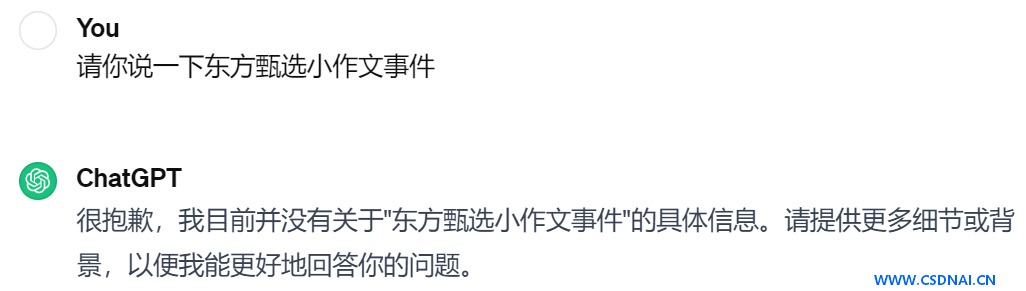
微调是另一条路,能注入领域知识,代价是算力密集、需要标注数据,且知识一变就得再训一轮。RAG 的优势在于知识更新只是重建索引,不动模型权重。
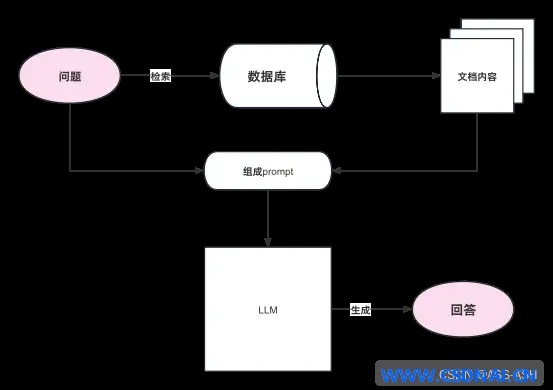
两阶段流程:离线建库与在线问答
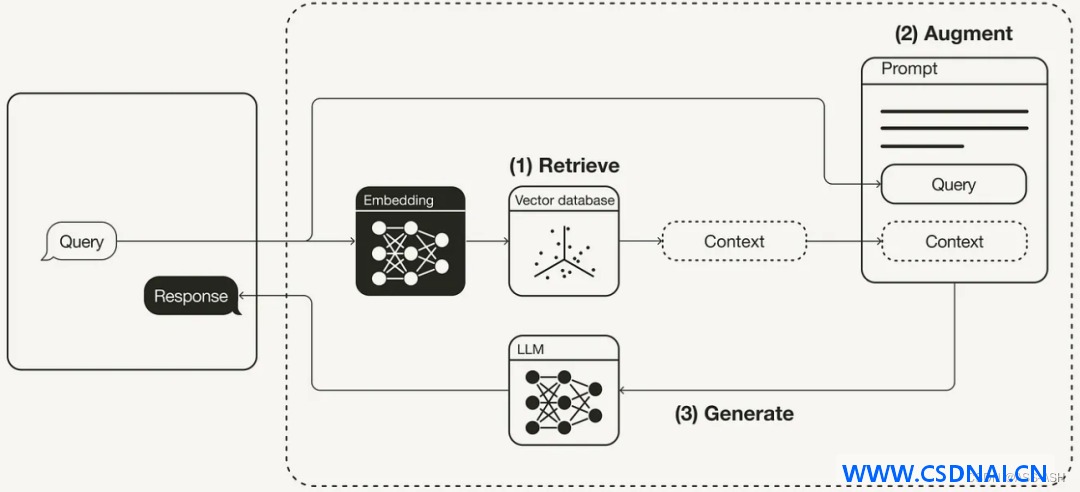
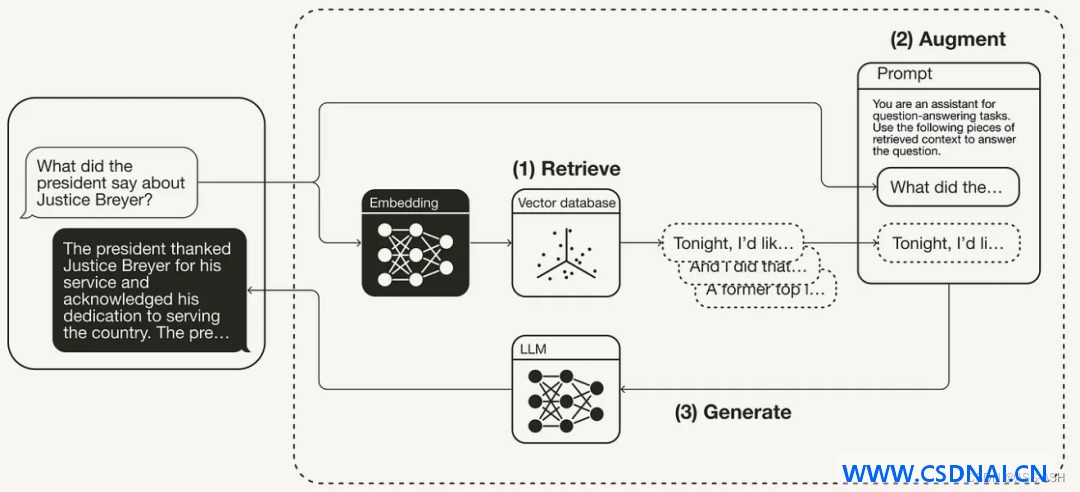
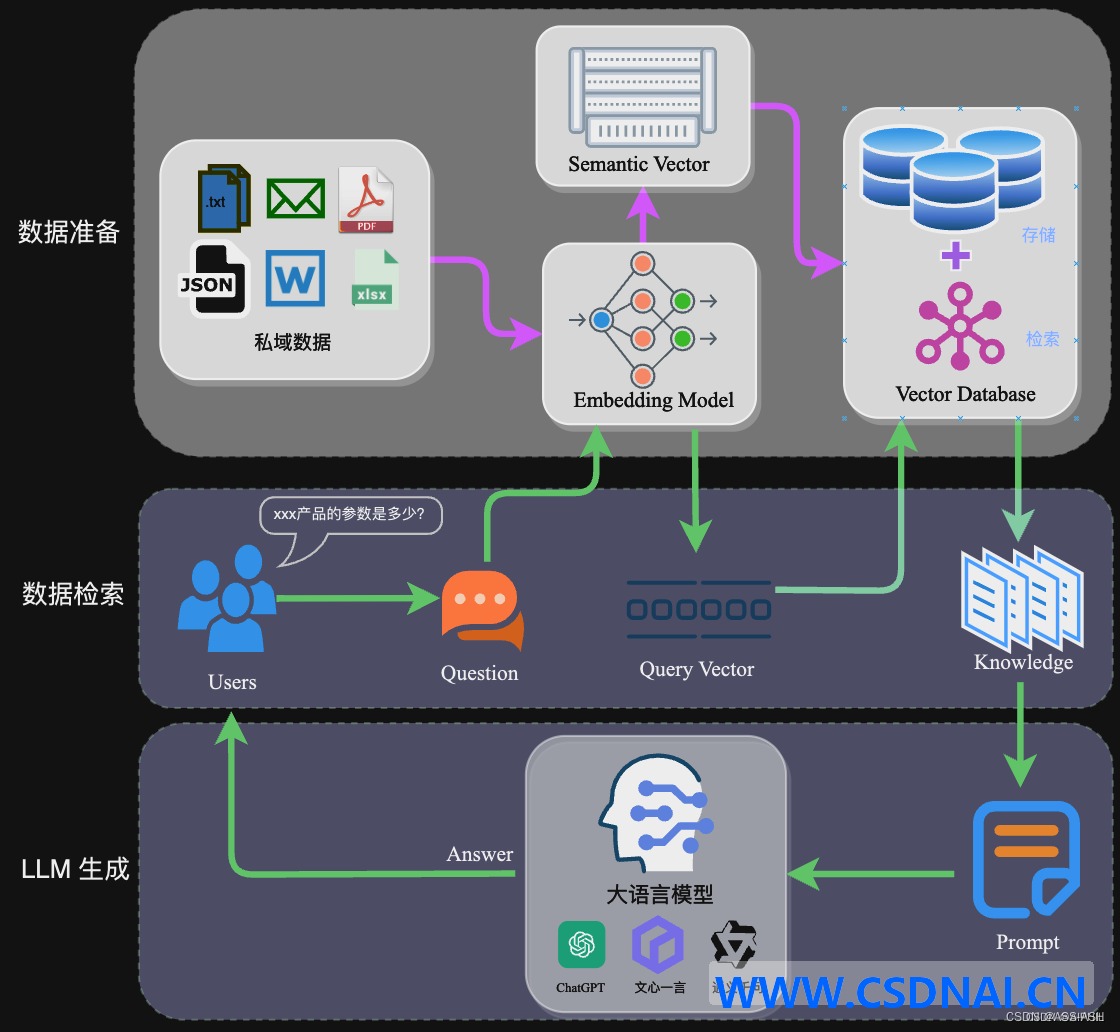
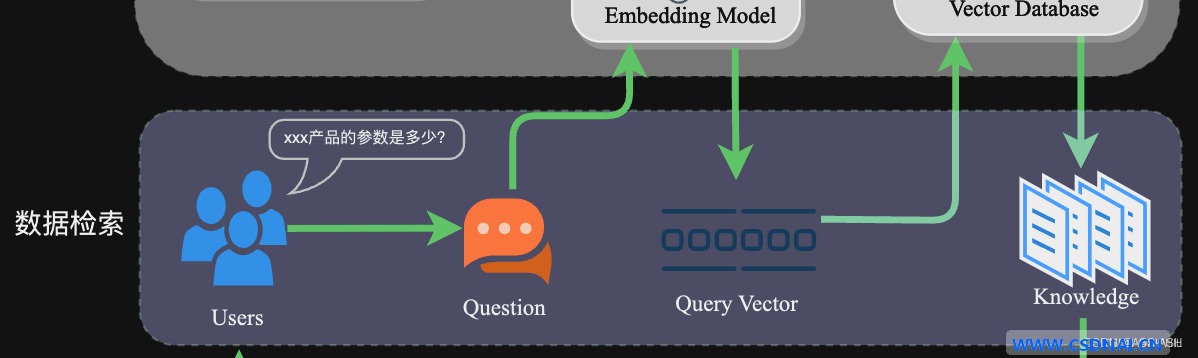
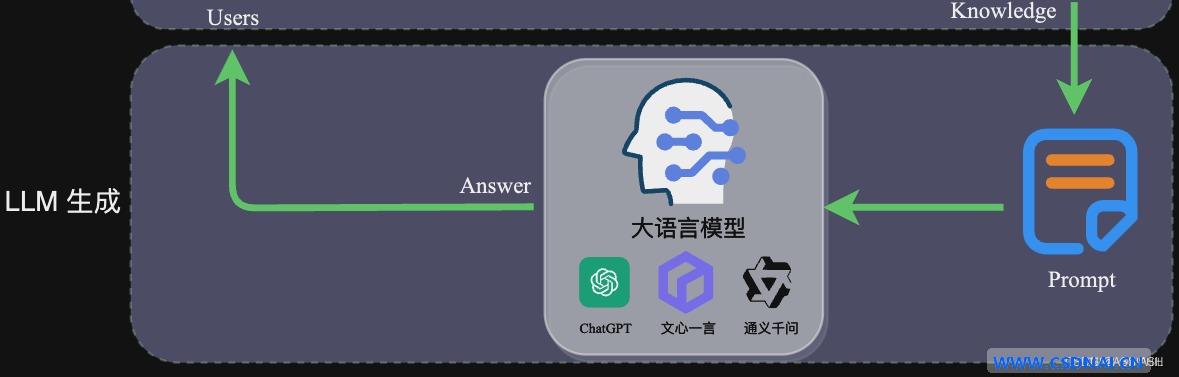
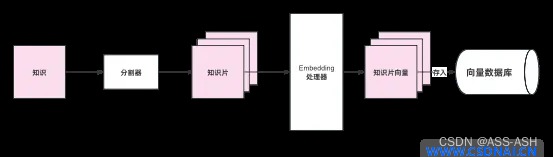
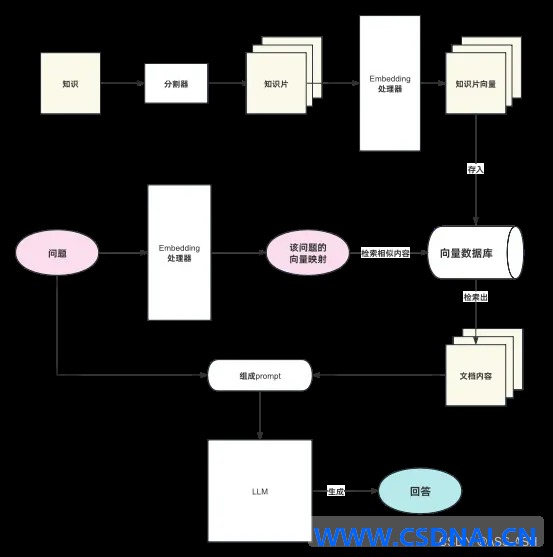
完整链路分两段。离线段:数据提取、文本分割、向量化、入库。在线段:提问、召回、拼 Prompt、生成。
数据提取环节做三件事:多格式加载并归一化、过滤压缩格式化、抽取元数据(文件名、标题、时间戳)。元数据别丢,后面做过滤检索和结果溯源全靠它。
文本分割要平衡两个约束:embedding 模型的 token 上限,以及切得太碎导致的语义断裂。常见做法是按句切(句号、问号、感叹号、换行符),或按固定 token 数切(256 或 512),固定长度切法会丢语义,一般靠首尾冗余重叠来缓解。工程上 overlap 取 chunk 长度的 10% 到 20% 是常见起点,但别照抄,得用问题集实测召回效果再定。
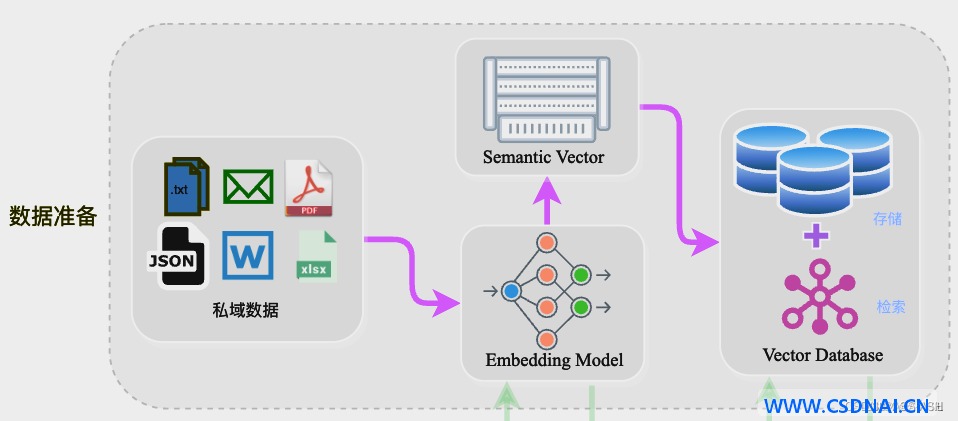
向量化直接决定检索质量。通用 embedding 模型能覆盖大部分场景,遇到罕见专有词或垂直领域术语,效果会掉,这时可以微调开源 embedding 模型,或直接训练贴合业务的模型。这里有个容易踩的坑:换了 embedding 模型,旧索引必须全量重建,因为不同模型产出的向量空间不兼容,混用等于拿两套坐标系做距离比较,召回结果毫无意义。
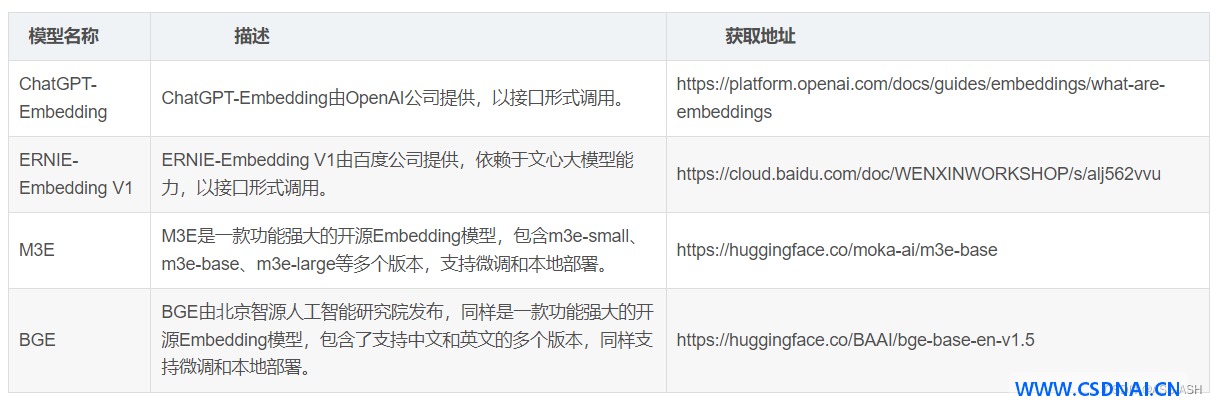
入库选型看规模。百万级以内、单机内存够用,FAISS 最省事;已有 PostgreSQL 栈、数据量中等,pgvector 能少维护一套组件;千万级以上或需要多副本高可用,上 Milvus 这类分布式向量库。用 HNSW 索引时,M 控制每个节点的连边数,efConstruction 控制建索引时的候选集大小,两者调大能提召回率,代价是内存和建索引时间上涨,生产环境要按召回率指标反推参数,别默认值一把梭。
检索不止一种打法
相似度检索是主力:把问题 embedding 成向量,在库里找距离最近的 top-k 片段,距离度量用余弦或欧氏,取决于模型训练时的约定。但纯向量检索对精确匹配不友好,比如产品型号、订单号这类字符串,关键词检索反而更准。企业数据大量躺在关系型库里,SQL 检索同样不可缺。实践中常见做法是多路召回后融合排序,提升整体召回率。
Prompt 组装是生成质量的关键闸门。典型结构是任务描述加背景知识加用户问题,背景知识位置填入检索到的文本。Prompt 设计没有统一语法,靠经验迭代,得盯着模型实际输出反复调。一个客服问答的骨架大致如下:
【任务描述】
假如你是一个专业的客服机器人,请参考【背景知识】回答【问题】

【背景知识】
{content} // 数据检索得到的相关文本

【问题】
石头扫地机器人P10的续航时间是多久?
这套方案的边界在哪
RAG 的效果上限由知识库质量决定。语料脏、索引粗、检索不准,模型再强也答不好,检索环节是木桶最短的那块板。上下文窗口也是硬约束,召回内容超长只能截断,一次能喂给模型的事实有限。延迟方面,检索加拼 Prompt 比裸问答多出两跳,对毫秒级响应敏感的场景要谨慎评估,必要时做缓存或异步预取。
反过来说,知识更新频繁、需要溯源引用、数据不能出内网的场景,RAG 是当前性价比最高的选择。选型前先想清楚:你的瓶颈是知识新鲜度,还是模型推理能力?前者 RAG 对症,后者得换更强的模型。
ID:7166







