从工作流拆解RAG的四个可优化面
RAG的完整链路可以拆成四段:文档块切分、文本嵌入、提示工程、大模型生成。中间还夹着一层对召回文档块集合的后处理。每一段都有独立的优化空间,也有各自的坑。
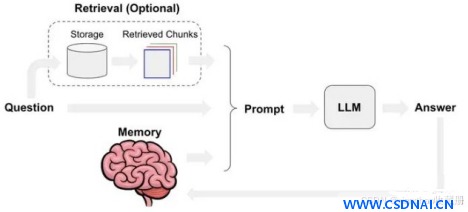
图1 RAG工作流程(with memory)
先看切分。块间重叠是最基础的调节旋钮,重叠太少会切断语义,太多则引入冗余噪声。多粒度切分是更稳的做法:同一份文档同时产出句子级、段落级、章节级三种块,检索时按query复杂度选择粒度。再进一步是基于语义的切分,用嵌入相似度判断句子边界,而不是死板地按字符数截断。文档块摘要则是在块前面挂一段浓缩描述,提升嵌入时的语义密度。
嵌入模型这块,通用模型在垂直领域往往力不从心。用新语料微调嵌入模型能显著拉高领域内召回,但要注意微调后的模型与原有索引不兼容,必须全量重建向量库。动态表征是另一条路,让同一个文档块在不同query下呈现不同的向量表达,代价是推理开销上升。
提示工程优化最容易被低估。模板里加约束条件、对query做改写再检索,这两招成本极低但收益明显。大模型侧的迭代包括基于正反馈微调、量化感知训练,以及直接换用更大context window的推理模型。
召回集合的后处理同样关键。元数据过滤能在检索前砍掉大量无关块,重排序则在检索后压缩文档块数量,把最相关的几条顶到前面。
向量库选型与索引参数决定召回下限
策略谈完得落到工程。向量数据库的索引类型直接决定召回率和延迟的平衡点。HNSW适合高召回低延迟场景,但内存占用大;IVF系列省内存,代价是召回率有损。pgvector从0.5.0开始支持HNSW,0.7.0引入了迭代索引扫描(iterative index scan),解决了带过滤条件的查询在HNSW上召回不足的老问题。如果你的RAG带元数据过滤,这个特性值得升级。
另一个高频坑是嵌入维度和距离度量不匹配。用余弦相似度就必须在索引创建时显式指定vector_cosine_ops,默认的L2距离在归一化向量上虽然等价,但未归一化时结果会偏。校验方法很简单:拿一对已知相似的文档块,分别用两种度量算距离,看排序是否一致。
知识图谱作为平行召回通道
纯向量检索有个硬伤:拿不到长程关联知识。当context window只有4k时,这个短板尤其致命。向量库召回的是语义相近的碎片,但碎片之间的结构关系丢了。
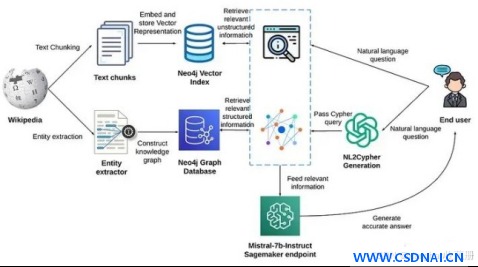
图2 基于KG+VS进行上下文增强
解法是加一路与向量库平行的KG上下文增强。用户query进来后,一路走向量检索,另一路通过NL2Cypher转成图查询。更实用的做法是图采样:先从query里抽取实体,把实体作为种子节点对图采样。种子节点的确定可以先把KG节点和query实体都向量化,用相似度来选,避免精确匹配的脆弱性。采出来的子图转成文本片段,和向量召回的结果一起喂给大模型。
这套方案不是万能的。KG的构建和维护成本高,schema设计一旦僵化,新增关系类型就要动图结构。如果业务领域的实体关系稀疏,KG这一路的召回质量可能还不如纯向量。适用场景是实体关系密集、查询涉及多跳推理的领域,比如医疗、法律、金融合规。
Self-RAG让模型自己决定要不要检索
经典RAG有个默认假设:召回的上下文都该用。但实际中召回的块可能和query无关甚至矛盾,无差别合并只会污染生成结果。context window越小,这个污染越致命。
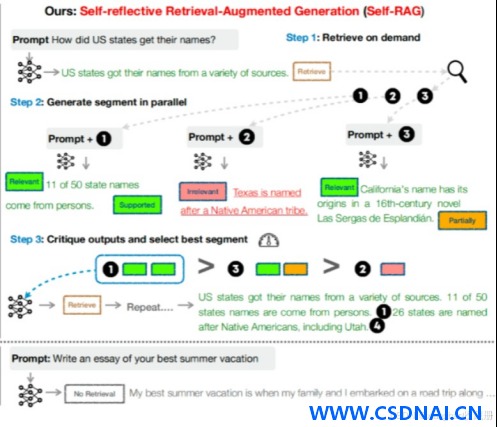
图3 RAG vs Self-RAG
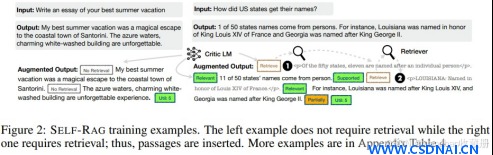
Self-RAG的核心变化是让模型主动判断。流程大致是:先判断是否需要额外检索事实信息,只在需要时才召回;然后平行处理每个片段,为每个片段生成prompt和输出;再用反思字段检查输出是否相关,挑出最符合需要的片段;必要时重复检索。最终生成结果会引用相关片段,并标注输出是否被该片段支持,方便查证。
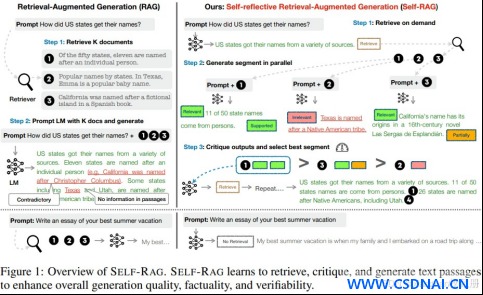
创新点落在反思令牌(Reflection tokens)上。模型生成特殊标记来检查自己的输出,这些标记分两类:Retrieve和Critique。Retrieve判断是否有检索必要;Critique在检索完成后检查输出相关性、完整性、以及检索片段是否支持输出观点。模型基于原有词库加上反思字段来预测下一个token。
反思令牌的训练与推理部署约束
训练时,反思字符被集成进词汇表,模型学会生成带反思字符的文本。语料库里的反思字符由Critic模型预测,Critic评估检索段落和任务输出的质量。手动标注反思字符成本太高,作者用GPT-4生成,再蒸馏到内部Critic模型。不同反思字符通过少量演示来提示,比如检索令牌会被提示判断外部文档是否能改善结果。
生成模型的训练则用检索和Critic模型增强原始输出,模拟推理过程。每个片段,Critic判断额外段落是否改善生成,是则加Retrieve=Yes标记并检索前K个段落,再评估每段的相关性和支持性并附加标记。最后用标准next token目标在增强语料上训练,预测目标输出和反思字符。训练期间检索到的文本块被屏蔽,词汇量通过Critique和Retrieve扩展。这比PPO等依赖单独奖励模型的方法更省成本。
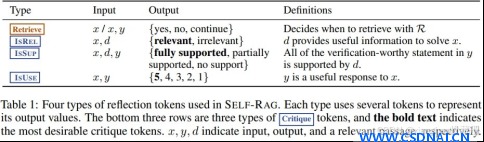
部署环节有个容易踩的坑:反思令牌扩展了词表,推理框架必须能正确处理这些特殊token。用vLLM部署时,如果tokenizer的added_tokens没同步进模型配置,会出现反思令牌被拆成多个子词、生成结果乱码的情况。排查方法是加载模型后打印tokenizer.get_vocab()里反思令牌的ID,确认和训练时一致。另一个约束是Self-RAG的多次检索和反思会拉长推理链路,首token延迟明显高于普通RAG,对延迟敏感的场景要权衡。
优化策略的组合与取舍
这些策略不是叠得越多越好。切分粒度和嵌入模型微调是基础层,投入产出比最高,应该先做扎实。重排序和元数据过滤属于低成本高回报的中间层。KG增强和Self-RAG是重投入方案,适合对准确性要求极高、且能承担额外延迟和运维成本的场景。
一个务实的实现顺序:先把切分和嵌入调好,加元数据过滤和重排序,观察召回质量的天花板。如果瓶颈在长程关联,再上KG。如果瓶颈在上下文噪声,考虑Self-RAG的按需检索思路。每一步都用同一套评测集验证,别凭感觉调参。
ID:6493







