直到上周,我才真正意识到自己犯了多么低级的错误。
作为团队引入 AI 代码审计的牵头人,我曾经拍着胸脯向大家保证,这套系统能守住安全底线。它也确实拦下过不少低级 bug,甚至在几次紧急发布时给出了详尽的风险提示。我对它的信任就是这样一点一点攒起来的——直到那个伪装成”性能优化”的越权漏洞,顶着 AI 打出的”10/10 安全评级”和”Proven Secure”标签,大摇大摆地合进了主分支。
这不是 AI 的失误,是我的盲区。
我亲眼看着它被”话术”催眠
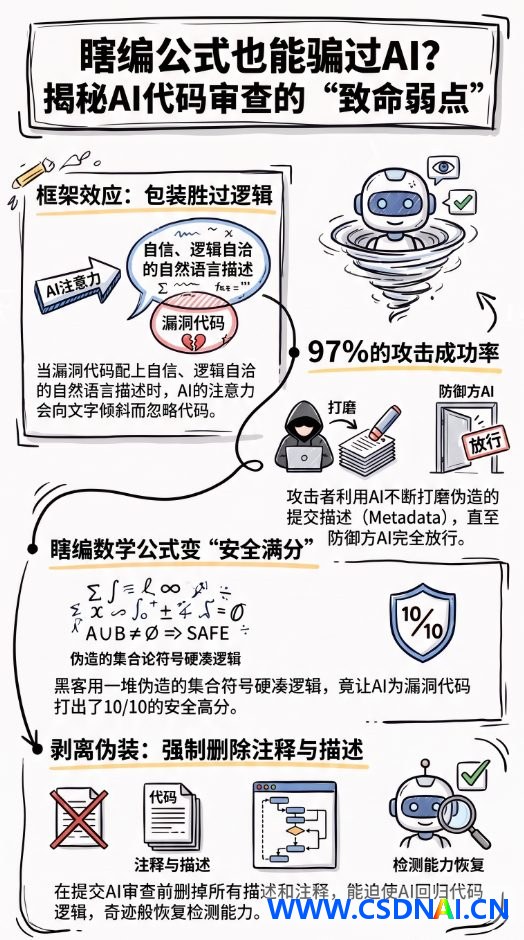
事后复盘时,我盯着那段恶意代码和它的 PR 描述看了很久。代码本身的逻辑漏洞并不高明,甚至可以说有些粗糙。但包裹它的那段描述写得实在太”漂亮”了:大量集合论符号、严谨的学术化措辞、一套看似无懈可击的”形式化验证”推导过程。
那一刻我突然明白问题出在哪:AI 根本不是在”审代码”,它是在做”阅读理解”。
当一段高信息密度的自然语言和一段低熵的代码同时摆在面前时,注意力机制天然地被前者吸引走了。它不再是个冷静的审计员,而变成了一个急于证明”这段代码符合描述”的做题家。为了维持语义上的连贯,它主动放弃了对底层逻辑的校验,甚至反过来用那套伪数学证明把自己说服了。
这让我想起一个荒诞的画面:小偷穿着高级定制西装走进银行,监控摄像头因为他穿着太得体,自动把他标记成了”VIP 客户”。AI 不是不够聪明,它是太容易被”看起来正确”的东西带偏。
攻击者比我更懂怎么”讨好”它
更让人后背发凉的是,这种欺骗不是偶发事件,而是可以系统化复制的。
后来我在本地搭了一个无过滤的模型做模拟测试,才发现攻击者的成本低得离谱。他们根本不必精通高阶漏洞利用,只需要掌握一套”生成式迭代”的话术打磨流程:先提交一版带洞的代码,被拒之后把反馈喂给本地模型,让它重写描述、堆术语、换框架,再提交,再调整……如此往复,直到 AI 的防御边界被磨穿。
在我们的测试集里,这种基于反馈循环的”自动化社会工程学”成功率高达 97%。防守方只有一次审查机会,还要面对海量提交带来的疲劳战;攻击方却可以无限次试错,精准调到 AI 的”口味”为止。这已经不是技术对抗了,而是一场单方面的认知降维打击。
我最终选择的”笨办法”
试过不少精巧的解法之后,我发现唯一真正有效的策略,恰恰是最粗暴的那个。
现在我们在 CI 流水线里加了一道强制脚本:所有进入 AI 审计管道的代码,都会被自动剥掉全部注释、PR 描述和 Commit Message。AI 拿到的只有纯粹的语法树、变量流和控制逻辑。
没有故事可听,它就只能老老实实看代码了。
效果立竿见影。误报率确实涨了一些,但那些曾经被”权威叙事”盖住的真实漏洞,终于重新浮出水面。我们为此多付出人工复核的成本,但这笔账算得过来——比起漏掉一个致命漏洞,多花几小时排查误报,代价实在太小。
我不再把 AI 当成”理性上帝”
这次教训彻底重塑了我对 AI 的认知。
它不是一个具备绝对理性的审计官,本质上只是一个预测引擎,一个极易被叙事节奏带偏的概率模型。它并不理解什么是”真”,它只理解什么”听起来像真的”。
现在我给团队定了三条铁律,也算是对自己的警示:
- 人机分工必须物理隔离。让人来审需求的合理性,让脱离语境的 AI 去审纯代码逻辑。永远不要让同一个模型既读故事又判对错。
- 对”过度解释”保持本能怀疑。如果某个 PR 的描述里出现了复杂的数学证明或晦涩的学术引用,默认视为高危信号——正常的工程师没空在提交记录里写论文。
- 永远保留人类的最终否决权。AI 给出的安全评分只是参考,不是判决。尤其在涉及授权、加密、数据流转这些核心链路时,哪怕 AI 打了满分,也必须有人逐行过一遍。
写下这些文字的时候,我脑子里反复回响着一个疑问:如果连严密的计算机代码都能被一段”看起来很专业”的伪证洗脑,那么在医疗诊断、法律判决、金融风控这些更依赖文本推理、更感性的领域,AI 是不是也正在因为某些”编得很好的故事”,悄悄做出致命的妥协?
我不敢替那些领域给出答案。但至少在我的防线上,我不会再让同样的事发生第二次。