在企业内网私有环境里部署大模型推理集群,很容易踩到一串坑:流量调度混乱、节点负载失衡、会话上下文丢失、接口缺少鉴权防护,而单个 vLLM 推理节点往往扛不住并发请求。本文基于 Ubuntu 22.04,搭建 Nginx + vLLM-Semantic-Router + vLLM-Router + vLLM Node 的多层推理集群,从环境准备、模型拉取、组件分步部署,到 Nginx 的 SSE 流式反向代理与接口联调验证,完整记录一套可以直接复现的落地方案。
架构拓扑
这套方案采用 Nginx + vLLM-Semantic-Router + vLLM-Router + vLLM Node 推理节点的多层分层结构,把请求鉴权、负载均衡、语义智能路由和算力负载分流串成一条完整链路。
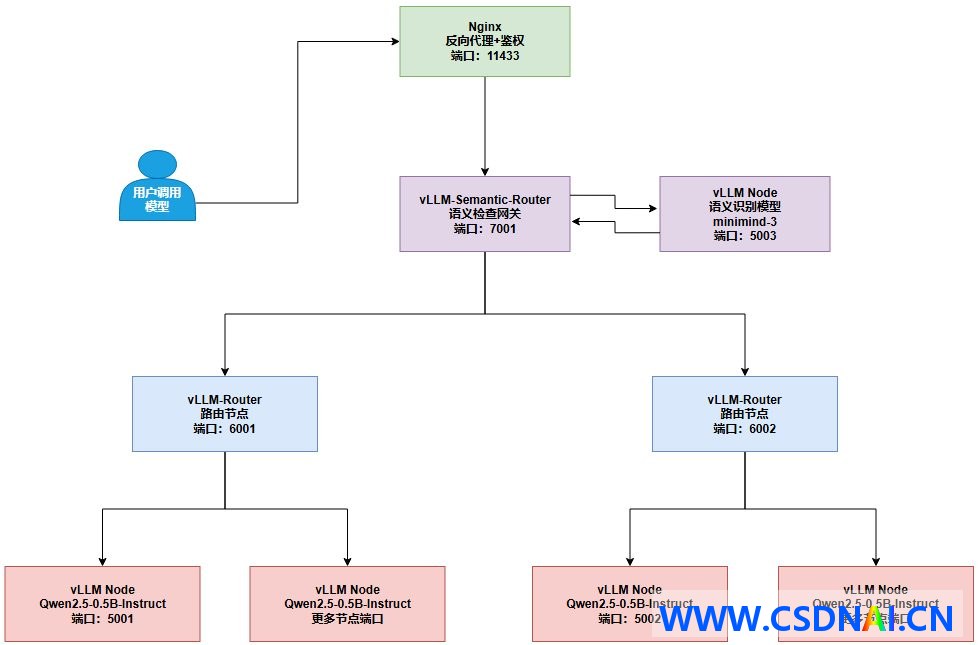
架构自上而下分这几层:
- Nginx:集群唯一的对外入口,承担接口鉴权、请求反向代理、全局负载均衡和 SSE 流式响应适配,保障集群安全与流量稳定分发。
- vLLM-Semantic-Router(语义网关):识别用户请求意图,区分通用对话、代码编写等场景,把请求按业务智能分类路由到合适的模型。
- vLLM-Router(算力路由层):监控后端推理节点的显存与算力负载,基于一致性哈希把流量摊匀,支持会话亲和与 KV 缓存复用,承上启下转发流量。
- vLLM Node 推理节点:真正跑大模型推理服务的地方,提供对话、代码生成等核心推理能力;双节点部署带来算力冗余与负载分担。
环境部署
vLLM Node 推理节点部署(双节点)
这是集群最底层的算力载体,负责运行 vLLM 推理服务、加载大模型,执行对话与代码生成等实际推理任务。部署双实例,既分担算力负载,也提供服务冗余。
具体做法:部署 2 个独立推理节点,分别绑定 5001、5002 端口,同时再部署一个 5003 端口的语义识别模型节点,为上层的语义路由提供意图识别能力。
1、安装 vLLM 兼容依赖包,能正常输出版本号即视为成功。
root@localhost:~# python3 -m venv ~/vllm
root@localhost:~# source ~/vllm/bin/activate

root@localhost:~# pip install -i  bitsandbytes tiktoken
root@localhost:~# pip install -i  openvino modelscope vllm
root@localhost:~# python -c "import vllm; print(vllm.__version__)"
0.29.0
2、通过魔搭社区拉取轻量化模型,适配本地部署场景,分别用于对话推理和语义意图识别。
开启离线模式、配置模型基础参数,准备三台 Ubuntu 服务器(每台配 1-5 颗 GPU),分别启动三个节点服务。
root@localhost:~# mkdir -p /data/model/

# 用于对话的模型
root@localhost:~# modelscope download --model Qwen/Qwen2.5-0.5B-Instruct --local_dir /data/model/qwen2.5

# 用于vLLM-Semantic-Router语义检查模型
root@localhost:~# modelscope download --model gongjy/minimind-3 --local_dir /data/model/minimind3

root@localhost:/data/model# ls -lh
total 8.0K
drwxr-xr-x 3 root root 4.0K Sep 10 17:25 minimind3
drwxr-xr-x 2 root root 4.0K Sep 10 17:23 qwen2.5
vLLM-Router(算力路由层)
vLLM-Router 是算力负载路由的核心,负责监控后端推理节点的负载并均匀分发流量,支持会话亲和与 KV 缓存复用,承接来自语义网关的请求流量。
1、安装路由节点。
root@localhost:~# export HF_HUB_OFFLINE=1

# 节点 1 端口 5001
root@localhost:~# vllm serve /data/model/qwen2.5 \
  --host 127.0.0.1 \
  --port 5001 \
  --trust-remote-code \
  --dtype bfloat16 \
  --max-model-len 512 \
  --tensor-parallel-size 1

# 节点 2 端口 5002
root@localhost:~# vllm serve /data/model/qwen2.5 \
  --host 127.0.0.1 \
  --port 5002 \
  --trust-remote-code \
  --dtype bfloat16 \
  --max-model-len 512 \
  --tensor-parallel-size 1

# 语义检查模型 端口5003
root@localhost:~# vllm serve /data/model/qwen2.5 \
  --host 127.0.0.1 \
  --port 5003 \
  --trust-remote-code \
  --dtype bfloat16 \
  --max-model-len 512 \
  --tensor-parallel-size 1
2、采用一致性哈希策略,绑定对应的推理节点,实现会话固定路由。
root@localhost:~# python3 -m venv vLLM-Router
root@localhost:~# source vLLM-Router/bin/activate
root@localhost:~# pip install -i  vllm-router
3、验证可用性。带上 X-Session-ID 后,同一个 session-id 会始终路由到同一个 vllm 后端,从而实现会话亲和、复用 KV 缓存。
# 路由节点1:对接5001通用对话节点 端口6001
root@localhost:~# vllm-router \
--host 127.0.0.1 \
--port 6001 \
--worker-urls  \
--policy consistent_hash

# 路由节点2:对接5002代码推理节点 端口6002
root@localhost:~# vllm-router \
--host 127.0.0.1 \
--port 6002 \
--worker-urls  \
--policy consistent_hash
vLLM-Semantic-Router(语义网关)
上层的业务路由解析用户输入、识别请求意图,区分普通闲聊和代码编写等场景,再按语义规则把请求转发到对应的算力路由后端,做到按业务场景智能分流。
需要留意:这里的网关服务只能跑在 Docker 容器里,无法直接在物理机上运行,下文只提供一份可供参考的正确配置文件。
1、安装语义网关服务,并调用启动命令生成默认配置文件。
root@localhost:~# curl  \
  -H "Content-Type: application/json" \
  -H "X-Session-ID: session-001" \
  -d '{
    "model": "qwen3",
    "messages": [
      {"role": "user", "content": "你好"}
    ],
    "temperature": 0.7,
    "max_tokens": 128
  }'
2、修改生成的 config.yaml(对接下层 vllm-router,地址 127.0.0.1:8001)。
替换为下面这份完整配置,对接下层算力路由节点,并定义语义路由规则:
root@localhost:~# python3 -m venv vsr
root@localhost:~# source vsr/bin/activate
root@localhost:~# pip install -i  vllm-sr
root@localhost:~# vllm-sr serve
3、前台检测文档可用性,并运行服务。
version: v0.3
listeners:
  - name: http-7001
    address: 0.0.0.0
    port: 7001
    timeout: 300s

providers:
  defaults:
    default_model: qwen-0.5b
  models:
    # 语义识别模型 minimind(图中5003端口 minimind-3)
    - name: minimind
      provider_model_id: minimind
      api_format: openai
      backend_refs:
        - name: minimind-backend
          endpoint:
          protocol: http
          weight: 100
    # 第一个路由节点6001:普通聊天
    - name: qwen-0.5b
      provider_model_id: qwen-0.5b
      api_format: openai
      backend_refs:
        - name: router-6001
          endpoint:
          protocol: http
          weight: 100
    # 第二个路由节点6002:代码编写
    - name: qwen-code
      provider_model_id: qwen-code
      api_format: openai
      backend_refs:
        - name: router-6002
          endpoint:
          protocol: http
          weight: 100

routing:
  # 预先定义自定义信号 code_intent
  signals:
    embeddings:
      - name: code_intent
        threshold: 0.7
        aggregation_method: max
        candidates:
          - "写代码"
          - "编写脚本"
          - "python代码"
          - "java代码"
          - "js代码"
          - "函数实现"
          - "算法编写"
          - "代码调试"
          - "代码改错"
          - "写程序"
          - "代码实现"
          - "写一段代码"

  modelCards:
    - name: minimind
      description: "语义识别模型,用于意图判断"
      capabilities:
        - semantic_routing
    - name: qwen-0.5b
      description: "通用对话模型,普通聊天,路由6001"
      capabilities:
        - chat
    - name: qwen-code
      description: "代码专用模型,代码编写,路由6002"
      capabilities:
        - coding

  decisions:
    # 代码编写意图 → 路由到6002
    - name: route_code_writing
      description: "用户请求编写代码、脚本、程序,路由到代码专用router 6002"
      priority: 100
      rules:
        operator: AND
        conditions:
          - type: embedding
            name: code_intent
      modelRefs:
        - model: qwen-code

    # 兜底:普通聊天 → 路由到6001
    - name: default_chat
      description: "默认普通聊天场景,路由到6001"
      priority: 10
      rules:
        operator: AND
        conditions: []
      modelRefs:
        - model: qwen-0.5b

global:
  health_check:
    interval_seconds: 10
Nginx(反向代理及鉴权)
Nginx 作为集群唯一的对外入口,实现接口基础鉴权、SSE 流式响应适配、双路由节点负载均衡以及请求超时统一管控,可以让它直接承接外部流量而不必经过语义网关,从而简化部署架构。
Nginx 入口端口:11433,保留基础鉴权,去掉语义网关,由 Nginx 直接把流量负载均衡分发到两台 router。
1、安装 Nginx 组件,并编辑配置文件启用反向代理功能。
root@localhost:~# vllm-sr validate --config /root/config.yaml
2026-09-10 17:25:56,551 - INFO - ============================================================
2026-09-10 17:25:56,551 - INFO - vLLM Semantic Router - Validate Configuration
2026-09-10 17:25:56,551 - INFO - ============================================================
2026-09-10 17:25:56,551 - INFO - Validating: /root/config.yaml
2026-09-10 17:25:56,551 - INFO -
2026-09-10 17:25:56,558 - INFO - Configuration parsed successfully
2026-09-10 17:25:56,558 - INFO -   Version: v0.3
2026-09-10 17:25:56,559 - INFO -   Listeners: 1
2026-09-10 17:25:56,559 - INFO -   Decisions: 2
2026-09-10 17:25:56,559 - INFO -   Models: 3
2026-09-10 17:25:56,559 - INFO - Validating user configuration...
2026-09-10 17:25:56,559 - INFO - Configuration validation passed
2026-09-10 17:25:56,559 - INFO - ============================================================
2026-09-10 17:25:56,559 - INFO - Configuration is valid!
2026-09-10 17:25:56,559 - INFO - ============================================================
2026-09-10 17:25:56,559 - INFO -
Configuration summary:
2026-09-10 17:25:56,559 - INFO -   Version: v0.3
2026-09-10 17:25:56,559 - INFO -   Listeners: 1
2026-09-10 17:25:56,559 - INFO -   Embedding signals: 1
2026-09-10 17:25:56,559 - INFO -   Decisions: 2
2026-09-10 17:25:56,559 - INFO -   Models: 3
2026-09-10 17:25:56,559 - INFO -   Default model: qwen-0.5b
2026-09-10 17:25:56,559 - INFO -

root@localhost:~# vllm-sr serve --config /root/config.yaml
2026-09-10 17:26:16,703 - INFO - Using config file: /root/config.yaml
2026-09-10 17:26:16,713 - INFO - Created effective runtime config: /root/.vllm-sr/runtime-config.yaml

       █     █     █▄   ▄█
 ▄▄ ▄█ █     █     █ ▀▄▀ █
  █▄█▀ █     █     █     █
   ▀▀  ▀▀▀▀▀ ▀▀▀▀▀ ▀     ▀
  Semantic Router
  Intelligent Routing for Mixture-of-Models

2026-09-10 17:26:16,721 - INFO - Starting vLLM Semantic Router
2026-09-10 17:26:16,721 - INFO - Runtime stack: vllm-sr (port offset 0)
2026-09-10 17:26:16,721 - INFO - Config file: /root/config.yaml
2026-09-10 17:26:16,721 - INFO - Configured listeners:
2026-09-10 17:26:16,721 - INFO -   - http-7001: 0.0.0.0:7001
2026-09-10 17:26:16,721 - INFO - Runtime topology: split
2026-09-10 17:26:16,721 - ERROR - Docker not found in PATH
2026-09-10 17:26:16,721 - ERROR - Please install Docker Desktop or Docker Engine to use this tool
2026-09-10 17:26:16,722 - ERROR -
2026-09-10 17:26:16,722 - ERROR - Installation instructions:
2026-09-10 17:26:16,722 - ERROR -   Docker:
root@localhost:~# apt install -y nginx apache2-utils
root@localhost:~# vim /etc/nginx/nginx.conf

user www-data;
worker_processes auto;
pid /run/nginx.pid;
include /etc/nginx/modules-enabled/*.conf;

events {
        worker_connections 768;
}

http {
        sendfile on;
        tcp_nopush on;
        types_hash_max_size 2048;
        include /etc/nginx/mime.types;
        default_type application/octet-stream;

        ssl_protocols TLSv1 TLSv1.1 TLSv1.2 TLSv1.3;
        ssl_prefer_server_ciphers on;

        access_log /var/log/nginx/access.log;
        error_log /var/log/nginx/error.log;

        gzip on;

        include /etc/nginx/conf.d/*.conf;
        include /etc/nginx/sites-enabled/*;

# 后端真实vllm-router地址
upstream router_real_6001 {
    server 127.0.0.1:29000;
}
upstream router_real_6002 {
    server 127.0.0.1:29001;
}

# 内部端口6001 仅本机127.0.0.1可访问
server {
    listen 127.0.0.1:6001;
    server_name localhost;

    location / {
        proxy_pass

        # SSE流式必备参数
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_buffering off;
        proxy_cache off;

        proxy_connect_timeout 300s;
        proxy_send_timeout 300s;
        proxy_read_timeout 300s;
    }
}

# 内部端口6002 仅本机127.0.0.1可访问
server {
    listen 127.0.0.1:6002;
    server_name localhost;

    location / {
        proxy_pass

        # SSE流式必备参数
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_buffering off;
        proxy_cache off;

        proxy_connect_timeout 300s;
        proxy_send_timeout 300s;
        proxy_read_timeout 300s;
    }
}

# 对外唯一入口:11433,鉴权 + 负载均衡分发到内部6001/6002
upstream vllm_main_pool {
    least_conn;
    server 127.0.0.1:6001 max_fails=2 fail_timeout=15s;
    server 127.0.0.1:6002 max_fails=2 fail_timeout=15s;
    keepalive 16;
}

server {
    listen 11433;
    server_name localhost;

    auth_basic "Restricted Access";
    auth_basic_user_file /etc/nginx/.htpasswd;

    location / {
        proxy_pass

        # SSE流式必备
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_buffering off;
        proxy_cache off;

        # 透传客户端信息
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;

        proxy_connect_timeout 300s;
        proxy_send_timeout 300s;
        proxy_read_timeout 300s;
    }
}
}
2、校验 Nginx 语法是否正确。
root@localhost:~# nginx -t
nginx: the configuration file /etc/nginx/nginx.conf syntax is ok
nginx: configuration file /etc/nginx/nginx.conf test is successful
3、创建鉴权账号。
root@localhost:~# htpasswd -c /etc/nginx/.htpasswd vllmuser

root@localhost:~# chown www-data:www-data /etc/nginx/.htpasswd
root@localhost:~# chmod 644 /etc/nginx/.htpasswd

root@localhost:~# nginx -t
root@localhost:~# nginx -s reload
4、测试访问示例,这里用 -u 指定用户名和密码。
root@localhost:~# curl  \
-u vllmuser:1234 \
-H "Content-Type: application/json" \
-d '{
"model": "qwen2.5",
"messages": [{"role":"user","content":"你好"}],
"stream": true
}'