BECKETT开发手记:DFX-Skills与App Freeze锚定
BECKETT_邓 2026-09-13 143 1 收录于Harmony OS工程师圈子专区
本文借助长视频导出卡死案例,呈现如何用 DFXSkills 将 THREAD_BLOCK_6S 故障定位至文件复制阶段。两次事件队列快照展现同一任务时长从三秒五增至六秒八,印证主线程因同步运维被长时间阻塞。旧代码揭示异步函数体内部仍落实全量内存处置,导致界面无法响应且无法仅靠 await 化解。复原方案引入一兆缓冲区落地有界复制,并配合短写循环检查与取消机理避免无限占用资源。最终融合十八项真机用例验证策略,保证超大文件情形下内存可控且页面交互正常无泄漏。
总结由社区底座通过AI大模型技术产出
前言:一次长视频导出卡死,我怎样用 DFX Skills 把问题缩到文件复制
从 THREAD_BLOCK_6S 到有界异步 I/O:证据、修复与复测
视频导出最让人误判的一类问题,是编码早已做了很多事务,界面却在保存阶段不再响应。看起来像媒体引擎卡住,记录顶部也或许停在体系内存函数里;假如顺着最显眼的那一行往下猜,很轻松越查越远。
这次样例的异常类型是 App Freeze,记录中的缘由是 THREAD_BLOCK_6S。它并非 JS Crash,也不能因为栈里浮现 Native 函数就改按 Cpp Crash 拆解。DFX Skills 对我的辅助,是把原始异常记录里的概览、资源、事件队列和线程栈整理到一起,省事交叉核对。真正须要开发者做完的,是把这些证据接回当时的场景代码。
下面采用脱敏后的旧版异常样例。旧问题已经有后续复原,本文研讨的是怎样从历史证据定位并复查修复;利器的再次拆解不等于当前迭代又复现了一次。函数名只保留解释职责所需的通用含义,路线、使用者文件和设备标识不进入公开材料。
**先确认读的是哪一份现场****
我在看堆栈前会先记录四件事:故障类型、发生情形、当时的应用版本,与代码对应的版本。不能径直拿今天的代码解释旧日志,更不能因为当前函数早已改成异步,这里的情形是长视频导出后的本地保存。
DFX Skills 的 App Freeze 拆解脚本能够分区输出。下面的路线用 skill-root 表示现实工具根目录,不绑定本机部署位置;命令中的 case.log 应替换为自己的原始 App Freeze 记录。
python
<
skill-root
>
/scripts/freeze/main.py -p case.log --section overview
python
<
skill-root
>
/scripts/freeze/main.py -p case.log --section resources
python
<
skill-root
>
/scripts/freeze/main.py -p case.log --section event-queue
python
<
skill-root
>
/scripts/freeze/main.py -p case.log --section fault-stack

Markdown
我的阅读顺序是先看 overview 判断事件类别,再看 event-queue 判断主线程上的任务是否推进,然后用 fault-stack 找业务职责,最后融合 resources 筛查资源压力。四份输出回答的是相异难题,不能把某一个“异常”标签直接当成根因。
如果工具输出比原始记录少,要回到原始字段确认是并非采集缺失;假如堆栈采集超时,也要把这个事实写进结论。没有采到,不等于对应事务没有出现。
**两次快照里的同一个作业,比一个栈顶更有说服力****
两次事件队列快照显示,同一个作业的起步时间保持不变,执行时长从约 3.521 秒增长到 6.686 秒,这个案例中。它给出的线索是:主线程正于一个长任务里停留,新的事件无法准时被处置。
| 证据 | 对本案的价值 | 不应拓展的结论 |
|---|---|---|
| THREAD_BLOCK_6S | 体系记录了主线程阻塞异常 | 不能单凭缘由名定位具体函数 |
| 同一作业延续 3.521s → 6.686s | 长任务没有及时使出执行 | 不是精确的函数耗时统计 |
| 导出 → 文件复原 → 全局写回 | 业务责任落到保存阶段 | 不代表编码耗时为零 |
| 栈中浮现 memset / 内存处置 | 当时可能正分配或填充内存 | 不能直接认定体系库有缺陷 |
| 堆栈采集有退化或超时 | 务必保留证据界限 | 不能编出热点占比 |
这里最关键的交叉验证是:事件队列证明“卡在哪一类执行状态”,业务栈告诉我“为什么这一时期会做海量工作”,旧代码再说明“工作规模如何随视频大小攀升”。三者能对上,复原才有明确落点。
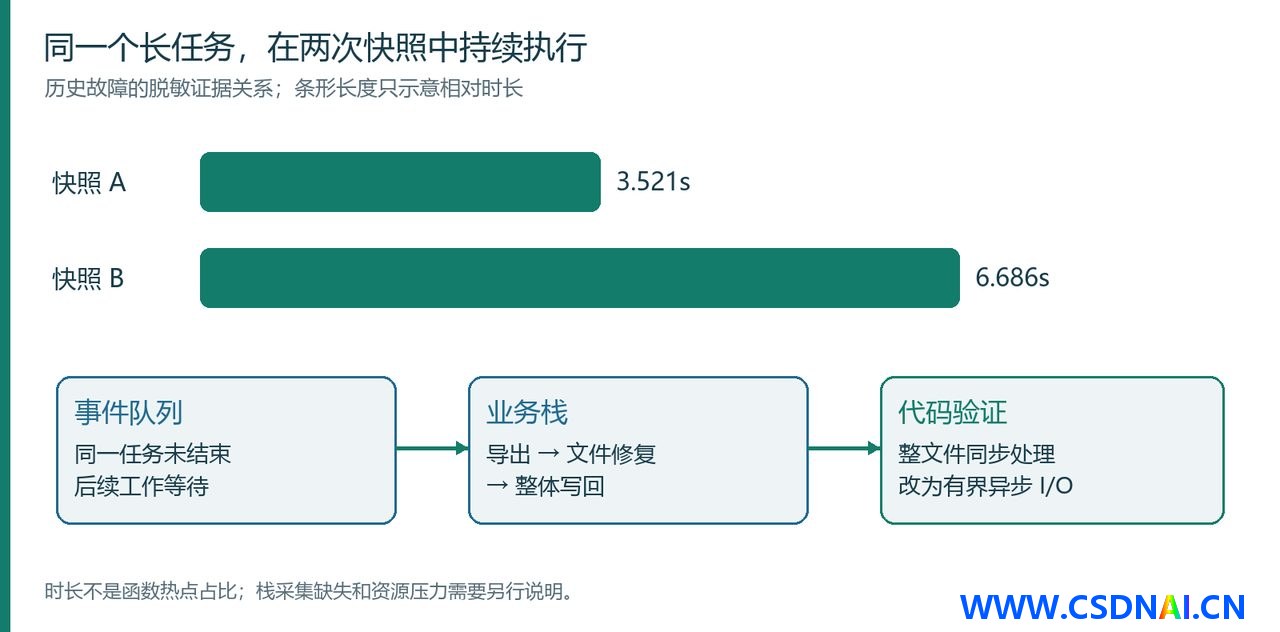
图 1:两次快照指向同一长作业,再由场景栈与旧代码确认保存时期的同步工作。
资源区里的高 RSS 须要看,不过它单独不能印证泄漏或 OOM。这个样例也没有足够的完整采样去写“某函数占用了多少百分比 CPU”。我会把结论停在证据能支持的位置:主线程执行了与大文件体量相干的同步内存和文件运维,足以解释当前阻塞。
**async 函数为什么仍然会卡住页面****
旧保存链路会读取较大的文件内容、构造新字节数组,再全局写回。调用者虽然 await 了导出函数,但被调函数内部仍可能在主线程同步落实这些流程。
async

function

saveVideo
(
path
) {

const
 wholeFile =
readAllSync
(path);

const
 repaired =
rebuildBytes
(wholeFile);

writeAllSync
(path, repaired);
}
Cts
这段是旧问题方式的缩写,并非可直接运转的文件 API。async 只描述返回值和异步暂停本领,不会自助把函数体搬到事务线程;把同步触发套在 Promise 里,同样不能转变它在哪个线程落实。即便在整段事务之前加一个 await,后面连续的核算与同步 I/O 仍然可能长时间占住主线程。
所以,我没有将复原目的写成“加几个 await”。目标应该是两个能够检查的条件:复制让用的缓冲区有固定上限;长文件的读写借助异步接口推动,避免整文件同步搬运。对于必须连续核算的重活,另行判断可否要进入 Worker 或任务池,而并非用循环中的空 Promise 假装迁移线程。
**复原的核心,是把文件大小从内存需求里拿掉****
后续落地里,有界复制函数复用一个 1 Mi B 缓冲区,显式传递源偏移和目的偏移,并处理提前结束、短写与取消。文件描述符由触发方管控,复制函数不关闭传入的 FD。这几条约定比“用了异步 API”更要紧,因为它们敲定差错时数据和资源会处于什么状态。
1 Mi B 是这份落地的块大小,并非所有设备都应照抄的最佳参数。更精准的内存说法是“复制步骤的应用缓冲为 O(块大小)”,而不是“整个导出只用 1 Mi B”。媒体编解码器、其他作业和短写时的临时切片仍然占内存。
短写尤其轻松漏掉:一次 write 返回 n,只能解释本次写入 n 字节。剩余数据要继续写;返回 0 或负数务必终止,不能使循环始终转。
let
 written =
0
;

while
 (written < readBytes) {

const
 view = buffer.
subarray
(written, readBytes);

const
 n =
await

writeAt
(view, destinationOffset + written);

if
 (!
Number
.
isInteger
(n) || n <=
0
 || n > view.
length
) {

throw

new

Error
(
'write made no valid progress'
);
 }
 written += n;
}
Cts
这段让用注入的 write At API,配套 bounded-copy.mjs 将读、写、取消和长度检查组合成完整示例。它能在 Node 中借助模拟短读、短写和差错来复测;迁入 Ark TS 时,应按目的文件 API 适配参数,而并非将 Node 示例说成鸿蒙真机落地。
此外,文件偏移不能只校验初始值。若要朝向超大文件,还要检查 offset + copied 是否仍为安全整数,目的写入边界有没有越界。复制固定长度时,源文件提前 EOF 应报错;复制到 EOF 时,正常读到结尾才结束。这两种语义须要在函数参数里说明晰。
**文件修复只处置自己理解的范围****
长视频保存链路里还有 MP 4 首样本复原。这里更不适配为了“通用”而把整个文件读进内存:先有界读取头部,识别自己明确支持的盒结构与字段,能锚定到必要修改再处置;遇到不具备的布局就按既定策略退出,不能靠猜偏移去改使用者文件。
建议把“无须修复”“做完修复”“不支持此格式布局”“处置失败”分成明确成效。前两种能够继续,后两种由上层决定保留原件、提示失败或走替代路线。把所有异常都吞掉并返回成功,会使后面的图库或上传时期背上一个难锚定的损坏文件。
本案后续代码还增添了长视频导出策略。流式复制化解的是一段操作的内存与响应性,并不能取消总磁盘空间、编解码器实例数和并发作业的上限。临时产物与最终产物并存时,要按真切存储开销判断可否能启动;失败时只删除当前作业拥有的临时文件,不能顺手删除源视频。
**用异常注入验证修复,比只换一个大视频更快****
配套示例专门使读写返回比请求更少的字节,并在指锚定置取消或报错。小资料就能暴露“只写了一一块仍报成功”“无进展无限循环”“取消后继续写”等问题,没必需每次都复制十几 GB 才验证控制逻辑。
真机验收则看另一层:导出期间页面能否交互、取消多久被观察到、峰值内存是否随文件大小明显增长、保存产物是否存在视频轨且可播放,与反复进入退出后资源是否放出。相异层的验证各管自己的结论。
已有过往记录含有 18 项真机用例借助;超长 4K 素材也有压力路线记录。但对某个超大素材,现有记录并没有完整覆盖“最终导出完成并落盘”的自助化证据,所以不能把它写成超大文件全链路整体借助
**DFX Skills 最值得复用的用法****
我会保留一份很短的案件笔记:异常出现在哪个迭代;哪两条独立证据具备判断;对应哪段代码;修改了哪个繁复度或落实位置;用什么用例验证;还有什么没有验证。这样下次换一个 Skills 版本重新拆解,成效也有参照,而并非重新相信一段更流畅的文字。
这次案例里,利器帮助我更快读完现场,旧代码解释了阻塞机制,短写和取消测试把复原要求固定下来。最有用的心得是这三步可以互相核对。笔记都容易停在“记录拆解了一遍,代码改了一处”,遇到相干问题,缺少其中任何一步。
**落地来源与配套内容****
拆解利器来自 Open Harmony-SIG / developtools_dfx_skills 的 App Freeze 分析模块;本文不把利器本身算作个人。故障资料来自现实历史案例,公开表格保留时长关联与职责链,移除了真实身份、设备和业务路径。
*写在最后:感谢终端BG软件部的鸿蒙DFX团队研发与开源相关skills,把排障专家请到了每位开发者的身边,让稳定性问题不再是基层普通开发者的大难题。笔者已经通过该skill,修复了一个大量很久补丁的链路,并且基于相关建议进行了完全重构,得到了非常好的结果。也再次提醒,希望使用者可以结合现场日志分析,避免出现分析定位不准的情况。 skills async node 鸿 蒙 resources worker arkts 文件操作 beckett 文件同步 开 源 openharmony © 著作权归作者所有