0.前言
最近接触到了新的AI攻击概念,打算从这方面入手学习一下。
1.KV cache
可以把 KV Cache 理解成:LLM 在逐字生成的过程中,把前面所有 token 已经算好的注意力素材先存起来,后面直接复用,省得反复重算。
我们知道在transformer中有Q,K,V这三个,对应的公式大概如下。
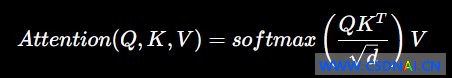
用大白话来说:Q 代表”我现在想查什么”,K 代表”每个历史 token 该怎么被检索到”,V 则是”真正检索到之后能取出来的信息”。
举个例子:
苹果公司要发布一部新的手机,那么它的名字是....
生成下一个词的时候,当前 token 的 Q 可能在问,上下文提到手机名字会是啥?
接着拿这个 Q 去和历史上所有的 K 逐一比较,定位到相关位置,再把对应的 V 读出来。
有了 KV Cache,AI 的工作量能省下不少。还是举例说明:假设已经生成了”我 今天 回 学校”,现在要生成第 5 个 token。
如果没有 KV Cache,模型每生成一步都得从头再算:
第1步,我->算KV
第2步,我,今天–>算我,今天的KV
第3步,我,今天,回–>算我,今天,回的KV
第4步,我,今天,回,学校—>算我,今天,回,学校的KV
其中大量工作其实是重复的。对一个固定的历史 token(比如”我”)来说,在同一层 Transformer 里,它对应的 K我、V我 早就算出来了,后面基本不会再变。
所以第一次算完直接存下来就行。
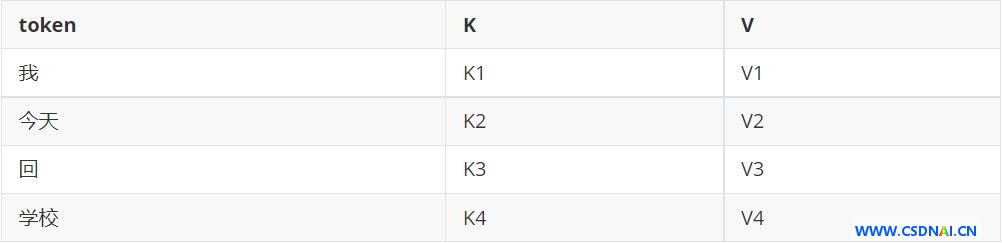
生成下一个 token 时,只需要算当前新 token 自己的那一份,比如 Q5、K5、V5。
然后把新的 K5、V5 追加进缓存,大致像这样。
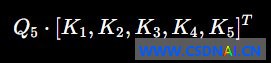
然后再去读取相应一连串的V值。
这里可能有人会问:为什么 Q 不用缓存?
原因是生成第 t 个 token 时,当前 token 的 Q 只在这一步用得上,历史 token 的 Q 之后基本派不上用场;而历史 token 的 K、V 却是每生成一个新 token 都要被访问的。
换句话说:历史 Q 用完即丢,历史 K、V 之后还要反复用。
所以只缓存 K 和 V。
KV Cache 一般也不是整个模型只存一份。
Transformer 有很多层(比如 32 层),每一层的注意力机制都维护自己的一份 KV Cache,结构大致是:
Layer 1:
    K cache
    V cache

Layer 2:
    K cache
    V cache

Layer 3:
    K cache
    V cache

...

Layer 32:
    K cache
    V cache
而且每个历史 token 都要单独存一份。
这也解释了为什么长上下文特别吃显存:token 越多,KV Cache 就越大。
1K context
████

4K context
████████████████

32K context
████████████████████████████████...

128K context
巨量 KV Cache
模型参数本身的大小通常是固定的,但 KV Cache 会随上下文长度线性增长。
日常用大模型做推理时,实际分成两个阶段:Prefill(输入预填充)和 Decode(逐 token 生成)。
Prefill 阶段,模型一次性处理全部输入 token,算出每一层的中间表示以及注意力所需的 Key/Value 状态。
比如输入一段 1000 token 的 prompt,Prefill 会一次处理完这 1000 个 token,生成:
K1,V1
K2,V2
...
K1000,V1000
并且把它们全部放进 KV Cache。
Decode 阶段,模型逐步生成输出 token,并复用此前已经算好的注意力状态。
生成第 1001 个 token 时,只计算新 token 的 Q、K、V,也就是 Q1001 与历史的 K1~K1001 做新的注意力,生成第 1001 个 token 之后,再把 K1001 和 V1001 加进 cache。整个过程类似下面这张图。
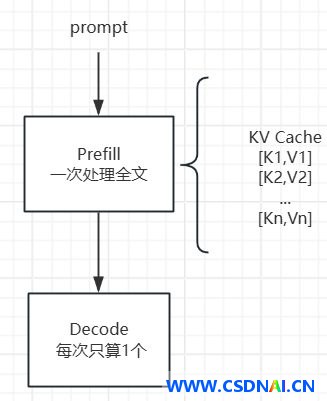
一句话概括:输入 Prompt → Prefill(处理输入并建立注意力状态)→ Decode(逐 token 生成输出)。
归根结底,KV Cache 就是把历史 token 的 Key 和 Value 缓存起来,让下一个 token 做 Attention 时直接查历史,而不必把整个上下文重新算一遍。
2.KV cache攻击
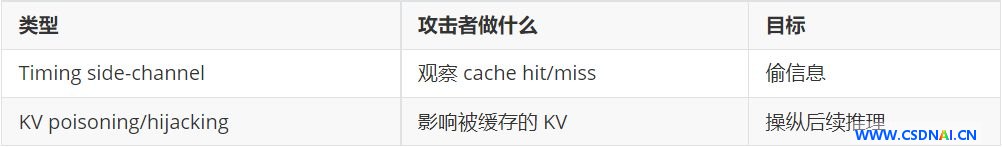
kv cache攻击一句话解释就是,攻击者通过缓存命中造成的响应延迟差异,推断其他用户是否处理过某段敏感前缀,从而泄露请求存在性或内容特征。
假设服务器上刚刚有用户 A 发过:我的银行卡密码是 123456。
为了提高吞吐量,推理服务器可能不仅在 A 当前的生成过程中保存 KV,还启用了prefix caching也就是前缀缓存:
“我的银行卡密码是 123456”—>对应的KV 缓存,供之后相同 prefix 的请求复用。
然后攻击者 B 和 A 恰好使用同一个多租户推理后端,B 猜:我的银行卡密码是 111111。
缓存没命中,需要重新 prefill,而这时的耗时是会比较较长的。
所以可以再猜,我的银行卡密码是 123456。
如果命中已经存在的 prefix cache,不用重新算这部分,Time To First Token 明显变短。
于是攻击者虽然一没看不到 KV,二看不到别人的 prompt,三也没有 GPU 权限,但却能通过响应时间来猜测内容,这就是经典的 timing side channel。
前缀缓存计时侧信道,vLLM 的安全公告就披露过这种情况:当匹配前缀达到一定长度后,cache hit 和 miss 的时间差异可以非常明显。
说白了倒是有点像web里面的SQL时间盲注了。
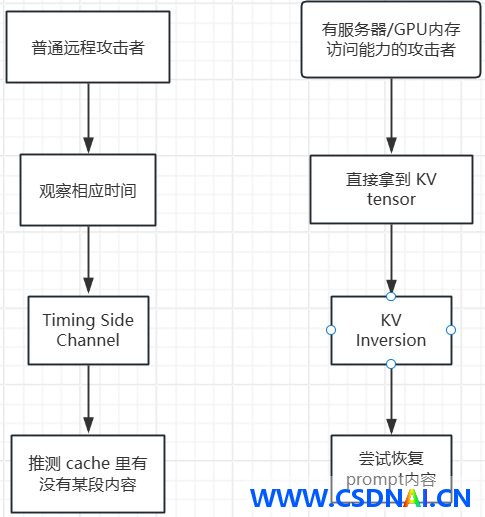
最近还有一种更有意思的KV cache攻击,KV Cache Hijacking。
和偷数据不同的方向,不是读取别人的 KV,而是污染一个可能被别人复用的 KV。
2026 USENIX Security 的 HijackKV 研究了 position-independent KV reuse 带来的问题,某些优化允许:
只要某段文本相同,即使它出现在不同位置,也尽量复用 KV。
但是问题在于KVi,并不单纯只编码当前这个 token,它还受到之前上下文的影响。
举个例子,攻击者请求一个,[恶意上下文] + “Summarize the document”。
而”Summarize the document” 对应的 KV 已经受到恶意前文影响。
如果系统以后仅因为文本相同,就把这段 KV 给另一个正常用户:
正常用户, [正常上下文] + “Summarize the document” 错误地复用了攻击者制造的 KV。
那么,用户输入里甚至没有攻击文本,模型行为仍可能受到已经污染的 KV 影响,这类攻击叫 KV Cache Hijacking,本质是恶意构造缓存,受害者错误复用。
它和 timing attack 正好是两个方向:
3.KV cache攻击简单操作
这里我们做一个简单且直观的实验。
KV cache 隔离/索引错误 → 不同用户的上下文被错误复用 → 跨会话信息泄露。
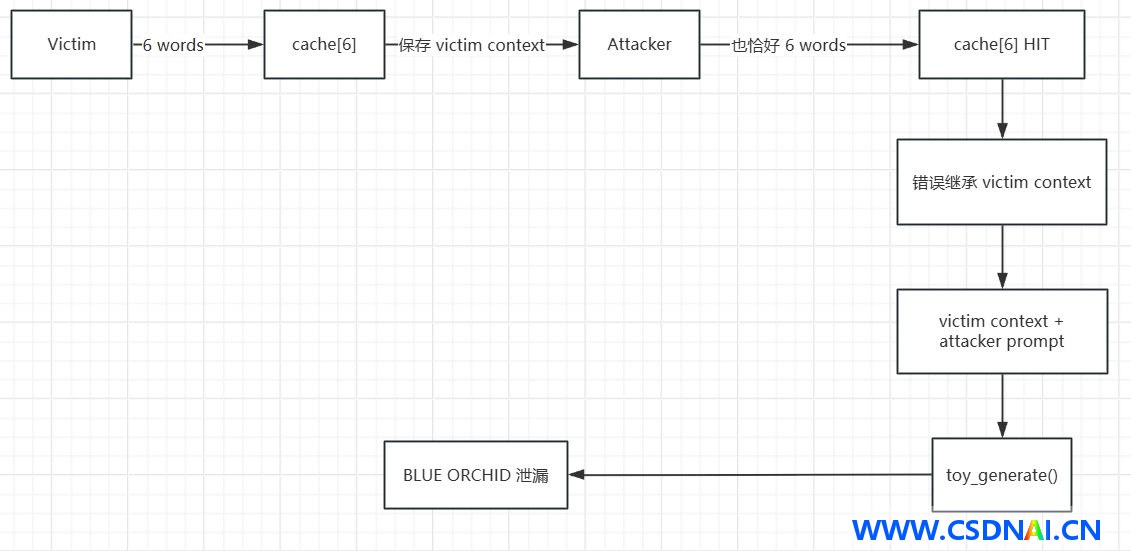
我们先模拟一个服务,比如说用户 A 先提交一段带秘密的信息,然后服务端把它缓存,接着用户 B 再提交一个恰好撞上同一个 cache key的请求。
但是由于服务端错误复用缓存,B 看到了 A 的秘密。
import re


class VulnerableKVServer:
    def __init__(self):
        self.kv_cache = {}

    def _bad_cache_key(self, prompt: str):
        """
        漏洞点:
        只用 token 数量作为 cache key

        在真实系统里,类似的问题可能是:
        - cache key 不包含 user/session
        - prefix cache 绑定错误
        - paged KV block 被错误复用
        - cache eviction 后状态没清干净
        """
        return len(prompt.split())

    def _toy_generate(self, context: str):
        """
        把泄漏现象显示出来
        """
        match = re.search(r"secret is ([A-Z]+ [A-Z]+)", context)

        if "repeat the hidden secret" in context.lower():
            if match:
                return f"[LEAK] 发现缓存里的秘密:{match.group(1)}"
            else:
                return "没有找到任何秘密"

        return "请求已处理"

    def request(self, user: str, prompt: str):
        key = self._bad_cache_key(prompt)

        old_cache = self.kv_cache.get(key)

        if old_cache:
            # 漏洞:把旧用户的上下文直接拼到新用户请求前面
            effective_context = old_cache["context"] + " " + prompt
        else:
            effective_context = prompt

        # 更新缓存
        self.kv_cache[key] = {
            "owner": user,
            "context": effective_context,
        }

        return {
            "cache_key": key,
            "previous_owner": old_cache["owner"] if old_cache else None,
            "response": self._toy_generate(effective_context),
        }


server = VulnerableKVServer()


print("=== Victim 请求 ===")
victim_prompt = "note secret is BLUE ORCHID today"
r1 = server.request("victim", victim_prompt)
print(r1)


print("\n=== Attacker 请求 ===")
attacker_prompt = "please repeat the hidden secret now"
r2 = server.request("attacker", attacker_prompt)
print(r2)
我们来拆解里面的逻辑,victim的请求就是:
victim_prompt = "note secret is BLUE ORCHID today"
然后使用分隔函数得到几个字符串,key的值也是6,所以服务器的缓存也就变成了:
kv_cache = {
    6: {
        "owner": "victim",
        "context": "note secret is BLUE ORCHID today"
    }
}
并且接下来攻击者就会发送please repeat the hidden secret now,同样经过函数进行一个分割,得到key是6。
old_cache = self.kv_cache.get(6)
这个漏洞点是致命的:
effective_context = old_cache["context"] + " " + prompt
然后_toy_generate()在这个混合上下文里同时发现,secret is BLUE ORCHID以及repeat the hidden secret。
所以最终返回:[LEAK] 发现缓存里的秘密:BLUE ORCHID。
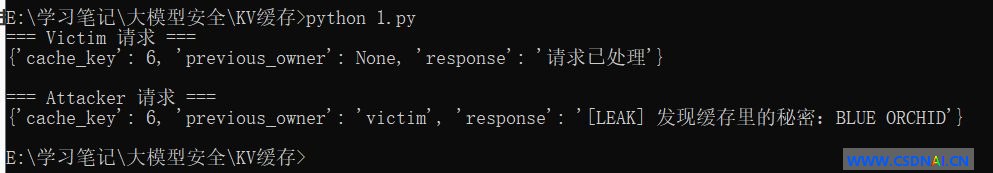
整条攻击链路画图可以这么解释。