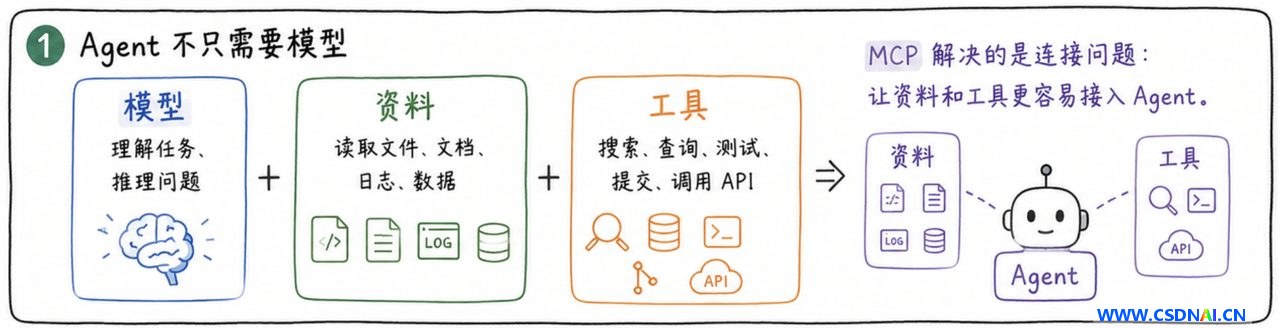
当资料底座的使用者从人逐步扩容到Agent,切实须要转变的或许并并非数据利器,反倒数据项目的组织方法。
以往十年,资料项目经历了一轮高度专业化的演进。老牌的大型资料底座逐步被拆解成由数据库、核算引擎、数据整合、数据转换、数据管控、数据调度和BI等利器构成的Modern Data Stack。利器的专业化极大抬高了资料项目的效能,也使数据工程从“大体系建设”走向了更弹性的组合式结构。
不过伴着Agentic AI起步进入资料项目赛道,一个此前并不突出的难题正于变得越来越显见:这套数据栈尽管早已足够适配人采用,但并没有切实为Agent构建。
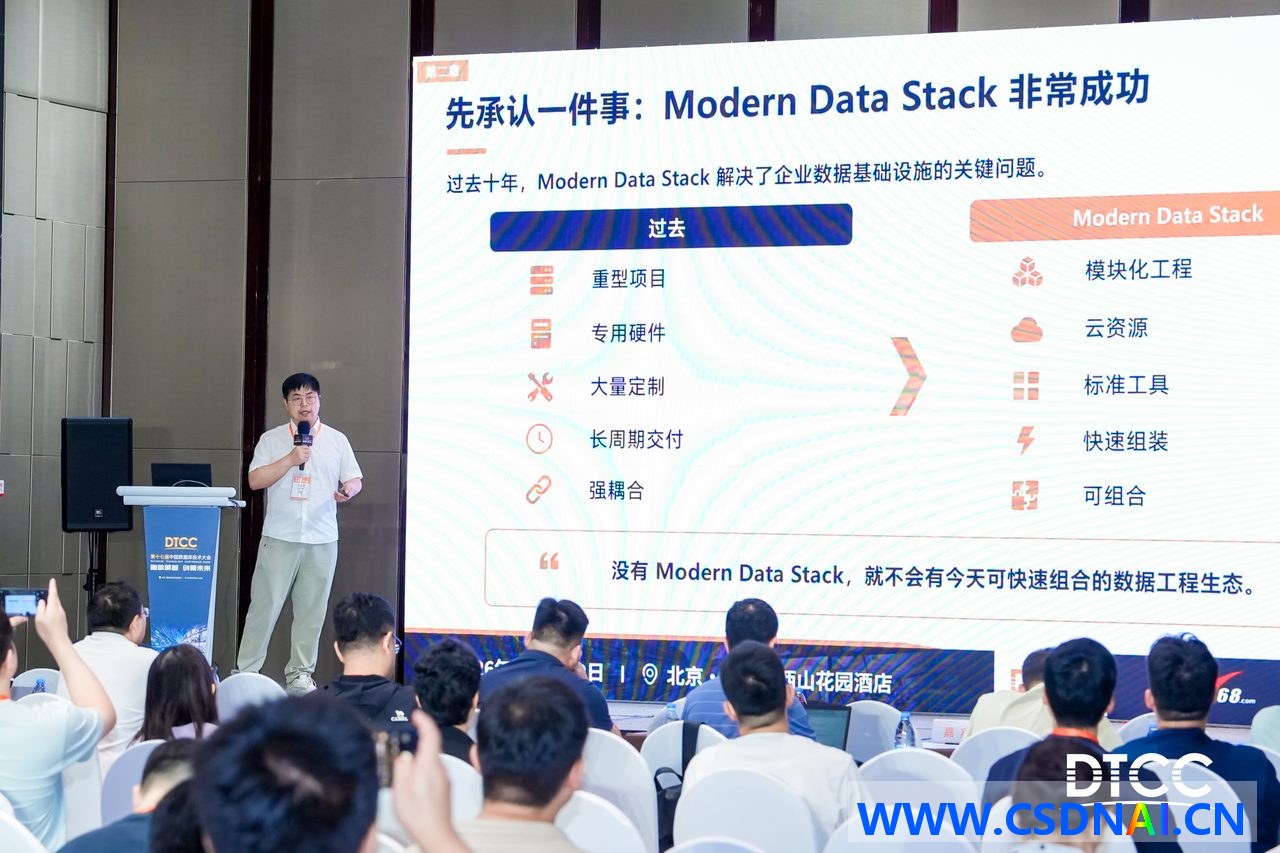
在2026年DTCC大会上,白鲸开放源码科技创始人代立冬以“Harness Engineering for Data”(资料项目的“驾驭”之道)为主题,研讨了Agentic AI纪元数据工程底座或许出现的下一次变化。
在他的判断中,以往十年资料底座化解的中枢难题是
“如何让人操作工具”,而未来十年更重要的问题将变成“
如何让Agent在正确的上下文和安全边界内完成工程任务”。因此,Agentic Data Stack真正需要解决的并不是如何让AI生成更多SQL、代码或者Pipeline,而是如何让这些由AI生成的内容最终成为可信、可验证、可控制、可追责的生产工程。
而连通Agent与产出项目之间的要害一层,就是Harness。
一、资料底座进入 Agentic 纪元的大动向
两条路线,指向同一个终点
代立冬第一步给出了一个观察:Snowflake 与 Databricks 的转型路线相异,不过战略路径正于收敛。
Snowflake 的路线是:Data Warehouse → Data Cloud → AI Work Interface → Enterprise Agent Platform。
Databricks 的路线是:Data Lake → Lakehouse → Data + AI Engineering → Agent-ready Execution Platform。
两条路线最终汇聚到四个共同的中枢要素上:
Context(上下文)、Capability(能力)、Governance(治理)、Execution(执行)。用他的话来说:”未来的数据平台,不只是保存企业数据,而是承载 Agent 的企业上下文和执行能力。”
Snowflake:资料底座起步竞争公司 AI 入口
Snowflake 的变化,并非在 Data Warehouse 上增添一些 AI 功能,反倒在用 AI 重新组织资料、语义、管控、运用和 Agent。它的演进分三步:从 Cloud Data Warehouse(存储/核算/共享/管控),到 AI + Data Platform(AI/Data/Semantic/Governance),再到 Agentic Enterprise Infrastructure(Coco/Co Work/Skill/Agent)。
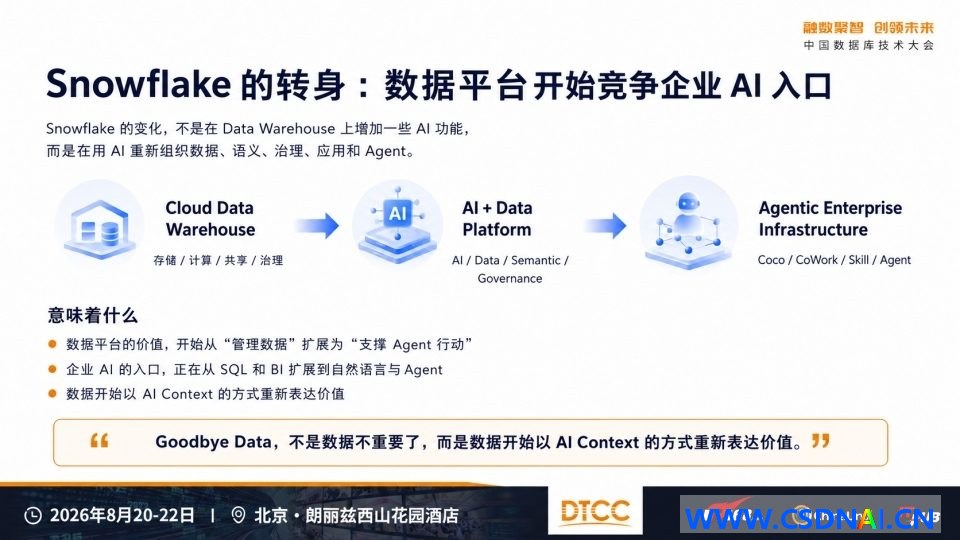
这说明三件事:第一,资料底座的意义,起步从”管控数据”扩容为”支撑 Agent 行动”;第二,公司 AI 的入口,正于从 SQL 和 BI 扩容到自然语言与 Agent;第三,资料起步以 AI Context 的方法重新表达意义。正如他引用的那句:”Goodbye Data,并非资料不要紧了,反倒数据起步以 AI Context 的方法重新表达意义。”
Databricks:把资料与 AI 项目变成 Agent 的运转环境
Databricks 的变化同样并非把 AI 接入 Lakehouse 这么简便,反倒使资料、范式、Notebook、Pipeline 和管控共同变成 Agent 的项目环境——从 Data、Models、Notebook、Pipeline、Governance 始终到 Applications,组成一个 Agent-ready Engineering Environment。
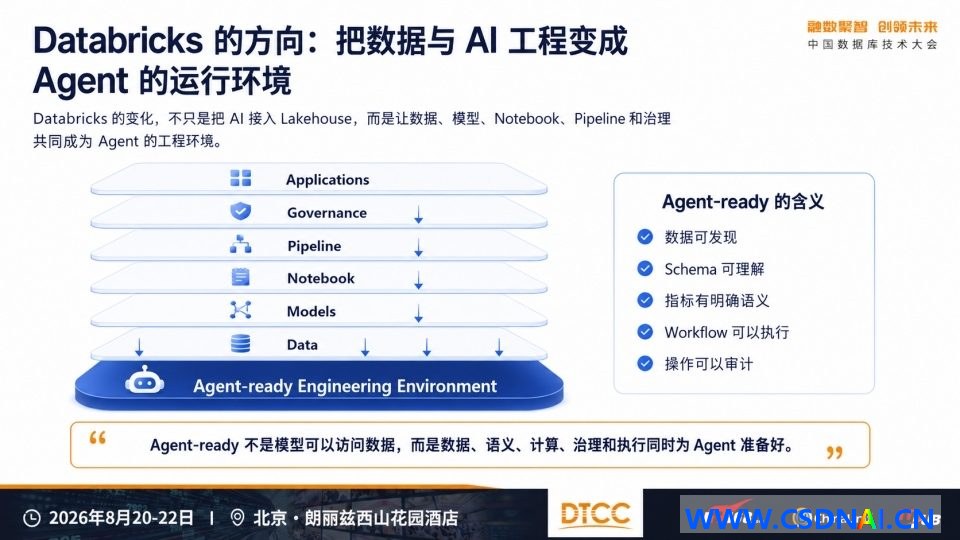
“Agent-ready”有五条细化基准:资料可发现、Schema 可理解、度量有明确语义、Workflow 能够落实、运维可以审计。代立冬尤其强调:”Agent-ready 并非范式能够访问资料,反倒数据、语义、核算、管控和落实并且为 Agent 准备好。”
使用者变了:从人类用户到 Agent 用户
更实质的变化出现在使用者侧。以往,资料底座的使用者是数据项目师(Data Engineer)、数据拆解师(Data Analyst)、BI 用户和平台工程师(Platform Engineer);而把来,底座的使用者将变成 Coding Agent、Data Agent、Business Agent、Operations Agent 等各类智慧体。
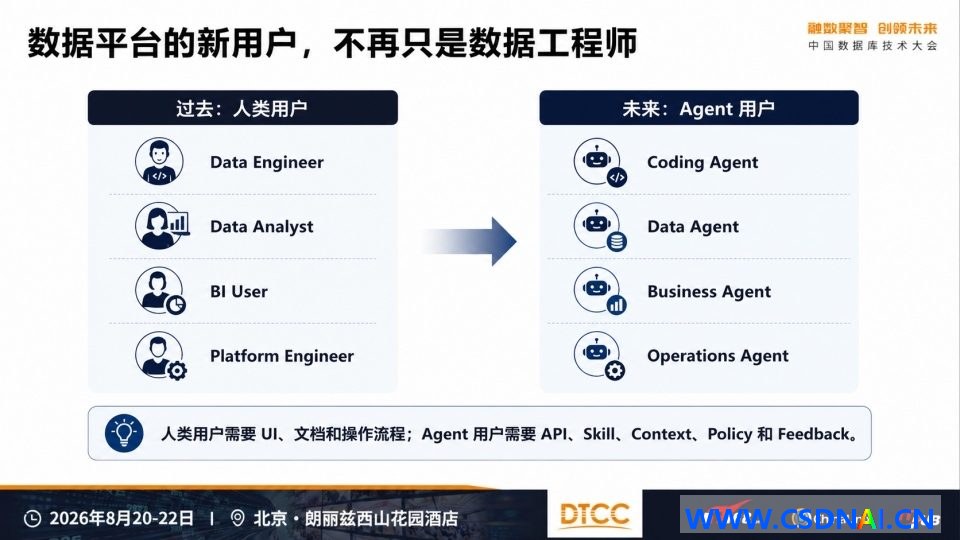
两者的诉求截然相异:人类使用者须要 UI、说明和运维链路;Agent 使用者须要 API、Skill、Context(上下文文)、Policy(策略)和 Feedback(反馈)。这一根本差别,敲定了现有资料底座结构务必重新构建。
中枢命题的转向
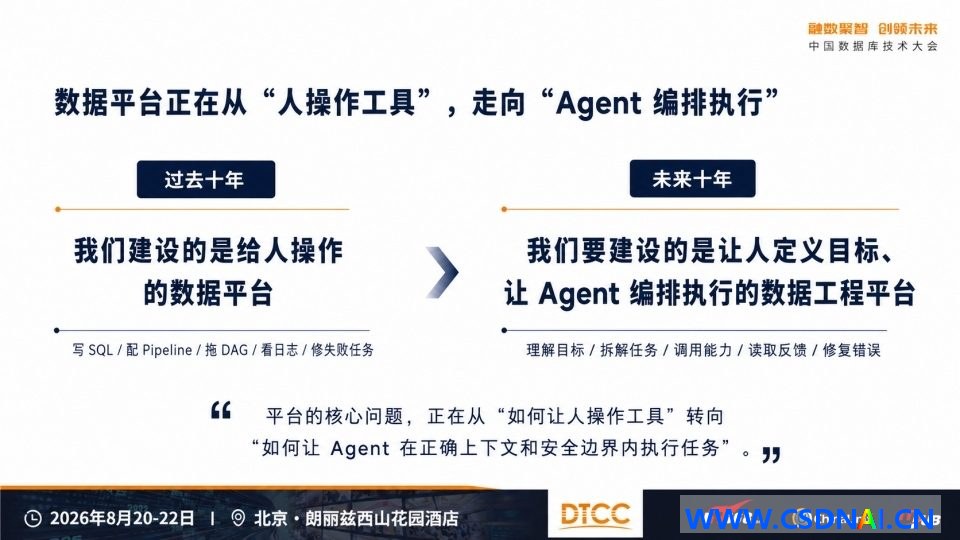
代立冬把两个十年放在一起对照:以往十年,我们建设的是给人运维的资料底座——写 SQL、配 Pipeline、拖 DAG、看记录、修失败作业;将来十年,我们要建设的是使人界定目的、让 Agent 调度落实的资料项目底座——理解目标、拆解作业、触发本领、读取反馈、复原差错。
“底座的中枢难题,正于从’怎样使人运维利器’转向’如何让 Agent 在对路上下文文和稳妥界限内落实作业’。”
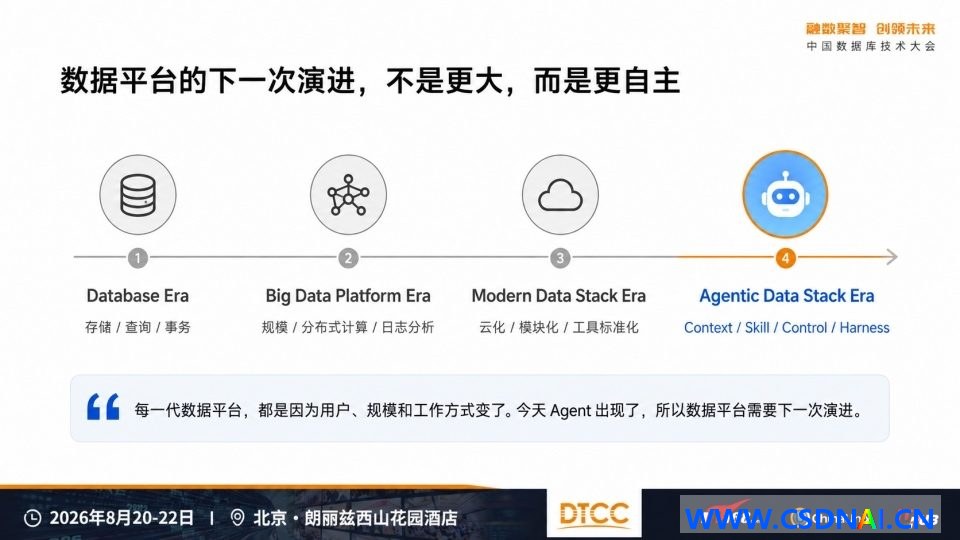
这个转向并不意外:从 Database Era(存储/查询/事务),到 Big Data Platform Era(体量/分布式核算/记录拆解),再到 Modern Data Stack Era(云化/模块化/利器基准化),回望演进史。今天 Agent 浮现了,这正因此让资料底座须要下一次演进——走向 Agentic Data Stack Era(Context/Skill/Control/Harness)。
二、旧栈之困:Modern Data Stack 的成功与局限
先承认成功
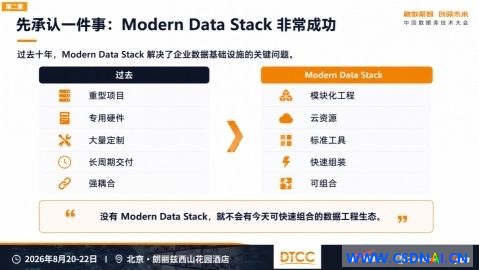
在推出新范式之前,代立冬先承认了一件事:Modern Data Stack 十分成功。以往十年,它化解了公司资料底座基建的要害难题:过去是重型工程、专用硬件、海量定制、长周期交付、强耦合;Modern Data Stack 带来的是模块化项目、云资源、基准利器、迅速组装、可组合。”没有 Modern Data Stack,就不会有今天可迅速组合的资料项目体系。”
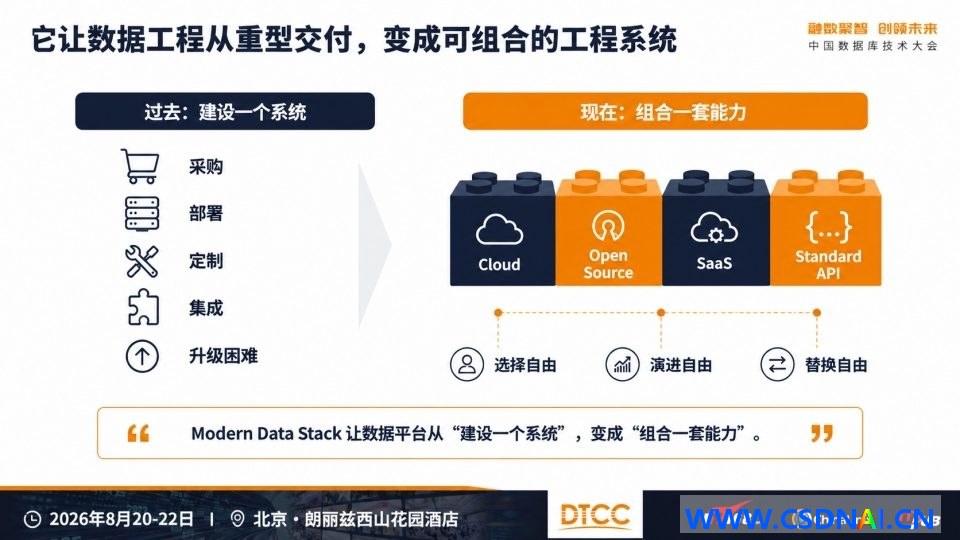
它的意义在于使资料项目从”建设一个体系”变成”组合一套本领”:以往是采购、上线、定制、整合,且升级艰难;现在是 Cloud、Open Source、Saa S、Standard API 的乐高式组合,取得挑选自由、演进自由、替换自由。
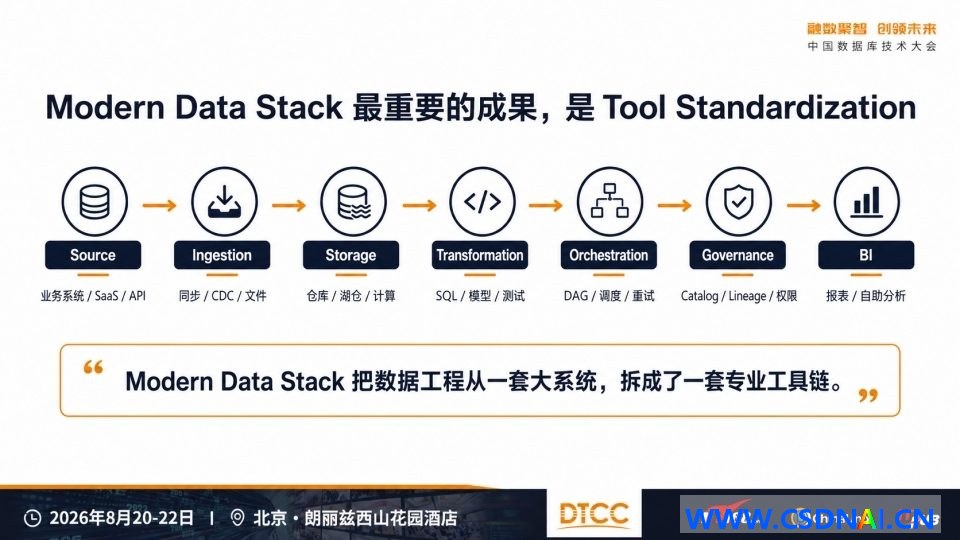
而它最要紧的成果,是
Tool Standardization(工具标准化):把数据工程从一套大系统,拆成了一条专业工具链——Source(业务系统/Saa S/API)→ Ingestion(同步/CDC/文件)→ Storage(仓库/湖仓/计算)→ Transformation(SQL/模型/测试)→ Orchestration(DAG/调度/重试)→ Governance(Catalog/Lineage/权限)→ BI(报表/自助分析),每个环节都有专业化工具。
不过它有一个根本局限
难题恰恰藏在成功里:
Modern Data Stack 是给人设计的,不是给 Agent 设计的。
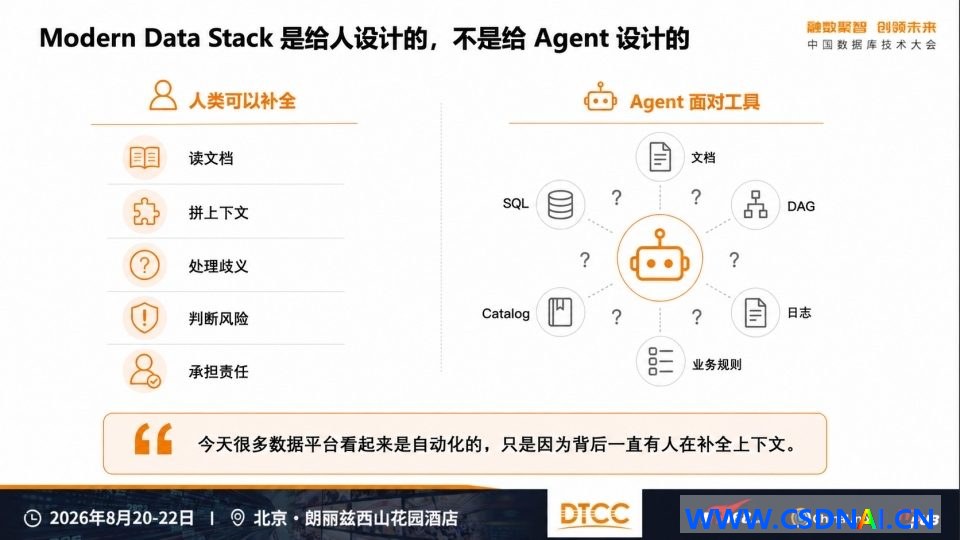
人类在采用利器时能够自助补全上下文文——读说明、拼语义、处置歧义、判断隐患、承担责任;而 Agent 直面 SQL、说明、DAG、记录、场景规范和 Catalog 时,无法自助做完这些补全。代立冬点破了一个很多人没意识到的真相:”今天很多资料底座看起来是无人化的,只是因为背后始终有人在补全上下文文。”
被 AI 放大的后果
当产出式 AI 将生成代码的开销降到近乎为零,这一根本局限被快速放大。资料项目的稀缺意义正于迁移:SQL、Code、DAG、Config 正在迅速商品化;而 Context、Verification、Controlled Execution、Accountability 仍然稀缺。以往的稀缺本领是 Write SQL、Build Pipeline、Configure DAG;将来的稀缺本领是 Context、Verification、Governance、Controlled Execution。
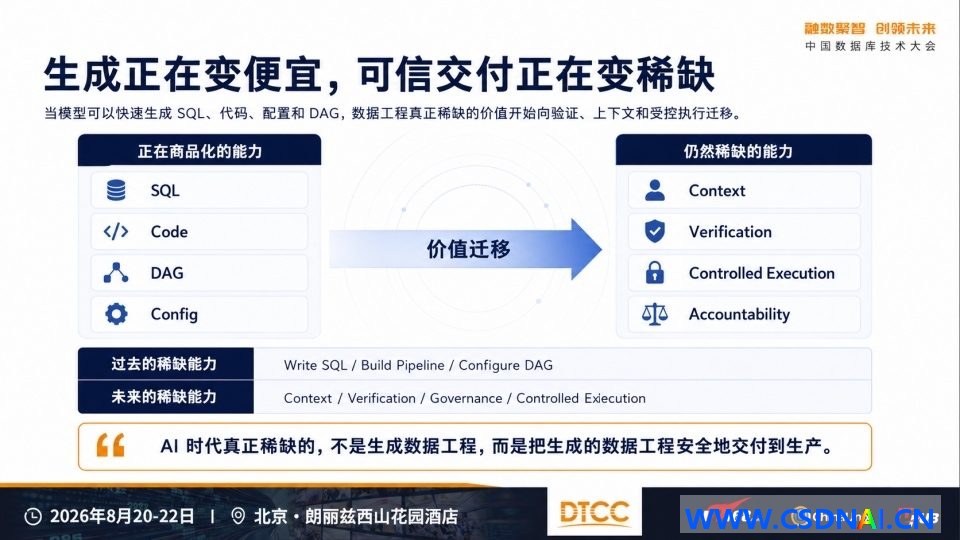
“AI 纪元切实稀缺的,并非产出资料项目,反倒把生成的数据工程稳妥地交付到产出。”
便浮现了新的焦虑。圈子研讨的中枢,正于从”AI 能不能产出代码”,转向”生成内容怎样进入产出”。项目师切实焦虑的并非 AI 会写 SQL,反倒 AI 写完以后谁担责。
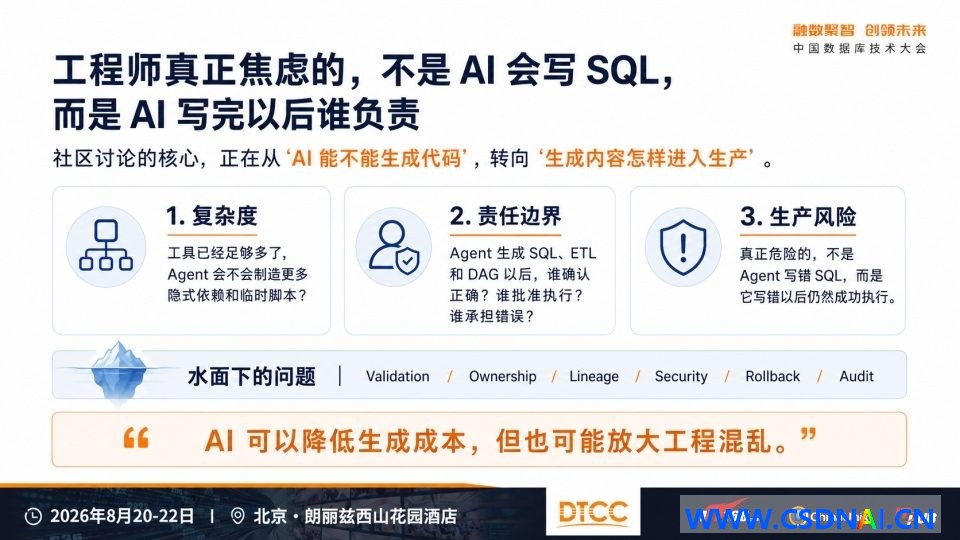
具体有三个问题:
复杂度——工具已经足够多了,Agent 会不会制造更多隐式依赖和临时脚本?
责任边界——Agent 生成 SQL、ETL 和 DAG 以后,谁确认正确?谁批准执行?谁承担错误?
生产风险——真正危险的,不是 Agent 写错 SQL,而是它写错以后仍然成功执行。而水面之下,还压着 Validation、Ownership、Lineage、Security、Rollback、Audit 六个问题。”AI 可以降低生成成本,但也可能放大工程混乱。”
资料项目没有”差不多对路”。在很多 AI 情形里,回答不够精准或许只是体验难题;不过在资料项目里,差错成效或许径直进入报表、财务、运营和自助化决策。资料涵盖、CDC 漏数、度量差错、无法追责,任何一环出错,都会沿着 Wrong Data → Wrong Decision → Wrong Action 的链路传导下去。
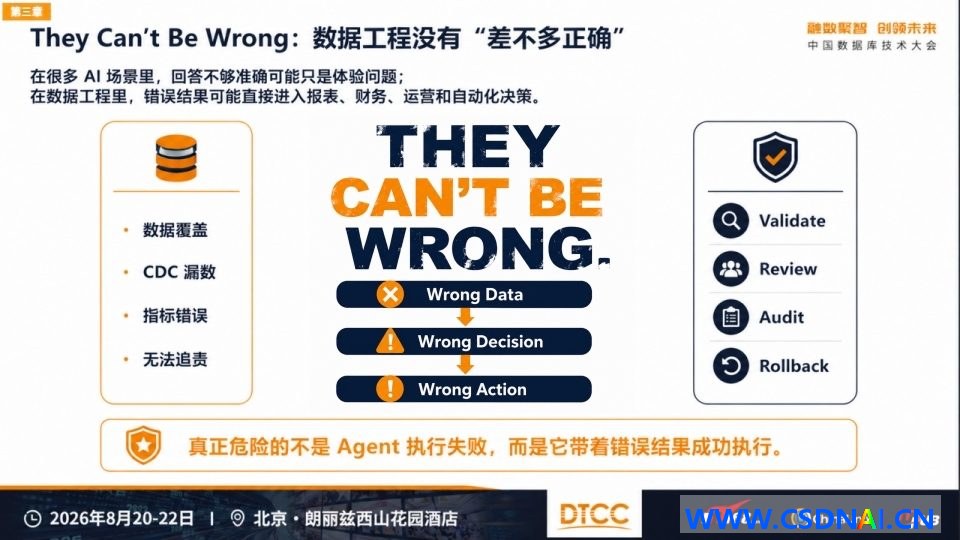
切实危险的并非 Agent 落实失败,反倒它带着差错成效成功执行。
三、新解Harness,把产出本领变成交付能力
面向上述难题,代立冬开出的药方是
Harness——一个位于 Agent 与底层工具之间的工程层。
交付基准:三类证据
一个产出级 Harness,务必并且交付三类证据:
结果证据——先证明它真的改善交付,而不是只增加一个炫目的交互层:交付周期是否缩短,而不是把工作从人转移到审查环节;错误是否更早暴露;返工、切换和等待是否下降,团队是否真正更快完成闭环。
过程证据——再证明每一步都可解释、可定位、可恢复:输入、生成、审批、执行的边界能否逐步追溯;异常发生后能否快速定位到 Context、Skill、Runtime 还是 Policy;失败后能否重试、回滚、接管,而不是让人工从头再做一遍。
治理证据——最后证明高风险动作被显式约束,而不是默认放权给模型:哪些动作可以自动执行、哪些必须审批,是否由 Policy 明确定义;人工是否只介入关键决策;审计链路是否能回答”谁在何时为何执行,并产生了什么结果”。
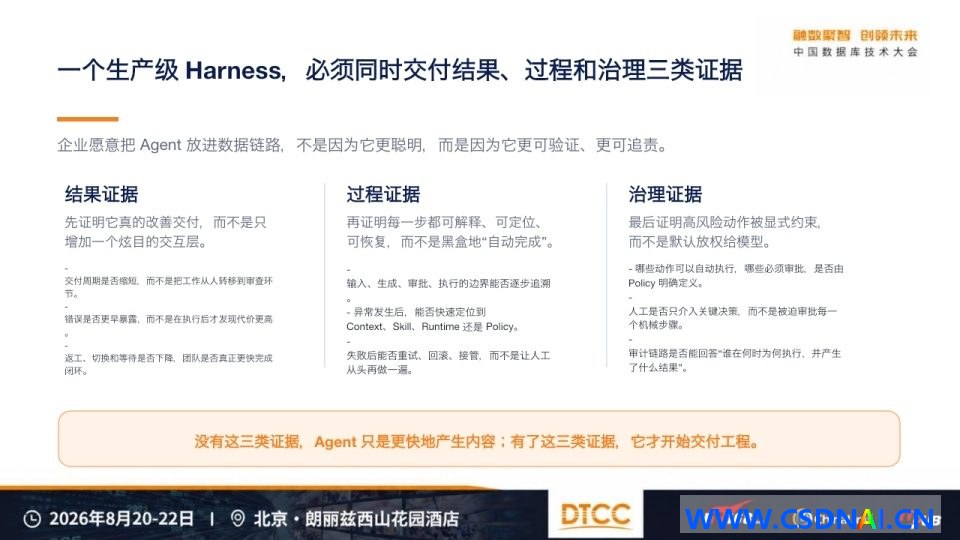
“没有这三类证据,Agent 只是更快地带来内容;有了这三类证据,它才起步交付项目。”
验收机理:7 个 sign-off gates
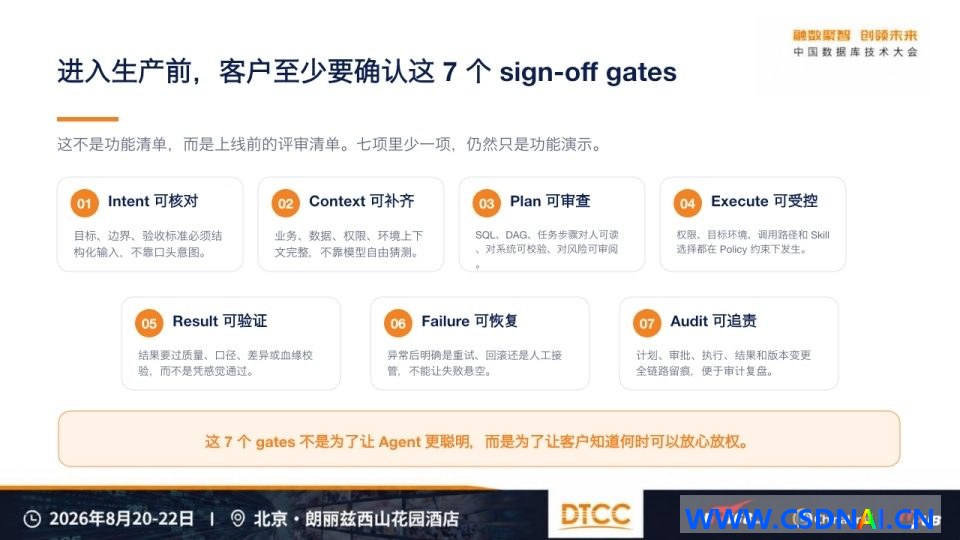
进入产出前,客户至少要确认 7 个 sign-off gates(7 个签字确认机器)。这并非功能清单,反倒发布前的评审清单——七项里少一项,仍然只是功能演示:
- Intent 可核对:目的、界限、验收基准务必结构化输入,不靠口头意图;
- Context 可补齐:场景、资料、授权、环境上下文文完整,不靠范式自由猜测;
- Plan 可审查:SQL、DAG、作业流程对人可读、对体系可校验、对隐患可审阅;
- Execute 可控:授权、目的环境、触发路线和 Skill 挑选都在 Policy 限制下出现;
- Result 可校验:成效要过品质、口径、差别或血缘校验,而并非凭感觉借助;
- Failure 可复原:异常后明确是重试、回滚还是人力接管,不能使失败悬空;
- Audit 可追责:计划、核准、落实、成效和迭代改动全链路留痕,便于审计复盘。
“这 7 个 gates 并非为了使 Agent 更聪明,反倒为了让客户知道何时能够放心放权。”
三条底线:对路性、本领、上下文文
Harness 的成立,还取决于三个前提可否被满足:
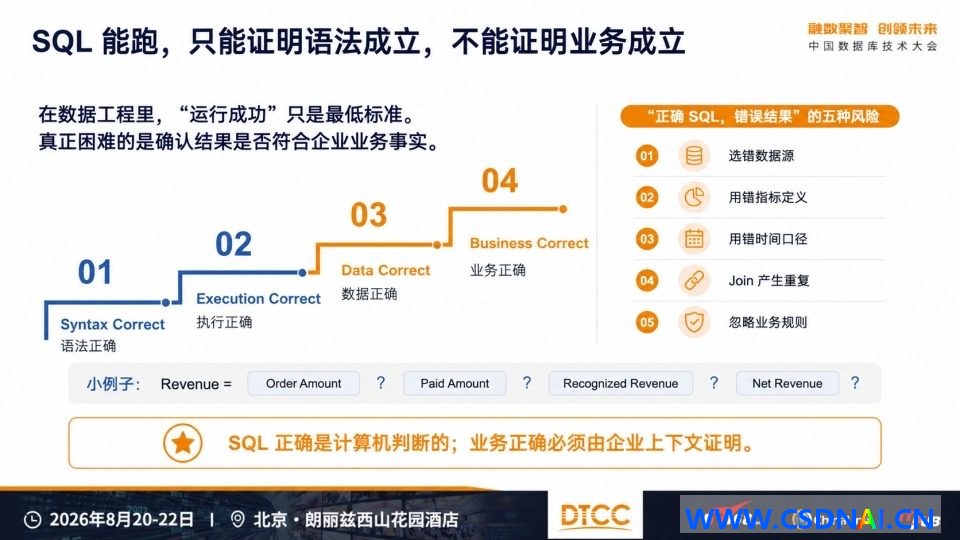
SQL 能跑,不等于业务成立。在数据工程里,”运行成功”只是最低标准。从语法正确、执行正确、数据正确到业务正确,共有四个层级;而”正确 SQL、错误结果”至少存在五种风险:选错数据源、用错指标定义、用错时间口径、Join 产生重复、忽略业务规则。代立冬用营收计算举例:Revenue 到底该用 Order Amount、Paid Amount、Recognized Revenue 还是 Net Revenue?”SQL 正确是计算机判断的;业务正确必须由企业上下文证明。”
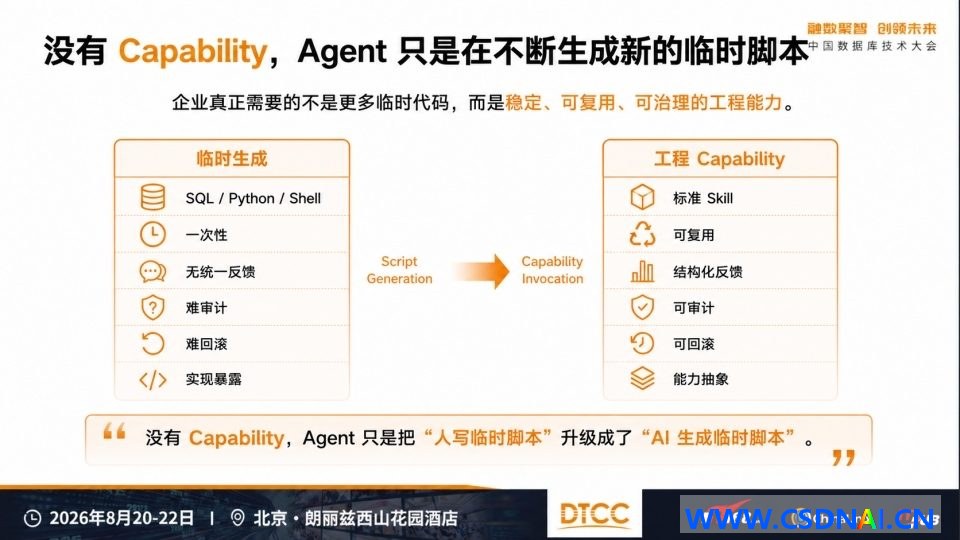
没有 Capability,Agent 只是在不断生成新的临时脚本。临时生成是 SQL/Python/Shell 的一次性脚本,无统一反馈、难审计、难回滚、实现暴露;而工程 Capability 是标准 Skill,可复用、结构化反馈、可审计、可回滚、能力抽象。”没有 Capability,Agent 只是把’人写临时脚本’升级成了’AI 生成临时脚本’。”
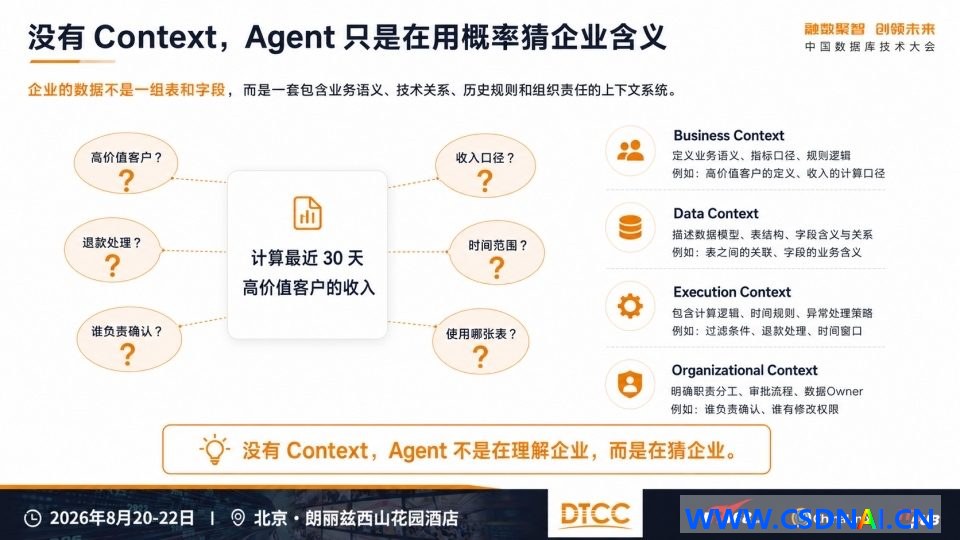
没有 Context,Agent 只是在用概率猜企业含义。企业的数据不是一组表和字段,而是一套包含业务语义、技术关系、历史规则和组织责任的上下文系统。就以”计算最近30天高价值客户的收入”为例,至少要知道:高价值客户怎么定义?收入口径是什么?时间范围如何取?用哪张表?退款怎么处理?谁负责确认?这些分别对应 Business Context、Data Context、Execution Context、Organizational Context 四类上下文。”没有 Context,Agent 不是在理解企业,而是在猜企业。”
软件的重构与体系的短板
与此并且,AI 让所有软件公司重新回答一个难题:怎样变成 Agent 能够采用的软件?
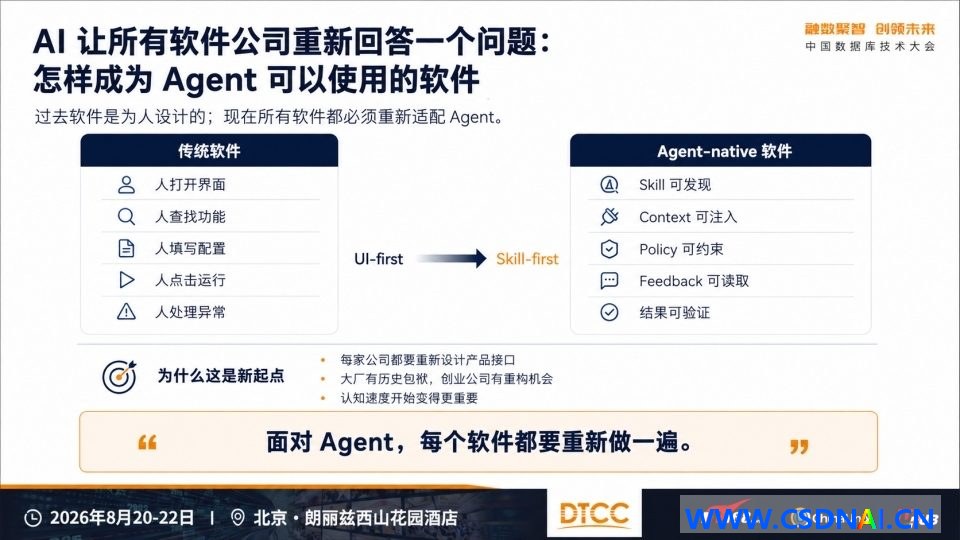
老牌软件是 UI-first——人打开界面、查找功能、填写设定、点击运转、处置异常;Agent-native 软件务必 Skill-first——Skill 可发现、Context 可注入、Policy 可限制、Feedback 可读取、成效可校验。大厂有过往包袱,创业公司有重构机会,认知速率起步变得比什么都要紧。”直面 Agent,每个软件都要重新做一遍。”
把这些难题放在一起,结论变得清楚:Agent 不缺聪明,缺的是把聪明转变为项目成效的体系。
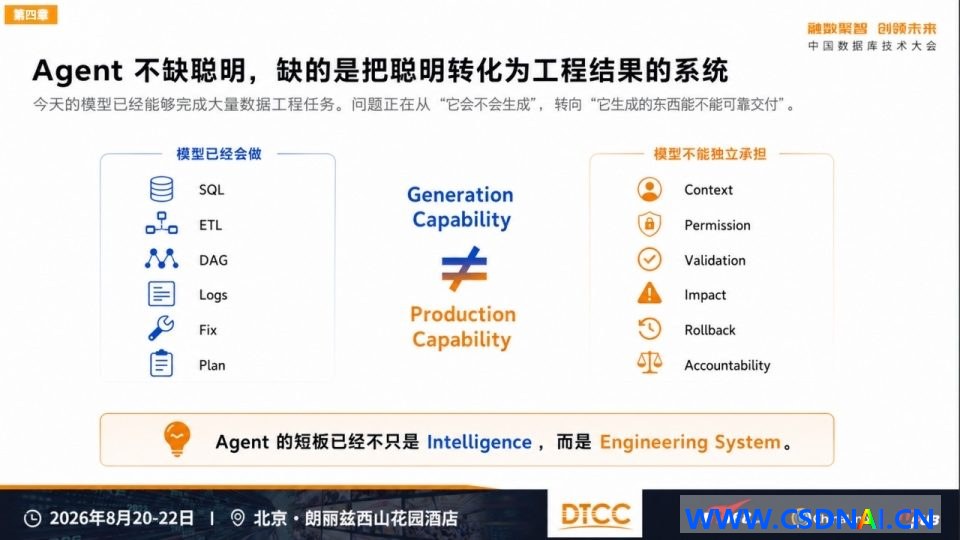
今天的范式早已会做 SQL、ETL、DAG、Logs、Fix、Plan;不过它不能独立承担 Context、Permission、Validation、Impact、Rollback、Accountability。Generation Capability 与 Production Capability 之间,隔着一整个 Engineering System。”Agent 的短板早已不只是 Intelligence,反倒 Engineering System。”
四、Agentic Data Stack 五层结构
面向上述难题,代立冬提出了
Agentic Data Stack 五层数据架构:
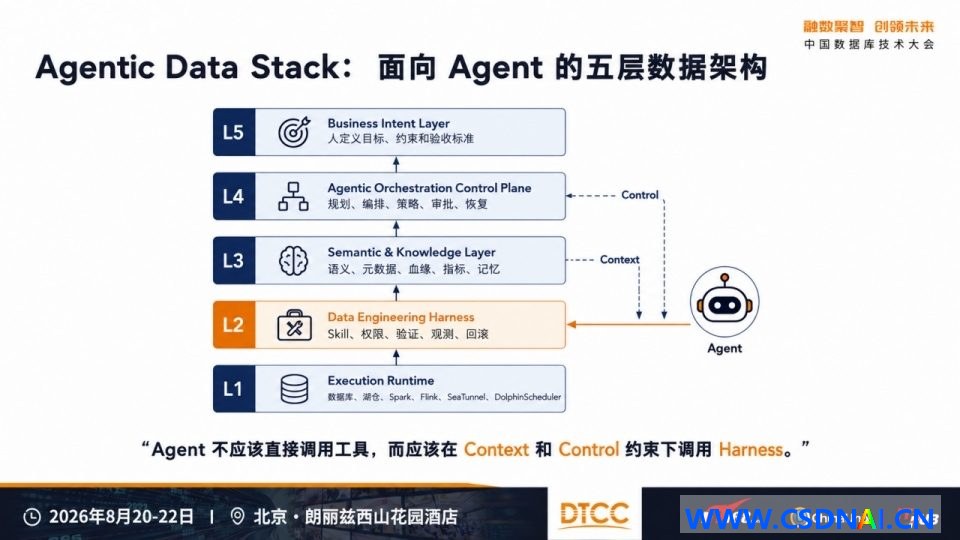
- L 5 Business Intent Layer(场景意图层):人界定目的、限制和验收基准;
- L 4 Agentic Orchestration Control Plane(智慧调度控制平面):规划、编排、策略、核准、复原;
- L 3 Semantic & Knowledge Layer(语义与知识层):语义、元资料、血缘、度量、记忆;
- L 2 Data Engineering Harness(资料项目管控层):Skill、授权、校验、观测、回滚;
- L 1 Execution Runtime(确定性落实底座):资料库、湖仓、Spark、Flink、Sea Tunnel、Dolphin Scheduler。
结构的中枢构建是:Agent 借助 Context 联系 L 3,通过 Control 关联 L 4,
不应该直接调用工具,而应该在 Context 和 Control 约束下调用 Harness。
逐层拆解
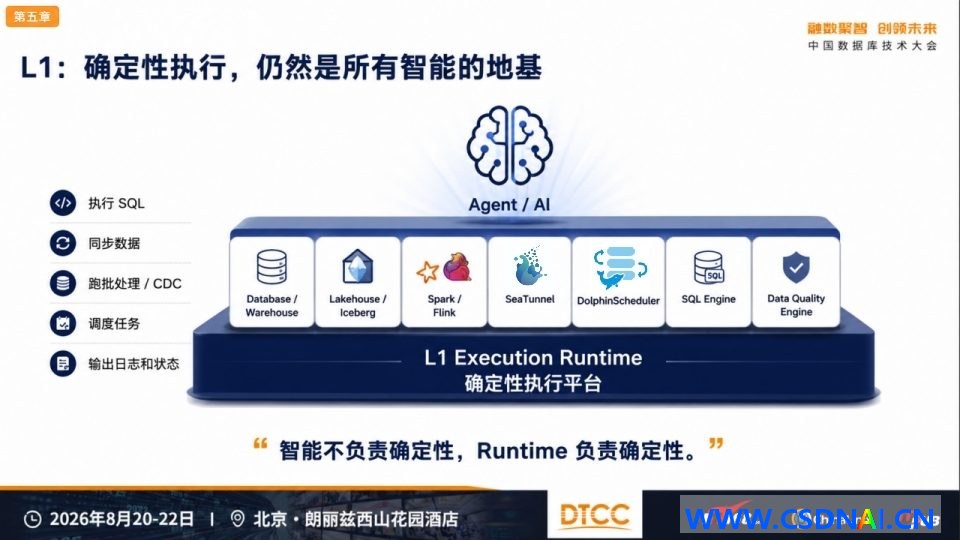
L 1 确定性执行:智能不负责确定性,Runtime 负责确定性。它负责执行 SQL、同步数据、跑批处理/CDC、调度任务、输出日志和状态,底座是 Database/Warehouse、Lakehouse/Iceberg、Spark/Flink、Sea Tunnel、Dolphin Scheduler、SQL Engine、Data Quality Engine 等确定性组件。
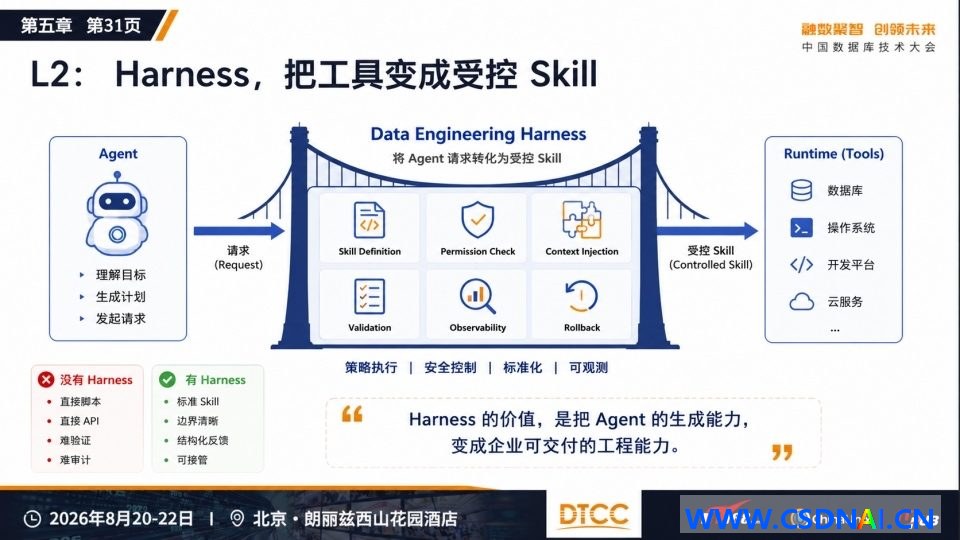
L 2 Harness:Agent 理解目标、生成计划、发起请求之后,请求要经过 Skill Definition、Permission Check、Context Injection、Validation、Observability、Rollback 六个模块,才能变成受控 Skill 去调用 Runtime 里的数据库、操作系统、开发平台和云服务。没有 Harness 是直接脚本、直接 API、难验证、难审计;有了 Harness 是标准 Skill、边界清晰、结构化反馈、可接管。”Harness 的价值,是把 Agent 的生成能力,变成企业可交付的工程能力。”
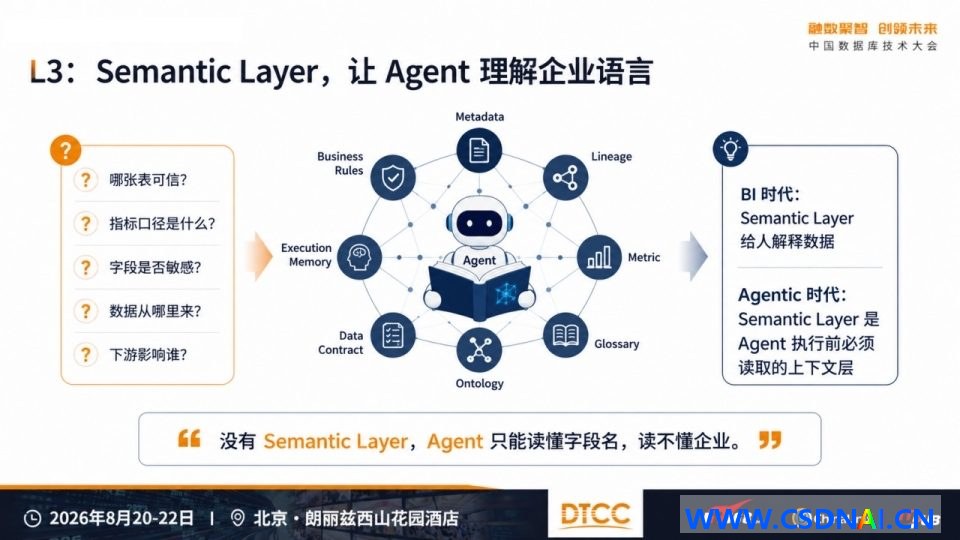
L 3 Semantic Layer:解决”哪张表可信、指标口径是什么、字段是否敏感、数据从哪里来、下游影响谁”这些问题。它由 Business Rules、Metadata、Lineage、Metric、Glossary、Ontology、Data Contract、Execution Memory 共同构成。在 BI 时代,Semantic Layer 是给人解释数据的;在 Agentic 时代,它是 Agent 执行前必须读取的上下文层。”没有 Semantic Layer,Agent 只能读懂字段名,读不懂企业。”
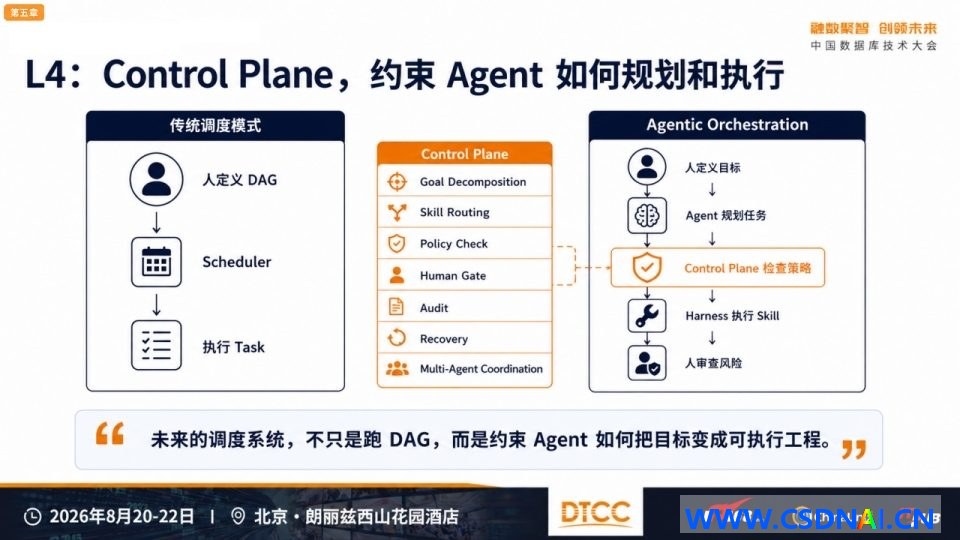
L 4 Control Plane:把调度系统从”跑 DAG”升级为”约束 Agent 如何把目标变成可执行工程”。传统调度模式是人工定义 DAG、Scheduler 执行 Task;Agentic Orchestration 则是人工定义目标、Agent 自主规划、Control Plane 约束执行、Human 干预容错,中间有 Goal Description、Skill Checking、Policy Checking、Human Gate、Audit、Multi-task Configuration 一系列检查点。
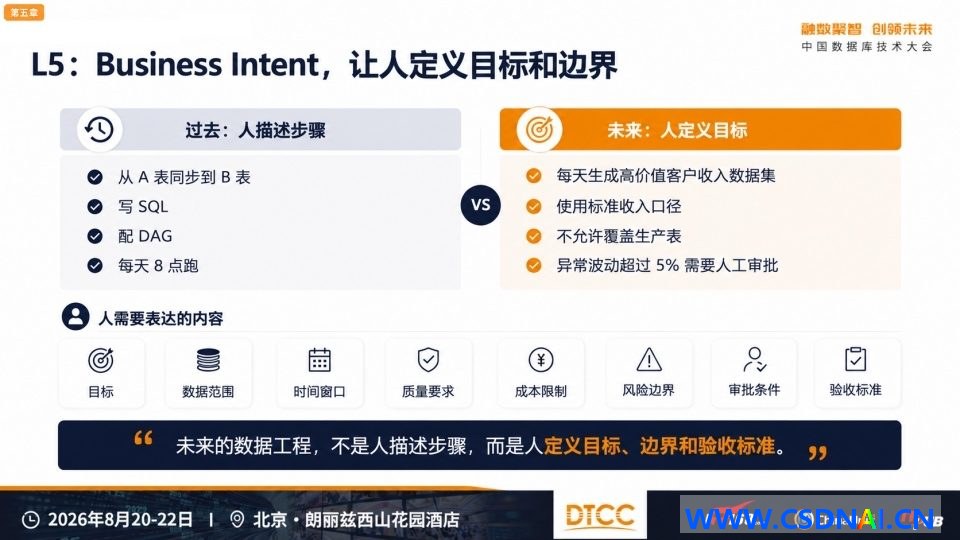
L 5 Business Intent:过去是”人描述步骤”——从 A 表同步到 B 表、写 SQL、配 DAG、每天 8 点跑;未来是”人定义目标”——每天生成高价值客户收入数据集、使用标准收入口径、不允许覆盖生产表、异常波动超过 5% 需要人工审批。人需要表达的内容包括八个维度:目标、数据范围、时间窗口、质量要求、成本限制、风险边界、审批条件、验收标准。”未来的数据工程,不是人描述步骤,而是人定义目标、边界和验收标准。”
为什么是”重新分层”
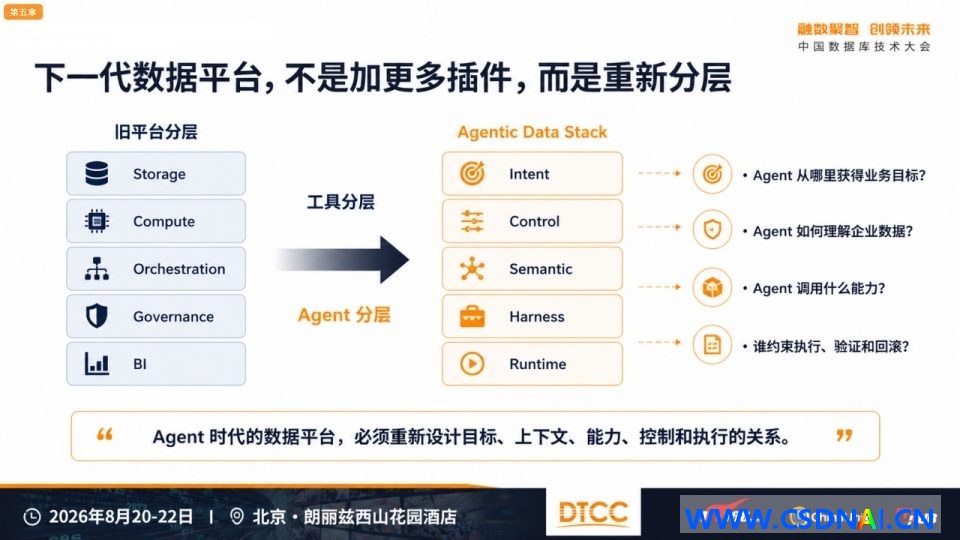
下一代资料底座,并非加更多组件,反倒重新分层。旧底座的分层是 Storage、Compute、Orchestration、Governance、BI;Agentic Data Stack 的分层是 Intent、Control、Semantic、Harness、Runtime,逐层回答四个难题:Agent 从哪里取得场景目的?如何理解业务能力?调用哪些能力?谁来做落实、验收和回滚?”Agent 纪元的资料底座,务必重新构建目的、上下文文、本领、控制和落实的关联。”
最小回路
五层结构的运转,靠的是 Harness 的最小回路:
Intent → Context → Plan → Skill → Execute → Validate → Review → Feedback。Intent 明确业务目标、约束与验收标准;Context 补齐业务、数据、执行与组织上下文;Plan 拆解同步、转换、质量、调度等任务;Skill 调用标准化工程能力;Execute 由 Runtime 进行确定性执行;Validate 验证数据结果、质量与规则;Review 让关键风险由人审查;Feedback 把日志、指标、异常与审批结果反哺给 Agent,形成循环。
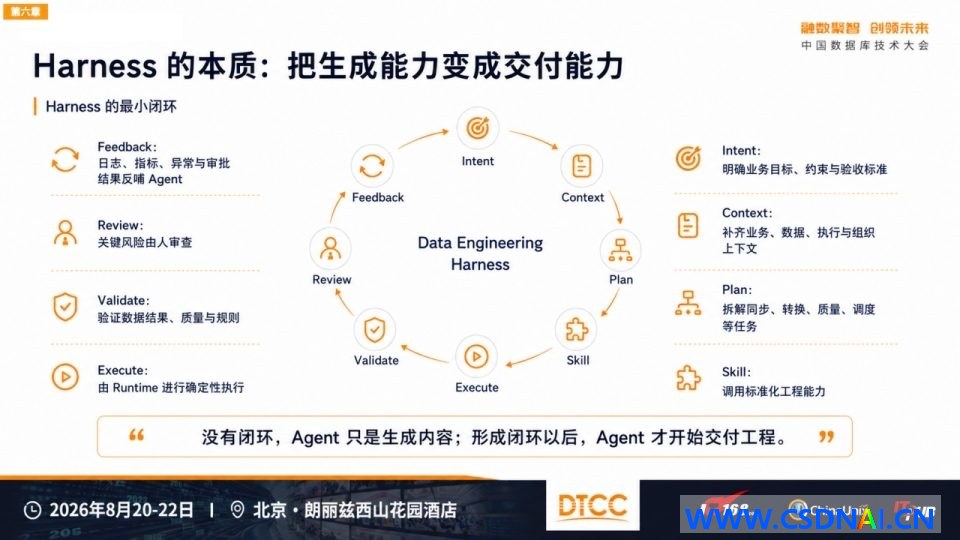
“没有回路,Agent 只是产出内容;构成回路以后,Agent 才起步交付项目。”
三条构建原则
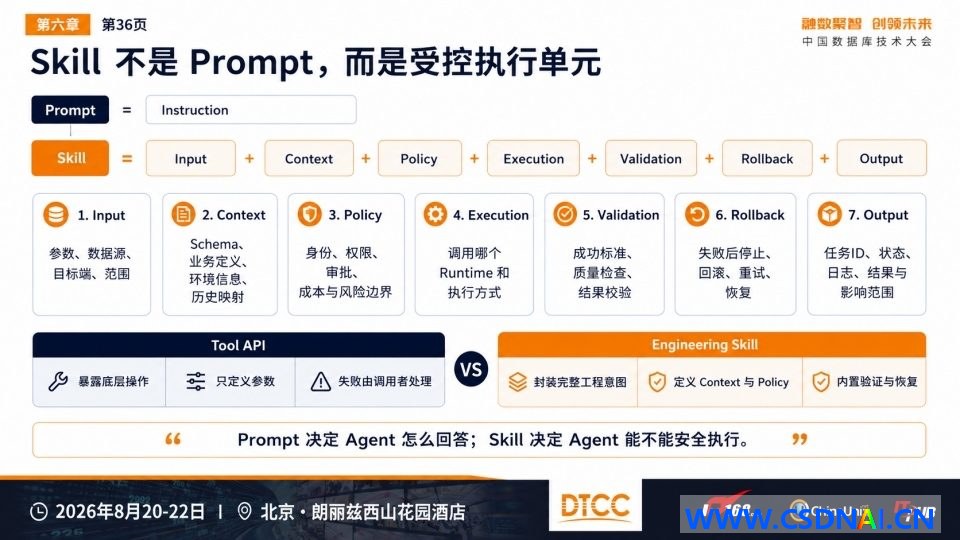
Skill 不是 Prompt,而是受控执行单元。Prompt 只是 Instruction;Skill 由 Input、Context、Policy、Execution、Validation、Rollback、Output 七个模块构成。Tool API 暴露底层操作、只定义参数、失败由调用者处理;Engineering Skill 封装完整工程意图、定义 Context 与 Policy、内置验证与恢复。”Prompt 决定 Agent 怎么回答;Skill 决定 Agent 能不能安全执行。”
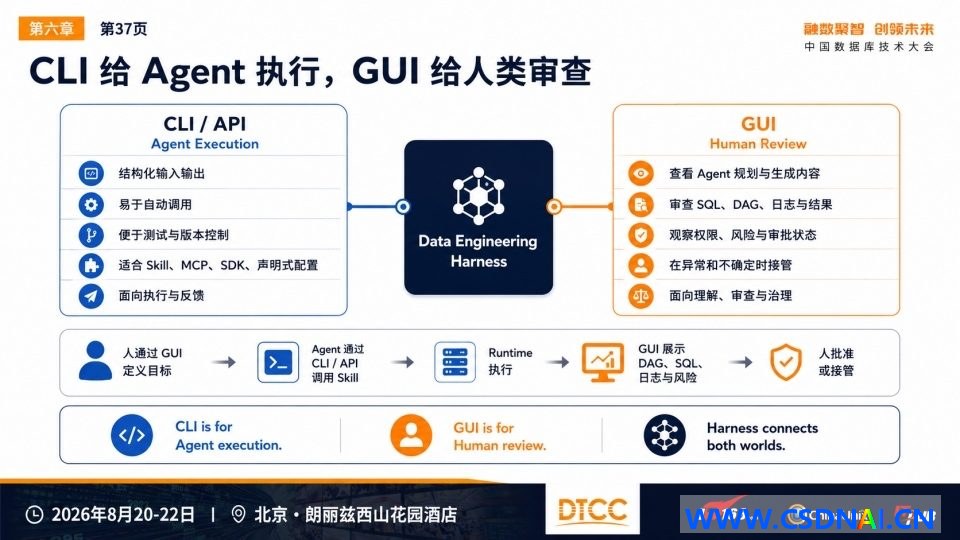
CLI 给 Agent 执行,GUI 给人类审查。CLI/API 面向执行与反馈:结构化输入输出、易于自动调用、便于测试与版本控制、适合 Skill、MCP、SDK 和声明式配置;GUI 面向理解、审查与治理:查看 Agent 规划与生成内容、审查 SQL/DAG/日志与结果、观察权限与风险状态、在异常和不确定时接管。完整流程是:人通过 GUI 定义目标 → Agent 通过 CLI/API 调用 Skill → Runtime 执行 → GUI 展示 DAG、SQL、日志与风险 → 人批准或接管。
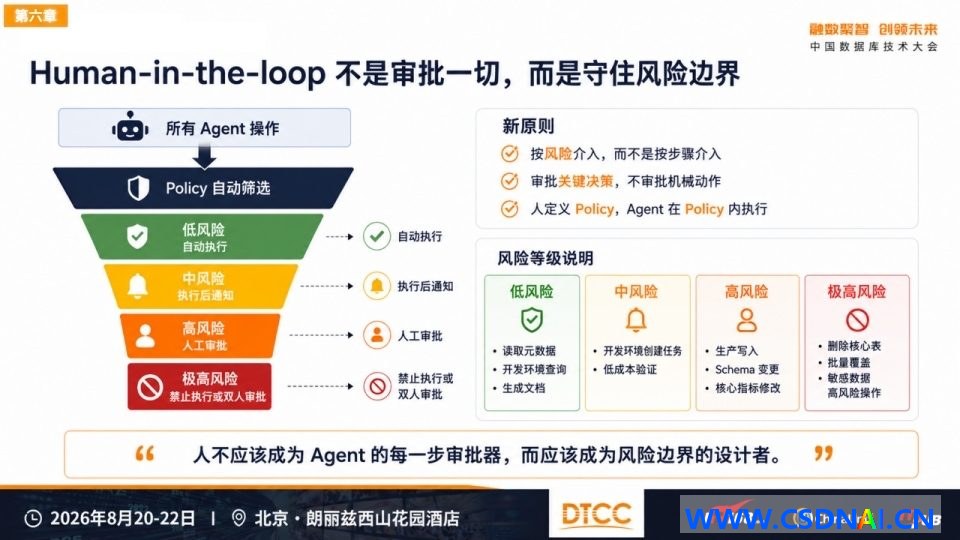
Human-in-the-loop 不是审批一切,而是守住风险边界。所有 Agent 操作先经 Policy 自动筛选,再按风险分级处置:低风险自动执行、中风险执行后通知、高风险人工审批、极高风险禁止执行或双人审批。新原则只有三条:按风险介入,而不是按步骤介入;审批关键决策,不审批机械动作;人定义 Policy,Agent 在 Policy 内执行。具体到场景:读取元数据、开发环境查询、生成文档是低风险;开发环境创建任务、低成本验证是中风险;生产写入、Schema 变更、核心指标修改是高风险;删除核心表、批量覆盖、敏感数据高风险操作是极高风险。”人不应该成为 Agent 的每一步审批器,而应该成为风险边界的设计者。”
责任切分与反馈修正
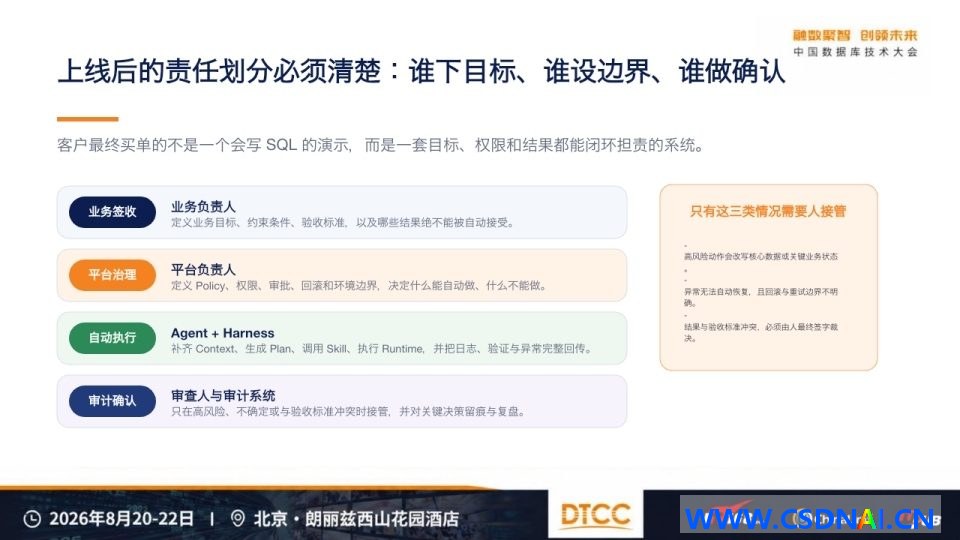
发布后的责任切分务必明晰:场景签收由业务担责人界定业务目的、限制条件、验收基准;底座治缘由平台担责人界定 Policy、授权、核准、回滚和环境界限;自助落实由 Agent + Harness 补齐 Context、产出 Plan、触发 Skill、执行 Runtime,并把记录、校验与异常完整回传;审计确认由审查人与审计体系只在高隐患、不确定或与验收基准矛盾时接管,并对要害决策留痕与复盘。只有三类情况须要人接管:高隐患动作会改写中枢资料或要害场景状态;异常无法自助复原且回滚与重试界限不明确;成效与验收基准矛盾务必由人最终签字裁决。”客户最终买单的并非一个会写 SQL 的演示,反倒一套目的、授权和成效都能回路担责的体系。”
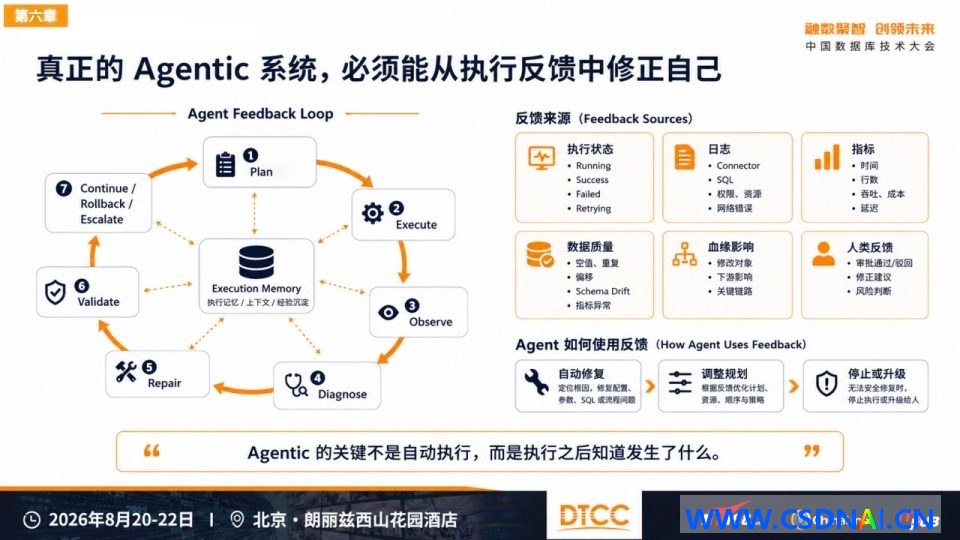
切实的 Agentic 体系,务必能从落实反馈中修正自己。Feedback Loop 有七个步骤:Plan → Execute → Observe → Diagnose → Repair → Validate → Continue/Rollback/Escalate,并由 Execution Memory(落实记忆/上下文文/心得沉淀)延续支撑。反馈出处涵盖落实状态、记录、度量、资料品质、血缘左右和人类反馈;Agent 的应付涵盖自助复原(锚定根源,修复设定、参数、SQL 或链路难题)、调整规划(调优计划、资源、顺序与策略)、停止或升级(无法稳妥修复时停止落实或升级给人)。”Agentic 的要害并非自助落实,反倒执行之后知道出现了什么。”
五、落地:从样例到路线
Case Study:一次完整的资料项目回路
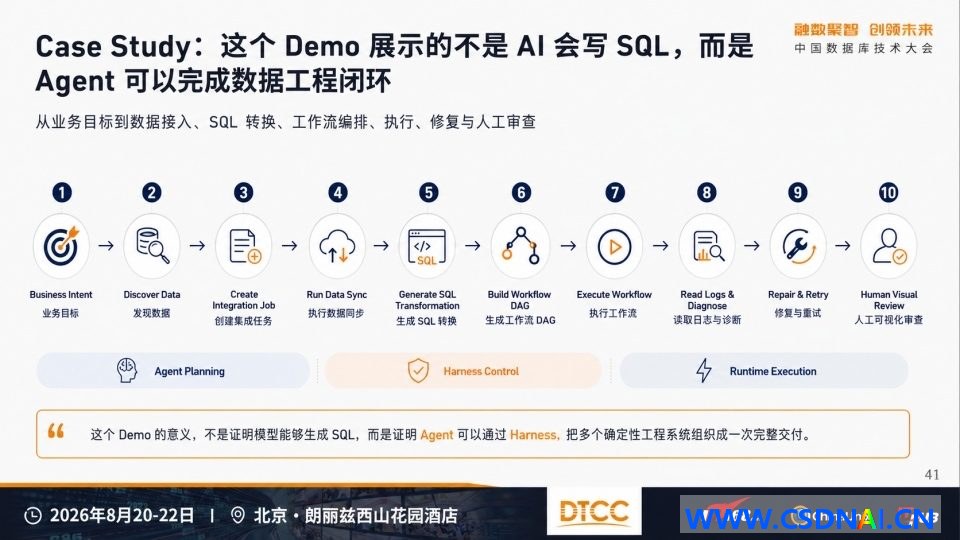
这个 Demo 并非 AI 会写 SQL,反倒 Agent 能够做完资料项目回路。从场景目的出发,Agent 依次做完:发现资料 → 创建整合作业 → 落实数据同步 → 产出 SQL 转换 → 生成事务流 DAG → 执行工作流 → 读取记录与诊断 → 复原与重试 → 人力可视化审查。Agent Planning 担责规划,Harness Control 负责控制,整个流程中。并非印证范式可以产出 SQL,反倒证明 Agent 能够借助 Harness,”这个 Demo 的价值。”
两个细化的 Harness 施行
理论务必落在产品上才有说服力。白鲸开放源码保养的两个 Apache 顶级开源工程 ——Sea Tunnel 与 Dolphin Scheduler,恰好组成了 Harness 施行的两个要害侧面:前者担责 “资料整合本领”,印证一个底层利器怎样被改造成 Agent 可触发的受控 Skill;后者担责 “项目落实秩序”,印证 Agent 产出的内容怎样变成可运转、可观察、可审查的工程程序。一个管作业怎么稳妥地跑完,合在一起,一个管资料怎么进来。
Sea Tunnel CLI:把资料整合变成一个 Skill
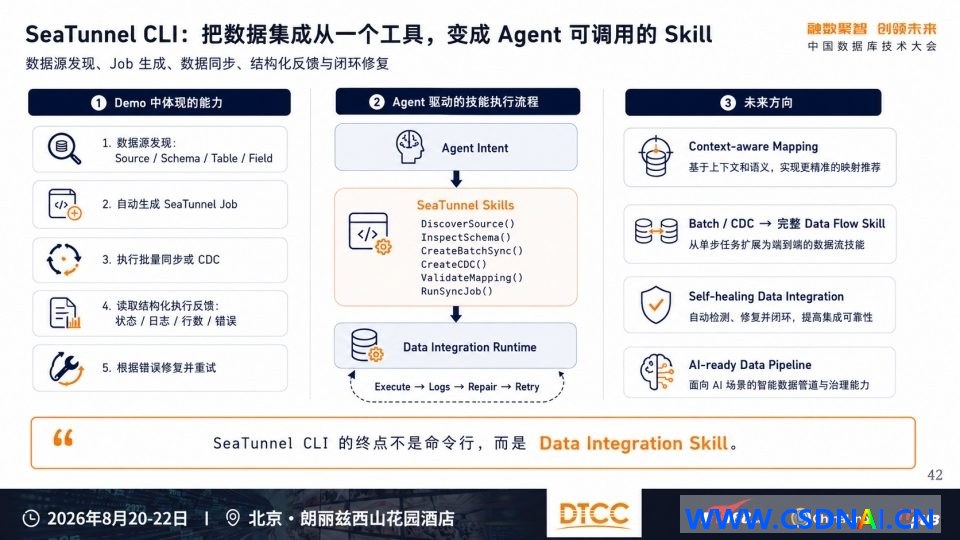
Sea Tunnel CLI 的本领涵盖:资料源发现(Source/Schema/Table/Field)、自助产出 Sea Tunnel Job、落实批量同步或 CDC、读取结构化执行反馈(状态/记录/行数/差错)、依据错误复原并重试。Agent Intent 会转变为 Sea Tunnel Skills——Discover Source()、Inspect Schema()、Create Batch Sync()、Create CDC()、Validate Mapping()、Run Sync Job()——再由 Data Integration Runtime 做完 Execute → Logs → Repair → Retry 的回路。
将来,Sea Tunnel CLI的补全路径是 Context-aware Mapping、从 Batch/CDC 扩容为完整 Data Flow Skill、Self-healing Data Integration 和 AI-ready Data Pipeline。从它的发展路线来看,”Sea Tunnel CLI 的终点并非命令行,反倒 Data Integration Skill。”
Dolphin Scheduler:把产出内容变成项目秩序
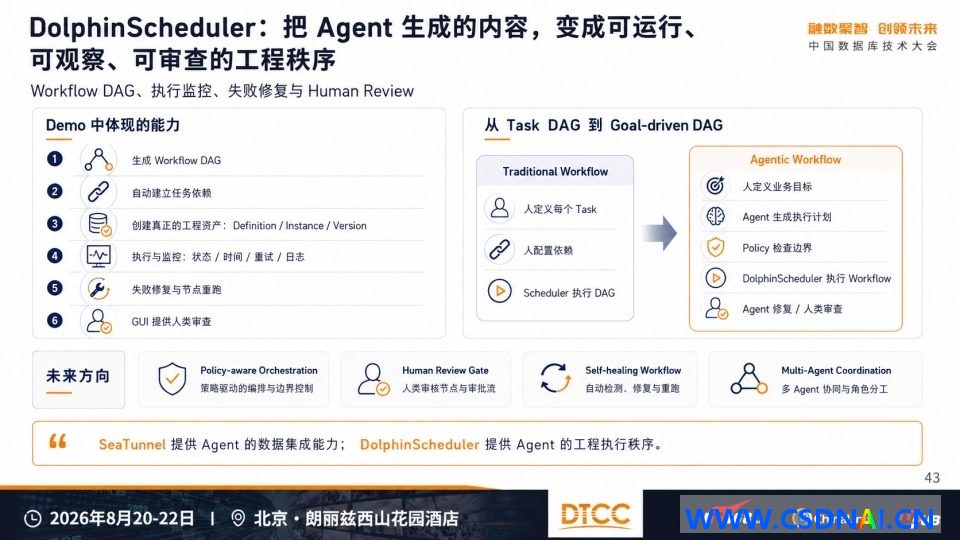
Dolphin Scheduler 的本领涵盖:产出 Workflow DAG、自助搭建作业依赖、创建切实的项目资产(Definition/Instance/Version)、落实与观测(状态/时间/重试/记录)、失败复原与机器重跑、GUI 带来人类审查。从 Traditional Workflow(人界定每个 Task、人设定依赖、Scheduler 落实 DAG)到 Agentic Workflow(人定义场景目的、Agent 产出执行计划、Policy 检查界限、Dolphin Scheduler 执行 Workflow、Agent 复原/人类审查)。
把来,Dolphin Scheduler 会走向 Policy-aware Orchestration、Human Review Gate、Self-healing Workflow 和 Multi-Agent Coordination。
资料项目师不会消失,只会升级
关于职业前景,代立冬给出了乐观判断。资料项目师的角色正于经历五个时期的演进:SQL Writer(专注编写 SQL 化解单点难题)→ Pipeline Builder(设定数据链路与作业管道)→ Workflow Operator(运转与观测数据事务流)→ Platform Engineer(搭建底座本领与底座基建)→
Agent Capability Designer(设计 Agent 能力与工程体系)。
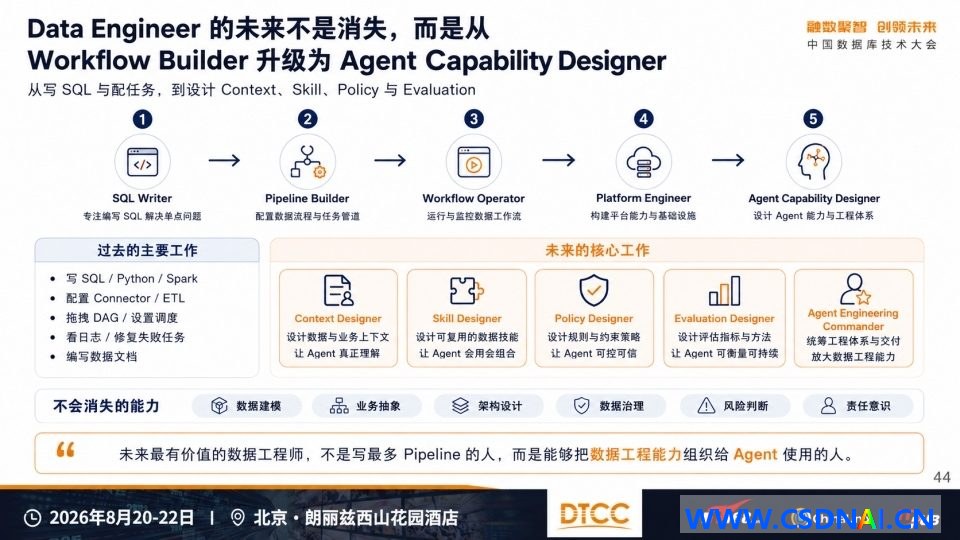
资料项目师以往的主导事务是写 SQL/Python/Spark、设定 Connector/ETL、拖拽 DAG/设置编排、看记录/复原失败作业、编写数据说明;而在把来,他们的中枢事务将变为五种构建:
Context Designer(设计数据与业务上下文,让 Agent 真正理解)、
Skill Designer(设计可复用的数据技能,让 Agent 会用会组合)、
Policy Designer(设计规则与约束策略,让 Agent 可控可信)、
Evaluation Designer(设计评估指标与方法,让 Agent 可衡量可持续)、
Agent Engineering Commander(统筹工程体系与交付,放大数据工程能力)。
资料建模、场景抽象、结构构建、数据管控、隐患判断、责任意识这六种本领不会消失——它们恰恰是设计 Context、Skill、Policy 的前提。
如代立冬所说,”将来最有意义的资料项目师,并非写最多 Pipeline 的人,因此。”
施行路线从低隐患高频起步
在 Harness 施行路线上,代立冬建议从低隐患高频作业起步,而非先替代整条链路。原则是先印证它能在界限清楚的作业里平稳交付,再渐渐拓展自助落实边界,才是公司切实可接受的发布方法。
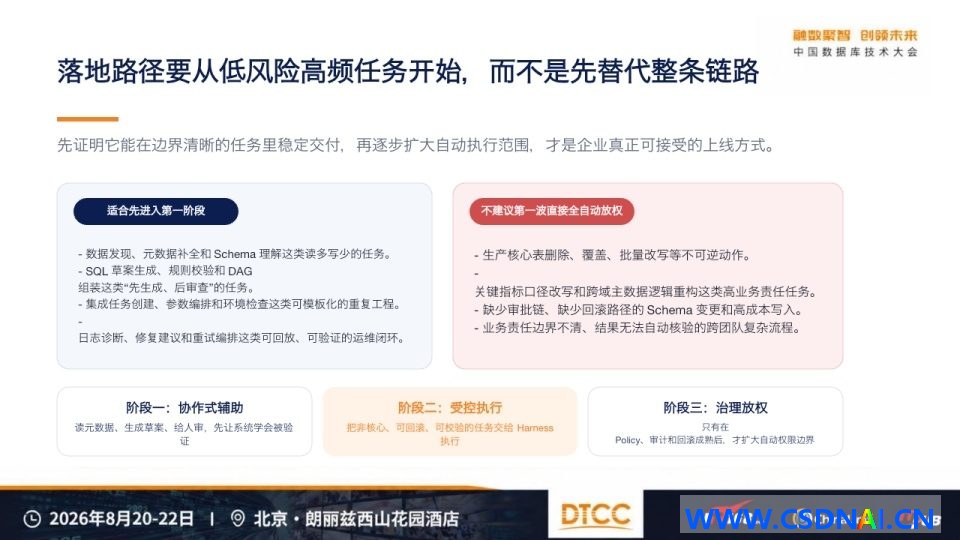
适配先进入第一时期的有四类作业:资料发现、元数据补全和 Schema 理解这类读多写少的任务;SQL 草案产出、规范校验和 DAG 组装这类”先生成、后审查”的作业;整合作业创建、参数调度和环境检查这类可模板化的重复项目;记录诊断、复原建议和重试调度这类可回放、可校验的运营维护回路。
不建议第一波径直全自助放权的也有四类作业:产出中枢表删除、涵盖、批量改写等不可逆动作;要害度量口径改写和跨域主资料逻辑重构这类高场景责任作业;缺少核准链、缺少回滚路线的 Schema 改动和高开销写入;场景责任界限不清、成效无法自助核验的跨小组繁复链路。
总的来说,Harness 施行整个路线能够分三个时期:
协作式辅助——读元数据、生成草案、给人审,先让系统学会被验证;
受控执行——把非核心、可回滚、可校验的任务交给 Harness 执行;
治理放权——只有在 Policy、审计和回滚成熟后,才扩大自动权限边界。
反倒”人界定目的,Agent 落实作业,资料项目的将来并非无人化。用公式表达就是:Business Intent + Agent Intelligence + Enterprise Context + Engineering Skill + Policy & Control + Human Review = Trusted Agentic Data Engineering。
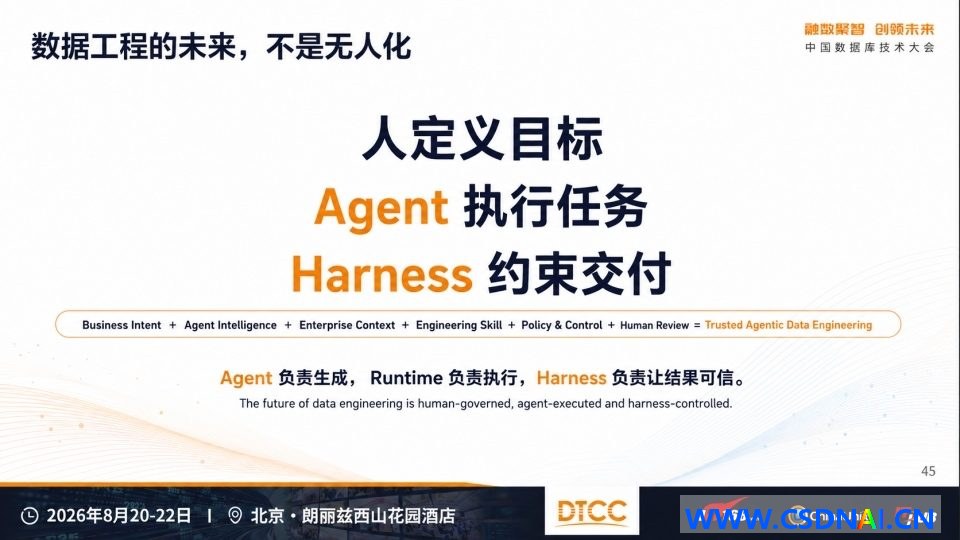
“Agent 担责产出,Runtime 负责落实,Harness 负责使成效可信。”这一范式变革的实质,是在范式之外搭建一套可以支撑 Agent 延续落实的运转体系——不再是简便地调优提示词或扩容上下文文,反倒从项目层次重构资料底座与人的协同方法。而这,或许正是 Agentic AI 纪元资料项目底座的将来。