作者:vivo 互联网项目团队- Ding Junjie
结合 AI 编辑器二期调研实践,拆解 Agent 在协同文档中的身份取舍、可回放事实链、side-by-side Diff 展示,以及 run 级精准撤回机制,说明如何让 AI 的改动看得见、退得掉、不误伤协作者。
一、背景
想象一下,AI 不再只是一个问答机器,而是真正走进协同文档,成为并肩作战的伙伴。它不只是提供答案,而是直接参与内容的创作与修改。这听起来很酷,但当 AI 的”大手”伸进共同编辑的文档时,事情立刻变得复杂。
在多人协同的文档世界里,文档不再是某个人的专属领地。这里有你,有我,有其他同事。现在,AI 这个新成员也要加入进来,一起”指点江山”。
真正的难题不止是”AI 能不能写得好”,而是:当 AI 以惊人的速度和规模进行编辑时,如何确保它能与人类的精细化编辑和谐共存,而不是破坏我们对协同工作的信任感?
在开发知识库 AI 编辑器二期时,我们深入调研后发现,这远不止是一个模型问题,更是一个深层次的协同架构挑战。关键不在于让 AI 把文字敲进文档,而在于如何明确它在协同系统中的”身份”,并通过一套可回滚、可对比的机制,将 AI 的编辑行为纳入一个真正透明、可控的协作流程。
二、身份之问:Agent 扮演什么样的角色
“撤销/重做”(Undo/Redo)功能,是上世纪 70 年代留给我们的一个经典 UI 约定。它之所以深入人心,是因为它足够直观:我们相信按下 Ctrl+Z,系统就会乖乖地退回到”我刚才做的那一步”。
然而,当 Agent 踏入协同文档的舞台,这个约定瞬间失灵了。因为文档的改动不再仅仅源于”我”的双手,还可能来自 AI,来自其他协作者。此时,系统必须直面一个根本性的问题:Agent 应该以怎样的身份参与到这场多人协作中?
在实际探索中,我们仔细对比了三种不同的模式:
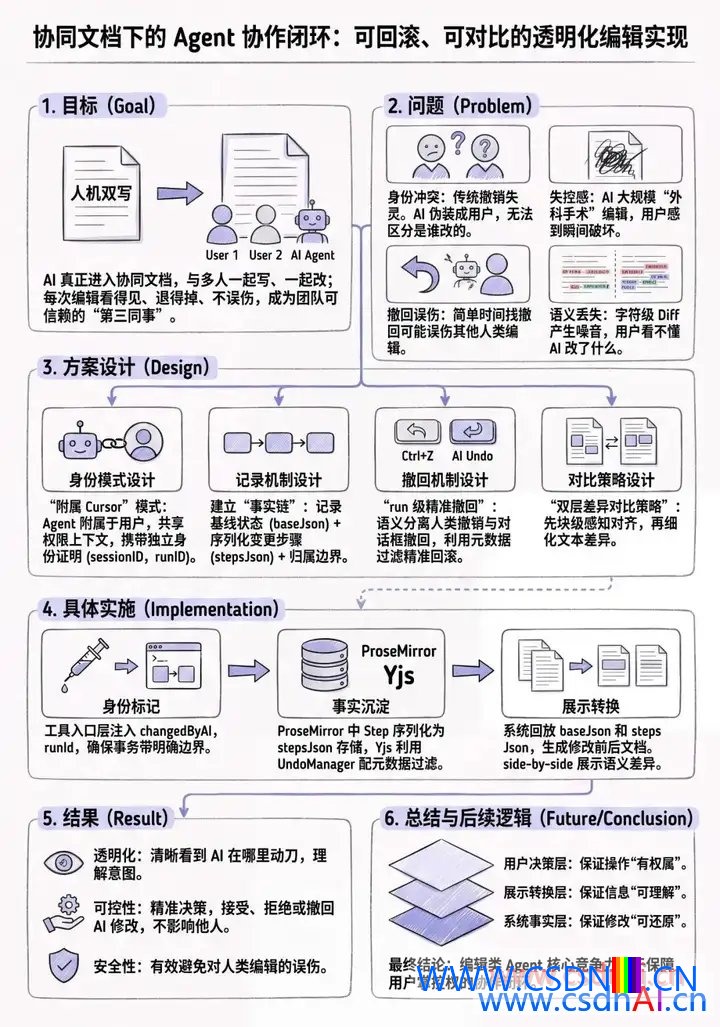
经过反复权衡,我们最终的取舍更倾向于第二种模式:Agent 附属于操作它的用户,但它的每一次改动都必须拥有独立的”身份证明”。
这句话里,蕴含着两个至关重要的考量。
Agent 不会以一个完全独立的协作者身份出现。它会共享当前用户的上下文、权限和提交通道,不会凭空制造出一个”虚拟同事”来占据协同列表的空间。
Agent 也不能完全伪装成用户本人。它的每一轮编辑都需要带上清晰的归属边界,比如会话 ID、运行轮次、消息批次等信息。这样,系统才能精准地区分:哪些是用户亲手输入的,哪些是这一轮 AI 编辑的成果,以及哪些是 AI 编辑后系统自动补齐的结构。
这直接影响到两个最核心的交互逻辑:
- Ctrl+Z 永远是人类用户自己的编辑撤销。
- 对话框里的”撤回”按钮,则是专门针对 Agent 这一轮编辑的撤回。
如果这两者混为一谈,用户很快就会感到失控。因为他将无法判断,当他按下撤销键时,究竟是撤销了自己刚刚输入的一句话,还是 AI 上一轮生成的一大段内容。
三、透明化编辑:让 AI 的”手术刀”清晰可见
Agent 的修改往往是大刀阔斧、跨结构重写的。对用户而言,这更像是一场”外科手术”。如果系统只是简单粗暴地把结果直接应用到文档上,用户会产生一种”文档突然变了”的强烈失控感。因此,AI 的编辑绝不能只有冰冷的结果,它必须拥有透明化的过程。
1. 语义化差异对比:超越字符的智慧
传统的字符级差异对比(比如 diff-match-patch)对于富文本来说,简直是场灾难:它会把一次段落重写拆解成无数细碎的增删,可读性极差,让人摸不着头脑。
为此,我们采用了两层差异对比策略:
- 块级感知(Block-aware):首先回答”哪些大的内容块发生了变化”。
- 文本级细化:只有在确定了变化的块之后,再深入其内部进行精细的文本对比。
这样一来,用户看到的是”AI 在哪里动了刀”,而不是一堆晦涩难懂的”底层操作日志”。
2. 建立”事实链”而非”结果快照”
透明化不仅仅是弹出一个对比框那么简单,它更深层的意义在于,将”AI 到底做了什么”沉淀成一条可供回放的”事实链”。这里的记录层并非简单地保存一份修改前的文档和一份修改后的文档,而是将编辑器运行时产生的变更步骤,转化为可存储、可排序、可回放的数据。
在 ProseMirror 中,Step 是最小的变更单元。它本身代表着”这次编辑对文档做了什么”,但运行时对象不能直接作为长期事实使用,因此我们会将其序列化为 stepsJson。这样,一轮 Agent 编辑就不再是一个模糊的”改后结果”,而是变成:
- 基线:这一轮编辑开始前的文档状态 baseJson。
- 过程:按顺序记录的 stepsJson,详细记录了每一步的修改。
- 边界:绑定了 session、run 和 message 的归属信息,明确了这次编辑的”身份”。
四、撤回边界:差异看得见,更要退得准
上面我们解决了”看得见”的问题:AI 的结构化动作被编辑器追踪为 baseJson + ordered stepsJson,并能回放成用户可读的差异。但只要 Agent 真的参与了文档编辑,用户接下来一定会问:如果 AI 改错了,我能不能只撤回它的修改?
在普通的单人编辑器里,”撤销”(Undo)基本可以理解为一个时间栈:最近发生的操作,总是最先被撤销。
然而,在多人协同加上 Agent 编辑的复杂场景中,这个简单的模型就行不通了。因为时间上最后发生的操作,不一定是你真正想撤销的操作。
一个典型的场景是:
用户 A 触发 AI 修改了文档的第 2-3 段;与此同时,人类用户(包含用户 A 自身)在第 4 段补充了一句话。此时,用户 A 点击了”撤回 AI 修改”。如果系统执行的是全局撤回,那么人类用户刚刚辛苦补充的内容,就有可能被无辜地”带走”。
这在协同文档中是绝对不能接受的:对 AI 撤回操作,竟然误伤了人类用户的手动编辑。
因此,我们将撤回的语义拆分为两类:
- 用户按下 Ctrl+Z,撤销的是自己亲手编辑的历史记录。
- 用户在 Agent 对话框里点击”撤回”,撤销的则是这一轮 AI 编辑边界内的所有改动。
五、展示转换:为何选择并排对比,而非纯文本差异?
有了 baseJson + stepsJson,系统已经能够准确地还原文档的变化。然而,这仍然不是用户真正想看到的东西。
Step 适合机器读取,却不适合人类阅读。用户并不关心底层是第几个 Step,也不关心某个位置被替换了多少个 token。用户真正关心的是:
- 哪些段落被修改了?
- 哪些内容是新增的,哪些内容被删除了?
- 这一段到底是轻微的润色,还是整体的重写?
- 我能不能快速跳过没有变化的部分,只关注关键的差异?
这就是展示层存在的意义:将系统记录的”事实”转化为用户可理解的”编辑解释”。
我们没有选择纯文本差异对比,原因非常直接:协同文档并非纯文本。它是一个富文本树,其中包含了段落、标题、列表、表格、节点属性、标记以及嵌套结构。如果直接将其打平为字符串再进行差异对比,虽然算法简单,但会丢失大量的结构语义,最终呈现给用户的是一堆难以理解的字符碎片。
因此,我们采用了 side-by-side(并排)的双层策略。
第一层是块级对齐。
系统首先将文档拆分成顶层的内容块(blocks),然后判断每个块是保持不变、被删除、新增、替换,还是类型相同但内容发生了变化。这个层级提供了整体的”可观测性”:用户首先能够了解文档结构上发生了哪些宏观变化。
第二层是文本级细化。
对于那些”类型相同但内容被修改”的区域,系统会进一步深入其内部,进行精细的文本差异标记。这样,用户既能看到段落级别的变动范围,也能清晰地看到具体是哪几个词、哪几句话发生了变化。
六、三层心智模型:记录、展示、决策,缺一不可
做完一期后,我们回过头看,整个方案其实围绕三层心智模型展开:
- 记录层:每一次 Agent 编辑都带完整的身份标记(会话 ID、运行轮次、消息批次),形成可回放的事实链。出了问题能溯源,不是一笔糊涂账。
- 展示层:side-by-side 双层 Diff 让用户看得见改了什么。块级先给全景,文本级再给细节。实测这样分层展示,用户理解成本最低。
- 决策层:撤回语义拆清楚——Ctrl+Z 撤自己的,对话框撤 Agent 的。边界不混,用户才敢用。
三层缺一不可。只有记录没有展示,用户看不到变化;只有展示没有撤回,用户不敢让 Agent 动手;只有撤回没有记录,出了问题无法复盘。
七、结语
编辑 Agent 和聊天 Agent 最大的区别,不在于模型多先进,而在于完整的流程设计。核心目标只有一个:让用户在 Agent 完成修改后,仍然感受到文档的掌控权在自己手中。
这件事没有银弹。身份归属、透明化展示、精准撤回,每一层都需要工程上的取舍和打磨。但只要方向对——让 AI 的改动看得见、退得掉、不误伤——用户就会逐步建立起对 Agent 编辑的信任。