条条大路通罗马,通往 AGI 的路也不只有一条。AI 要从技术、产品走向产业和生活,真实世界任务到底需要什么样的模型?
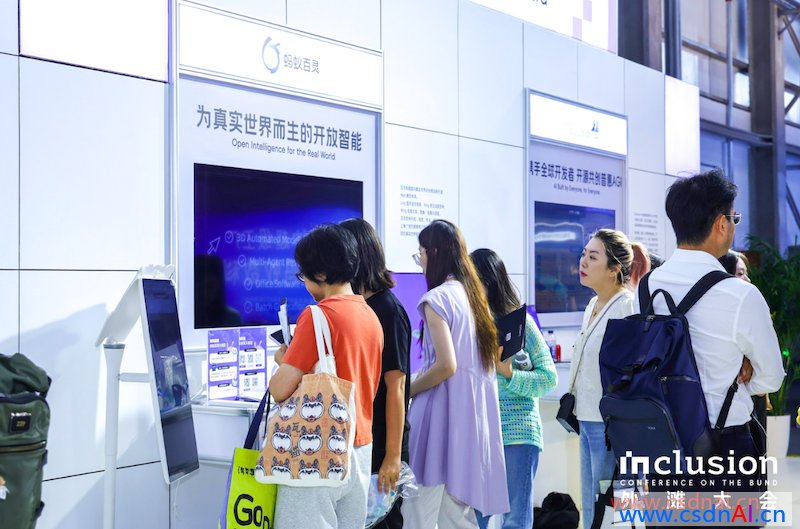
外滩大会期间,蚂蚁基础智能技术部负责人、百灵大模型负责人西亭,阿福模型技术负责人进捷,百灵金融模型负责人月引,百灵语言基座负责人零幺接受媒体访谈,解读百灵 Ling-3.0 系列模型的迭代逻辑、技术突破与落地布局——以高智效比为核心,打造为真实世界而生的开放智能,推动模型向真实场景大规模落地。
百灵大模型:追求更高的”智效比”
今年 8 月以来,蚂蚁百灵 Ling-3.0 系列模型陆续开放,目前发布开源的主要有以下几款:
·Ling-3.0-flash:新一代原生混合推理模型,兼顾代码、推理、Agent 与长上下文能力,总参数 124B,激活参数 5.1B,更低激活、更高吞吐,更高的智能密度。
·Ling-3.0-tiny:迄今为止最小体积的模型,总参数 7.9B,激活参数 1.3B,可以运行在电脑、手机等端侧设备,以更少的激活参数承载更完整的任务能力。
·Ling-3.0-flash-base 与 Ling-3.0-tiny-base:更开放、更具可塑性的 Base 模型,便于开发者基于自己的数据、任务和目标开展后训练。
·Ling-3.0-flash-Fin:首个金融增强模型,面向真实金融工作流场景,总参数 124B,激活参数 5.1B,延续了基础模型的参数配置,并具备 256K 长上下文能力,兼顾复杂金融内容处理和实际部署效率。
·Ling-3.0-flash-VL:首个原生多模态模型,可以更好地看报告、理解 PPT 以及理解 GUI 界面,总参数 124B,单次推理激活参数 5.5B。
百灵大模型 Ling-3.0 系列的发布是一次重大版本迭代,从目前发布的模型可以看出几个明显的变化:一是推出更小尺寸模型;二是向行业垂直领域深耕;三是强化多模态能力;四是更开放。
这些变化的背后是团队对高”智效比”的追求,致力于实现更高的智能密度。从产品技术走向真实的世界,需要更高的智效比解决普惠的问题。对”智效比”的追求打破了业内一味卷参数、堆算力的模型演进路径,是一条比较务实的通往 AGI 的模型演进路线。
西亭提出,AGI 存在更广义层面的 Scaling,核心落脚点是如何更好地解决真实世界的问题。模型要落地真实场景,就不能太依赖超高算力,要适配用户可负担的算力条件。对用户而言,单一的参数规模指标也不重要,模型能否切实解决实际问题才是关键。
实际上,在去年三、四月份,百灵大模型团队曾围绕”理想的智能模型应当具备哪些特质”展开思考,并提炼出三大核心理念:计算效率(Computing Efficiency)、参数效率(Parameter Efficiency)、Token 效率(Token Efficiency)。
百灵大模型的定位是打造面向真实世界,具备高智效、专业化的基础模型体系。其 Ling-3.0 系列所追求的更高智效比(即智能密度),是让每一份计算资源,都尽可能对最终业务任务产生最大价值。围绕这一目标,主要做了三方面工作:
·一是模型架构优化。对混合线性架构与高稀疏度 MoE 结构进行拓展,提升每一个 Token、每一项参数对最终任务的贡献度。
·二是面向任务的学习能力建设。将模型置于更多真实业务环境持续迭代,使其具备任务拆解能力,更加专业可信,能够识别任务失败场景,学会适时暂停执行,或是主动寻求人工介入。
·三是打造开放的模型体系。开放基座模型以及不同训练阶段的模型权重,推动模型适配多样化框架,让智能能力进一步贴近用户。
从客户应用角度来看,模型本身每次推理都激活全量参数其实不太经济,响应速度也无法满足很多场景的需求。百灵大模型的 MoE 架构以及混合注意力机制,可以明显提升参数效率。
零幺认为,当前超大规模模型普遍存在严重的过参数化现象,大量参数并未得到有效利用。百灵大模型的技术路径选择,在一定程度上缓解了过参数化问题,不仅能够带来更高的智能效果,还可以实现更快的推理响应表现。
“我们希望 Ling-3.0 系列从模型的能力走向任务的价值,能够让’更高效、高专业、更可靠’的 AI 去服务复杂的真实世界。”西亭表示。
百灵团队打造了面向行业的增强模型,这是其探索 AGI 非常关键的一步。百灵大模型率先布局金融和医疗两大行业,月引表示,为了追求”领域智能上限”,所以选择了难度足够高的行业进行落地探索。
此外,如果能够攻克金融、医疗两大领域的技术难点,沉淀出的大量能力可以反哺基座模型,提升基座的整体智能水平。而能力更强的基座模型,又能进一步孵化出性能更优的垂直行业模型,可以用更高的智效比深入产业落地,带来更多真实场景反馈反哺基座模型。这种”基座模型—垂直行业模型”之间的正向反馈,将形成螺旋上升的迭代效应,助力实现 AGI。
智效比:模型在真实场景大规模落地的关键
随着 AI 技术不断发展,海量智能体深入企业,无论是模型供应商还是客户都越来越看重模型智效。从全球范围来看,越来越多的模型厂商重视 flash 级模型,明显加快了 flash 级模型的发布节奏,比如 Gemini 六周内发布了三个 flash 版本模型,还有不少厂商推出了可以在端侧部署的更轻量级模型。
这不难理解,对于智能体实际执行的大部分任务而言,前沿推理模型并非合适的工具,很多中小企业资源有限,可能也用不起前沿模型。在 AI 应用调用模型的时候,更智能的模型路由分发可以提升智效比,即将每个查询发送至最合适的模型,而非默认将所有任务都分配给能力最强同时也是成本最高的模型。
进捷介绍,蚂蚁阿福在发展过程中已经遇到了智效比的问题,最开始使用最大、最好的模型,但是随着用户规模不断上升,推理成本也水涨船高,而且 C 端用户往往也需要更快的响应速度。
想要提升智效比,关键在于将每项任务与能够可靠完成且成本最低的模型相匹配,并在任务层面进行衡量。
西亭介绍,智效比不是孤立地追求某项指标,而是寻求更好地综合平衡。最终想要量化的是”端到端任务成功率”,不能将其简单等同于单步生成成功率。
据悉,未来百灵大模型将重点围绕三个方向持续投入。向上,持续拓展模型能力,进一步提升在通用场景和复杂场景中的 Agent 能力;向下,进一步降低使用门槛,通过更好的智效比,让模型更贴近用户;向外,深化模型的专业性,与行业伙伴一起,把模型带入医疗、金融等领域更复杂的工作环境。
目前,大模型的效果量化、可信落地仍是行业共性难题,而好的模型不是设计出来的,是用出来的,优质的 AI 模型更依托海量真实场景的持续淬炼。对企业而言,AI 落地最终要回归商业本质、考量投入产出比,需要结合具体业务场景,在智能、速度与成本之间进行平衡取舍。可以预见,以高智效比为核心的模型发展思路,将成为 AI 产业规模化、普惠化落地的主流趋势。