Anthropic 最近在一篇讲上下文工程新规则的博客里提到,他们为 Claude 5 代模型砍掉了 Claude Code 超过八成的 system prompt。官方的解释很坦诚:模型变强之后,此前那些大段指令反而会稀释注意力。
轻量化是个共同方向。Claude Code、Codex、Pi 挑顺手的用就行——工具不是重点,下面简单聊几个我日常在用的。
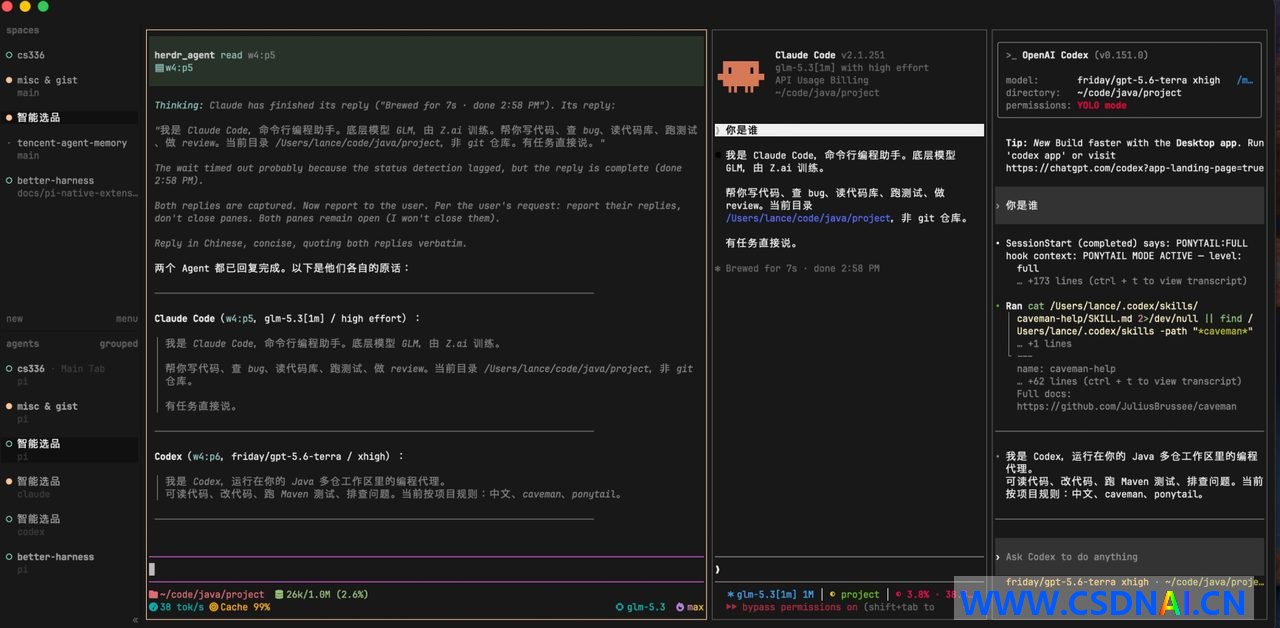
一是 matt skills,Matt Pocock 整理的一套 Skill 集合,他大概是世界上最会写 Skill 的人。我常用这五个:
| Skill | 技能作用 |
|---|---|
| grill-me | 苏格拉底式追问,把模糊的想法问清楚 |
| grill-with-docs | grill 的加强版,逐问对齐的同时落地 ADR 和术语表 |
| to-spec | 把对齐结果写成 spec 文档 |
| to-tickets | 把 spec 拆成垂直切片的 tickets,带依赖 DAG |
| implement | 由 subagent 拉取 ticket 实现,内部执行 TDD 和 code-review,自己修到过审为止 |
二是 ponytail,用来消除 AI Slop。LLM 写代码总爱塞一堆没意义的东西:防御性的空检查、永远不会有第二个实现的 interface、给常量再包一层 private 常量、注释里写满过程性标注……这些内容单看似乎没问题,但日积月累,无论是人维护还是 AI 维护都会变成负担。ponytail 的作用就是卡住这类内容——这个逻辑该不该存在、代码库里有没有现成的、标准库能不能干、能不能一行写完,全都答不上来才允许写新代码。用上之后 diff 明显变短,而短 diff 正是好 review 的前提。
三是 subagent 配 worktree。并发跑多个任务时用 git worktree 做隔离,各改各的互不冲突;worktree 是 git 的通用概念,哪个 Harness 都能用。在 Claude Code 和 Codex 里 subagent 是原生能力;而 Pi 秉持 Less is More,原生并不提供 subagent,理由是作者认为用 tmux 这类原语就能实现 subagent 的并行、避免上下文腐化等效果。我日常用的是 Herdr,可以理解为 AI 时代的 tmux,比 subagent 更轻,还能让 Pi 直接操纵里面的 Claude Code、Codex 进程。
三、日常 Coding SOP
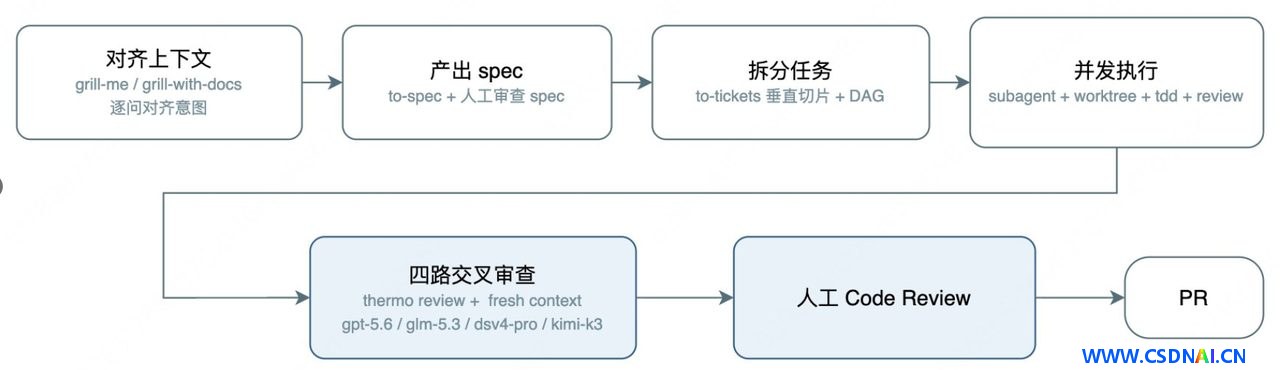
先用 grill-me / grill-with-docs 对齐上下文。这个阶段和 AI 一轮轮脑暴,把需求边界、约束条件摸清楚。对齐之后用 to-spec 产出 spec 文档,人工 Review 一遍——这是第一道人工门控。spec 过了,用 to-tickets 做垂直切片拆分任务,每个 ticket 都能独立交付执行。接着派 subagent 跑 implement,一个 ticket 一个 subagent,靠 worktree 隔离并发执行,执行内部走 TDD + code-review。全部完成后做 PR 级 review,最后由人工 CR 把关。
这套链路当然不算轻。如果只是单文件的局部小改,边界清晰、验证成本低,直接让 Main Agent 对齐后快速改动就行。不过轻流程也有两条底线:改之前依然要先出简单方案等人授权,改完必须跑测试。流程可以分级,纪律不能分级。
四、人工 Review 成了新的瓶颈
Anthropic 前阵子发过一份 AI-native SDLC 的 playbook,其中一个结论是:代码生成已经快到飞起,软件开发的瓶颈转移到了 Coding 的左右两侧——出方案、Review、部署上线这些环节还在以人的速度运行。
我自己的体感是,眼下软件开发的并发上限就卡在人的 Review 带宽上。
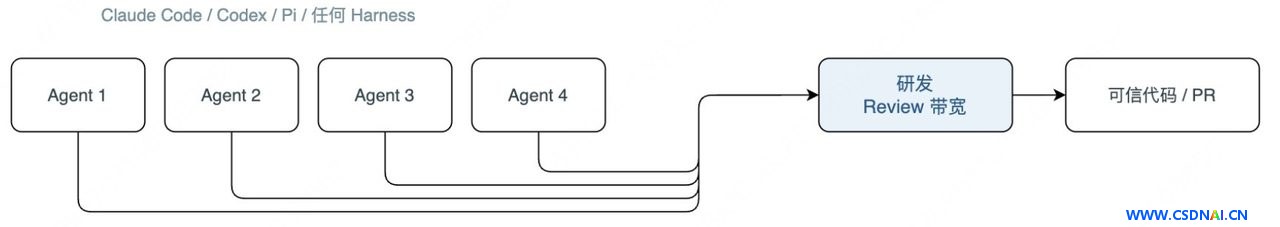
Claude Code、Codex 随便开,worktree 随便建,这些层面的并发几乎是免费的;但一个人同时处理四个 Session 就有点勉强,处理八条一定会有遗漏。所以我判断,未来 Harness 的竞争点会往压缩人工 Review 成本的方向走。
Ensemble Review 是我现在用来压缩 Review 成本的手段,原理是让不同厂商的模型交叉审查同一段代码。每个模型都有系统性盲区,GPT 看不出的问题 DeepSeek 可能一眼就发现,单一模型自审等于让考生自己改卷子。我的配置是四路对抗 Reviewer:GPT、GLM、DeepSeek、Kimi 各自拉起一个 subagent,用干净上下文跑同一个审查 skill。
但模型 Review 做得再多,最后还是要人来拍板。四路结论摆在一起,这个判断依然是人的活。
五、软件工程思维仍然关键
吴恩达最近有篇文章讲 AI 时代的软件工程基本功,其中一个观点我很认同:不懂软件基础的人靠 Vibe Coding 也能完成开发,麻烦在于 Agent 可能已经替他做了一堆糟糕的取舍,而他自己根本不知道这些取舍发生过。接口延迟、可用性、一致性、成本——这些 trade-off 即便有了 AI 也不会消失,人的判断只会越来越重要。
AI Coding 迭代太快,这次聊的东西可能三个月后就过时了。但有几件事我确定不会过时。一件是对系统的理解:选延迟还是选成本,要简单还是要可扩展,一致性优先还是可用性优先,这些判断大模型只能给你选项,给不了最优结论。另一件是工程直觉:哪段代码可疑、哪个需求有坑、哪条 Review 意见是噪音,这些同样是 AI 替代不了的。
思考
上面这套实践非常前沿,工程化程度也很高——从 Spec-Driven 到 Worktree 并发,再到对抗性评审,其中”瓶颈转移到需求对齐与 Review”的判断相当敏锐。但推敲它的底层逻辑、边际成本和落地现实时,有几个值得反复掂量的工程盲点与权衡。
1. “工具轻量化”与”流程重型化”的认知错位
工具极简与流程繁琐形成了反差:一边推崇”大模型变强后砍掉 80% System Prompt”的轻量化趋势,一边又设计出一套极端严密的重型流水线(grill → spec → tickets → TDD → worktree 并发 → 4 路对抗 Review)。
效能开销值得算一算:这套仪式感十足的流水线适合中大型业务架构演进,但在多数日常需求交付中,维护 DAG Ticket 拆分、处理 Worktree 分支合并冲突、配置环境所花的时间,往往已经超过实际编码时间。当开发门槛从”写代码”变成”管理由 5 个阶段和多个 subagent 构成的庞大流水线”,本质上是用流程的超载替代了编码的超载。
2. Ensemble Review 看似降本,实则推高认知负荷
让 GPT、DeepSeek、GLM、Kimi 四路并发评审同一段代码,表面上消除了盲区,但 LLM Reviewer 极易产出大量”可改可不改”的伪代码异味、主观的风格争执或过度防御性建议,结果是噪音放大、注意力被稀释。
审卷人变成了法官:原文也承认”四路结论摆在一起,最后还是得让人判断”。这意味着工程师不仅要 Review 原始代码 Diff,还要去 Review 四个 AI 产出的上百行审查意见并做出仲裁。在多数工程实践里,阅读并过滤 4 份充满假阳性的评审报告,耗费的心智带宽往往远高于直接扫一遍短 Diff。
3. 对 AI Slop 的防御存在代际滞后
ponytail 这类工具强制拦截防御性空指针、无用接口或冗余封装,确实能缩短 Diff。但这种卡控本质上是用静态规则或启发式 Prompt 去修剪模型的坏习惯,属于外挂门禁。
推理模型的反噬同样要警惕:随着具备长思维链(Reasoning/Thinking)能力的大模型普及,模型在自主规划时本就具备精简冗余的能力。如果在 Harness 层叠加层层严厉拦截,很容易引发”过度纠错”——代码为了强行精简而牺牲可读性,甚至导致边界用例被砍掉。
4. “并发上限卡在人类 Review”的解法存在根本局限
并发其实是个假象。作者提到”一个人同时处理 4 个 Session 比较勉强,8 个一定遗漏”,但这不只是带宽问题,更是架构全局一致性(System Coherence)的瓦解。
局部最优会导向全局次优:8 个独立的 subagent 在各自的 worktree 里切片交付 ticket,即便各自都通过了 TDD 和本地代码审查,集成在一起时依然容易出现隐式依赖冲突、重复造轮子和设计范式漂移。
真正的破局方向,很可能不是让更多模型来”挑刺”,而是把验证左移、由确定性基础设施兜底——比如更完备的端到端集成测试、属性测试(Property-based Testing)、金丝雀灰度和契约测试(Contract Testing)。用确定性的测试流水线拦截问题,永远比让概率性的模型互评更节省人的注意力。
核心总结
这套 SOP 的核心价值在于高度尊崇经典软件工程纪律——TDD、清晰的 Spec、垂直切片——这也正是它能跑通的原因:它用传统的高标准工程规范驯服了 AI 的随意性。
它的危险之处在于过早优化了”高并发生产代码”的能力,却低估了”多模型仲裁与集成”带来的认知税。落到实际工程里,更实用的演进路径大概是:保留苏格拉底式对齐与 Spec 规范,简化多 Agent 对抗机制,把省下来的精力投向强化自动化回归测试与可观测性体系上。