大模型评测这件事,做过的都知道有多拧巴。模型能力天天涨,评测集却常常是静态的;分数看着漂亮,落到业务里未必能用。这篇把 Open Compass 司南体系的关键坑和实操要点捋一遍。
评测到底在评什么
评测不是给模型排个座次就完事,它得能反过来推动模型演进。发现短板,才有针对性的提升策略,也才能摸清模型能力到底是怎么形成的。
面向未来,评测维度必须扩展。数学、复杂推理、逻辑推理、代码、智能体,这些新能力维度不补上,评测就滞后于模型本身。
通用能力要扎根,垂直产业要聚焦。医疗、金融、法律这些专业场景,评测得把行业知识和标准融进去,否则测出来的行业适用性就是空的。
中文场景还得有高质量的中文基准。中文社区的大模型发展,绕不开能精准评估中文能力的评测集。
四个绕不过去的难点
全面性排第一。应用场景千变万化,模型能力演进又快,怎么设计一套可扩展的能力维度体系,是评测框架的底层难题。
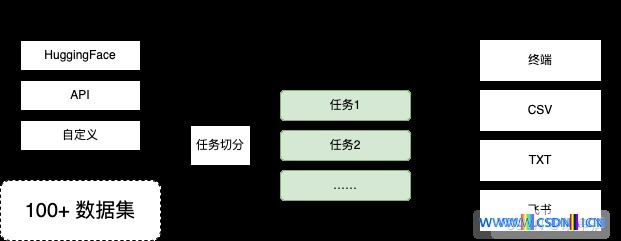
评测成本是第二个坎。数十万道题跑下来,算力资源是海量的;靠人工打分的主观评测,成本更高。
数据污染最隐蔽。海量语料里不可避免混进评测集内容,需要可靠的资料污染检测手段,还得构建能动态更新的高品质基准。更麻烦的是有人在评测集上调参,刷出来的分虚高,这种分数直接不可信。
鲁棒性容易被忽略。大模型对提示词极其敏感,多次采样下表现不稳定,同一道题换个问法答案就飘。
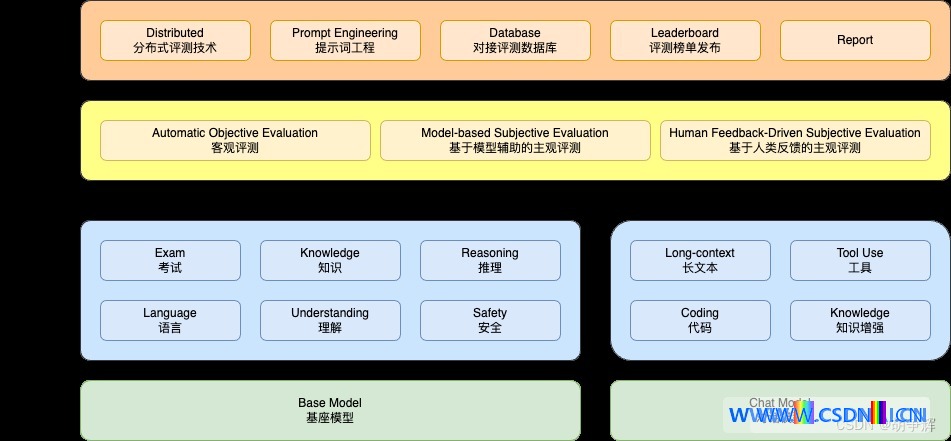
Open Compass 是什么
Open Compass 是一个大模型评测基础,中文名司南。它把评测流程、数据集、模型接入都做了标准化封装,省去自己搭评测流水线的重复劳动。
Open Compass 2.0 司南大模型评测体系已经开源,版本迭代历史在官方仓库可以查到。
数据污染怎么查,这里有个坑
刷分是评测里最脏的一环。模型在评测集上调参,分数虚高,但真实能力没变。检测污染不能只看最终分数,得从数据层面查。
常用的做法是做 n-gram 重叠检测,把评测集的题目和训练语料做比对。但这里有个坑:中文分词后 n-gram 重叠率天然偏高,阈值设太松会误报,设太紧又漏检。实测下来,字符级 13-gram 重叠比词级更稳,但依然需要人工抽检确认。
另一个办法是动态更新评测集。静态基准迟早被污染,定期换题、加新题,才能让刷分的人跟不上节奏。不过动态更新也有代价:分数不可跨版本比较,历史榜单会失真。所以生产环境里,建议固定一个基准版本做纵向对比,另开一套动态集做能力探测。
上面这段脚本只做粗筛,判定标准是:单条题目与训练语料的最长公共子串超过 50 个字符,就标记为疑似污染,转人工复核。别直接拿这个结果下结论,误报率不低。
鲁棒性测试怎么做才不白测
提示词敏感是普遍现象。同一道题,换个标点、调个语序,答案可能就变了。测试鲁棒性不能只跑一遍。
标准做法是对同一题目做多次采样,比如 temperature 设 0.7,跑 5 次,看答案一致率。一致率低于 60% 的题目,说明模型在这类问题上不稳定,需要单独拎出来分析。
但这里有个适用范围问题:创意写作、开放问答这类任务,本来就不该要求答案一致,强行测一致率会得出错误结论。鲁棒性测试更适合有确定答案的任务,比如数学、代码、选择题。
还有个实操细节:多次采样会显著拉长评测时间。如果只是做模型选型,跑 3 次取多数票就够了;要做严谨的鲁棒性报告,5 到 10 次采样才够看。
评测成本怎么压
数十万道题全量跑,算力账单很吓人。压缩成本有几个方向。
一是分层抽样。不是所有题目都需要全量跑,按能力维度分层,每层抽代表性题目,能大幅减少题量。但抽样会引入偏差,需要做统计校验,确保抽样分布和全集一致。
二是用轻量模型做预筛。先用小模型跑一遍,把明显答对的题过滤掉,再让大模型跑剩下的。这个办法在模型能力差异大时有效,但小模型和大模型的错误模式不一定相关,预筛可能漏掉大模型才会错的题。
三是主观评测自动化。人工打分贵,可以用强模型做裁判,但裁判模型本身有偏好,需要做校准。校准方法是:人工标注一批样本,看裁判模型和人工打分的一致性,一致性低于阈值就不能用。
垂直领域评测的坑
医疗、金融、法律这些领域,评测集不能直接拿通用基准改。行业知识有专门的标准和术语,通用评测集测不出行业适用性。
建垂直评测集,最难的是一致性。同一个问题,不同专家给的答案可能不一样,尤其是法律和医疗这种有裁量空间的领域。解决办法是建立标注规范,明确什么算对、什么算部分对、什么算错,并且做标注者间一致性检验。
另一个坑是数据脱敏。行业数据往往涉及隐私和合规,评测集发布前必须脱敏。脱敏不彻底会泄露真实信息,脱敏过度又会破坏题目语义。这个平衡点需要法务和技术一起定。
中文基准的特殊性
中文评测不是把英文基准翻译过来就行。中文的分词、语义、文化背景都和英文不同,直接翻译会导致题目失真。
高质量中文基准需要原生设计。题目要符合中文表达习惯,答案要经得起中文母语者推敲。另外中文里一词多义、歧义句的情况比英文多,评测题目的表述必须足够精确,否则测的是模型对歧义的理解,而不是目标能力。
中文社区的大模型发展,离不开这样的原生中文基准。翻译基准只能做补充,不能做主力。
评测体系的演进方向
评测体系不是一次建成就完事。模型能力在涨,评测维度就得跟着扩。数学、复杂推理、逻辑推理、代码、智能体,这些维度会持续加进来。
通用能力是底座,垂直产业是延伸。底座要稳,延伸要准。医疗、金融、法律的评测,得和行业专家一起做,不能闭门造车。
性能评测最终要反哺能力演进。评测发现的问题,要能转化成模型改进的方向;评测揭示的机制,要能指导模型设计。评测不是终点,是循环的一环。
落地建议
如果团队刚开始做评测,建议先跑 Open Compass 的标准流程,把基线建起来。别一上来就自建评测集,容易重复造轮子。
基线建好后,重点做两件事:一是污染检测,确保分数可信;二是鲁棒性测试,确保分数稳定。这两件事不做,评测结果就是自欺欺人。
垂直领域评测,等通用评测跑顺了再碰。行业数据和标注规范的成本很高,没准备好就上,容易烂尾。
动态更新评测集这件事,建议从第一天就规划。静态基准迟早被污染,等到发现分数虚高再补救,历史数据就全废了。



