多人同时说话的录音,转写工具往往直接崩掉——不是识别得差,而是根本不知道该听谁的。小米开源的 Cocktail ASR-1 换了个思路:不做更强的降噪,而是让你先告诉模型目标是谁。
目标说话人 ASR 到底解决什么问题
给一段参考音频,模型用声纹嵌入锚定目标说话人,在混合音频里只转录这个人的语音。其他人说了什么、混响多大、环境噪声多强,模型一概不输出。
这就是 target-speaker ASR。它和传统降噪路线的区别在于:降噪是把干扰压下去,目标说话人识别是直接锁定一个声纹,从源头上决定输出谁的文本。
模型结构:D2V2 编码器加 Adapter 再接 LLM 解码
Cocktail ASR-1 是一个端到端 LLM 架构:D2V2 音频编码器,经过 Adapter,送入 LLM 解码。所有权重(D2V2、Adapter、LLM)打包在同一个 checkpoint 里。
输入格式是把参考音频和目标音频拼接,中间插一秒静音做分隔,16kHz 单声道。单人和多人场景不需要切换模型,同一个模型全搞定。
基准数据:混合场景下竞品直接归零
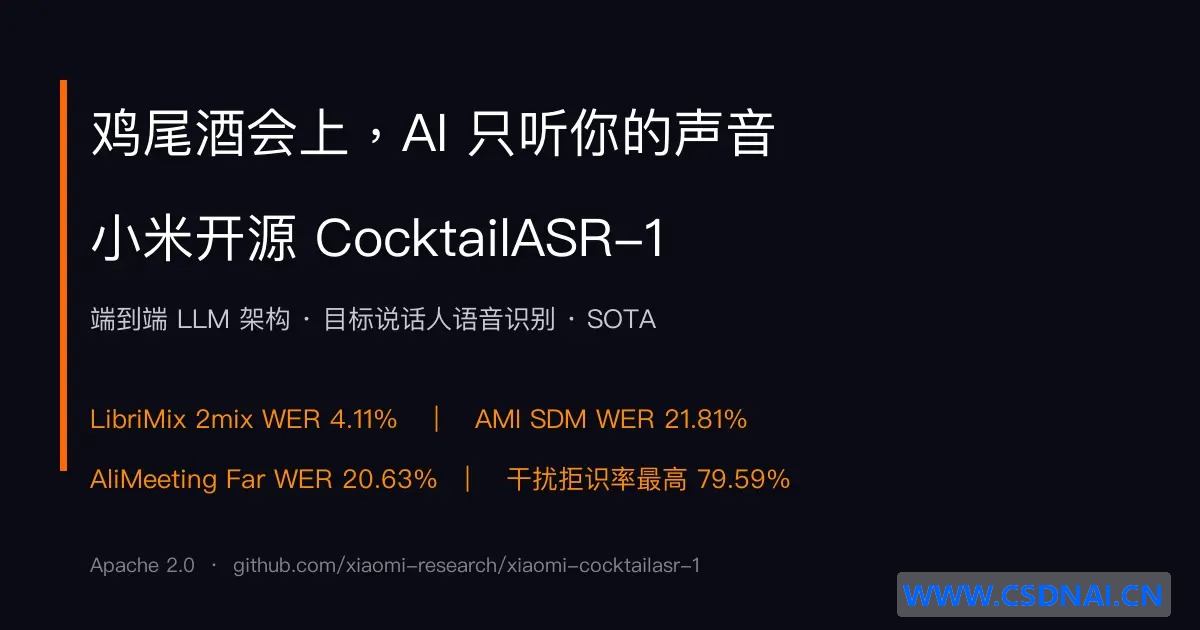
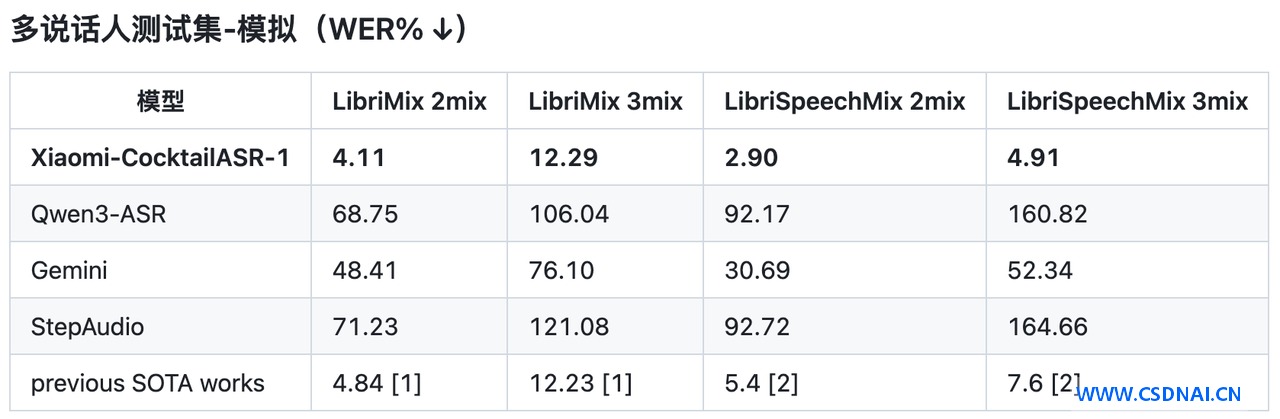
LibriMix 2mix 的 WER 是 4.11%,LibriSpeech Mix 2mix 压到 2.90%。
对照来看,Qwen3-ASR、Gemini、Step Audio 在混合场景下基本做不了这件事——LibriMix 3mix 上这三个模型的 WER 分别是 106.04%、76.10% 和 121.08%,Cocktail ASR-1 是 12.29%。
不是比它们好,是它们做不了。
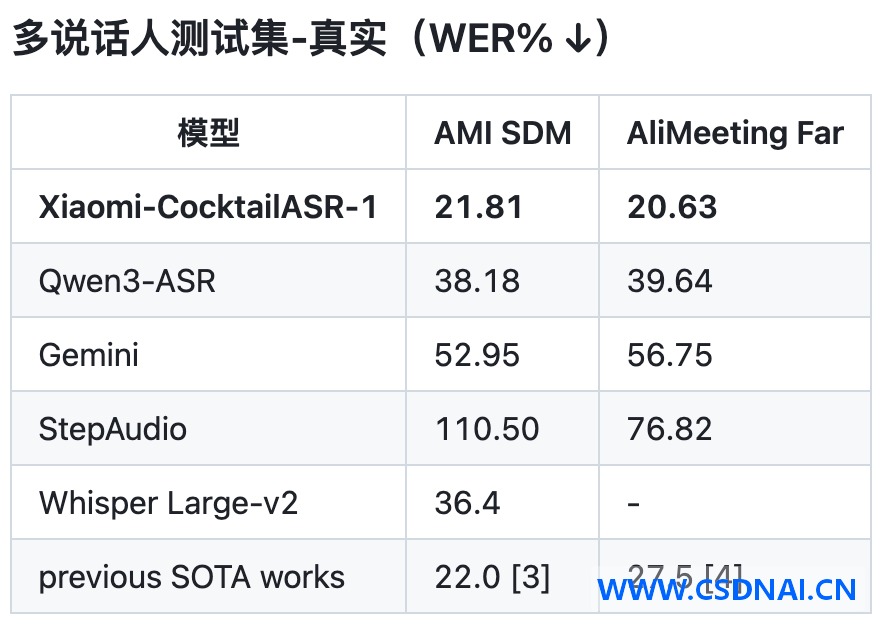
真实会议录制上,AMI SDM 的 WER 是 21.81%,Ali Meeting Far 是 20.63%。真实场景比模拟数据难得多,但仍然大幅领先已有方案。
单人场景也没拉垮。LibriSpeech 上 WER 1.73%,优于 Whisper Large-v2 的 2.06% 和 Gemini 的 2.25%。WenetSpeech 和 Common Voice-zh 上也全面领先。
负样本拒识:智能设备防误触发的关键
参考音频对应的人不参与当前对话时,模型输出空文本。这对智能音箱、车载助手有实际意义——旁边有人说话,设备不该被误触发。
Cocktail ASR-1 在 LibriSpeech 负样本上做到 79.59% 的拒识率,Aishell 上 75.35%,小米自有中文测试集上 68.54%。Qwen3-ASR 和 Step Audio 的负样本拒识率是零——它们没有这个能力,任何时候都会输出文字。
拒识能力有代价:正样本偶尔也被误拒,带来虚假拒识率(FRR)。从技术报告看 FRR 控制得可以接受——LibriSpeech 上 0.36%,Ali Meeting-near 上 0.38%,AMI-ihm 上 0.01%。
这里有个工程判断:拒识率不是越高越好。生产环境里如果 FRR 偏高,用户说半天没反应,体验比误触发还糟。选阈值时得根据场景权衡。
思维链推理:调试有用,用户无感
模型能在输出最终答案前先跑一段被标签包裹的推理过程,解释它怎么判断说话人的。这个功能对终端用户价值有限——你不会想在对话中看它推理——但对调试和可解释性有意义。
CoT 对精度影响不大。LibriMix 2mix 上只降低了 0.24 个 WER 百分点,说明推理能力是副产品,不是用精度换来的。
部署与依赖:最小依赖跑起来
Apache 2.0 协议,最小依赖包括 torch、torchaudio、transformers、soundfile。推理代码已放在 GitHub 上。
没有标注细化参数量和训练数据规模,但从“所有权重放一个 checkpoint”和 D2V2 编码器的选择来看,模型尺寸应该在可上线的边界内。
实际部署时注意:D2V2 编码器对输入采样率敏感,拼接参考音频和目标音频时那一秒静音不能省。少了这个分隔,模型可能把参考音频的内容也转录进去。
选型建议与风险提示
这个方案适合需要从多人对话中定向提取特定说话人文本的场景,比如会议记录里只关注某位发言人、智能设备只响应注册用户。
不适合的场景:需要全量转写所有说话人的会议纪要。目标说话人 ASR 的定位就是只输出一个人,多人全量转写还得用传统方案或说话人日志加 ASR 的组合。
另一个风险是声纹注册质量。参考音频如果太短或噪声太大,声纹嵌入不准,拒识和识别都会退化。生产环境里建议参考音频至少 3 秒以上、信噪比有保证。
小米在语音链路布局已久,从声学前端到语音唤醒到远场 ASR。这次 Cocktail ASR-1 把注意力从“所有声音”转向了“一个声音”——这个转向本身比任何一个 benchmark 数字都更有信号价值。



