内核里的 LZ4 一直是「自己养的孩子」。三星的 Michal Wilczynski 刚提了个 RFC 补丁系列(9 个 patch),要把这套手工维护的分叉彻底扔掉,改成原样 vendor 上游源码、构建期再做适配。以后同步上游就是一次目录拷贝的事。
分叉七年的代价:一个写飞缓冲区的真 bug
内核里解压器最后一次跟上游对齐停在 2018 年的 v1.8.3,压缩器更早,2017 年的 v1.7.3。之后全靠一个个手工 cherry-pick 硬撑,而同期上游 lib/ 目录已经攒下 488 个提交。
差距累积出的是实打实的漏洞。fork 版的 LZ4_decompress_fast() 完全没有边界检查,喂进损坏的输入,数据会同时朝输出缓冲区两个方向跑飞。这不是性能问题,是内存安全问题。
导入方式:逐字节搬源码,构建期套内核胶水
做法是把上游源码逐字节搬进内核(upstream/lz4.c、lz4.h 等),再用一层内核胶水(lz4_deps.h、freestanding/ 头文件)在构建阶段做适配。整体布局参照 lib/zstd 的既有模式,不是新发明的路子。
导入的是 v1.10.0 发布标签。唯一一处偏离上游,是为了满足内核的 -Wmissing-prototypes 警告,backport 了一个上游提交。
代价是体积。lib/lz4 的 text 段在 x86_64 上从 45K 涨到 89K,几乎翻倍。多出来的基本都是以前 fork 里根本不存在的上游代码。
性能收益:erofs 吞吐 +11% 到 +14%
实测口径是 21 次取中位数,每次读 1.3GB 的 LZ4 erofs 内核源码镜像。erofs 4K cluster 从 2363 MB/s 提到 2630 MB/s,+11%;64K cluster 从 2788 提到 3168,+14%。
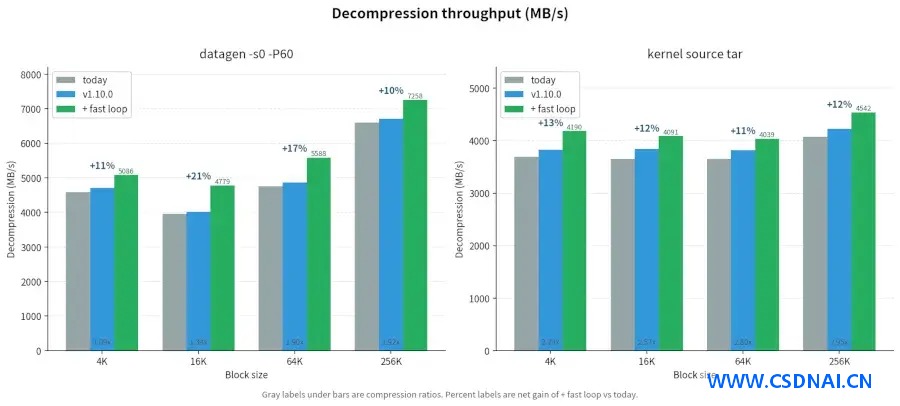
库级解压在 datagen 和内核源码 tarball 两个语料上,各档 block 普遍提升 10% 到 21%。性能来源是上游 v1.9.0 引入的快速解码回路,fork 一直没跟上。
想自己复现的话,注意别只盯单次跑分,LZ4 解压对 cache 状态很敏感,取中位数比取平均稳得多。
顺带修掉的安全问题
LZ4_decompress_fast() 现在走的是带边界检查的解压路径,损坏输入不会再写飞出缓冲区。这个修复和性能提升是同一批代码带来的——跟上游对齐本身就把漏洞补了。
维护层面的变化
这个系列让 LZ4 在 MAINTAINERS 里第一次有了独立条目。之前它一直处于没人专门照看的状态。
线程里 Eric Biggers、Sergey Senozhatsky 等人已经在 review。三星自己跟进也很积极,毕竟 f2fs、erofs、zram 都牵扯其中。
什么场景该关注,什么场景别急着上
对内核发行版维护者来说,体积涨 44K 换解压提速和一次性的安全修复,账算得过来,尤其是 erofs 镜像启动这类解压敏感路径。
对嵌入式或存储极度紧张的场景,得掂量一下 text 段翻倍的代价,别默认照搬。
验证方式建议两条腿走:一是跑 fuzz 或损坏镜像,确认 LZ4_decompress_fast() 不再越界;二是用真实 erofs 镜像做解压吞吐对比,看 4K/64K cluster 两档是否都符合预期。只测一档容易误判。
这次改动的本质是把「维护分叉」换成「同步上游加构建适配」。省下的是长期 cherry-pick 的人力,付出的是编译产物变大。对内核这种量级的项目,通常划算。



