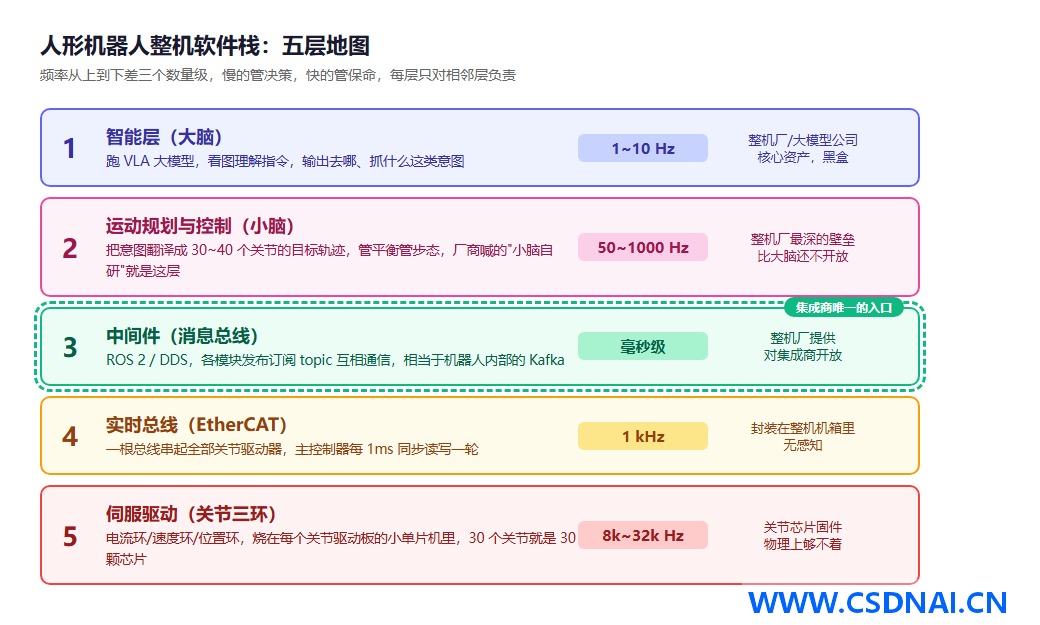
一台人形机器人身上同时跑着五套软件,工作频率从 10Hz 一路铺到 20kHz,横跨三个数量级。这个频率断层不只是性能指标,它直接决定了各层软件由谁掌控。整机厂把上下四层攥在手里,中间留出一层给外部开发者。你的代码就活在这一层之上,真正值钱的东西全在机器人外面。
先把归属讲清楚。第一层和第二层,也就是负责高层决策的“大脑”和负责运动规划控制的“小脑”,属于整机厂的核心资产,以黑盒形式交付,你只能调用它暴露出来的任务级接口。第四层实时总线和第五层关节三环控制,封装在机箱和关节驱动芯片内部,日常开发根本接触不到。唯一对外开放的是第三层中间件,这是整机厂主动留出的入口。
所以选型的时候,别把精力花在比较哪家步态更稳、哪家总线延迟更低上。这些从签合同那天起就不归你管。该问的是:中间件开放了哪些 topic、哪些服务调用,文档是否完整,接口版本是否稳定。
中间件的三层结构与替换逻辑
拿企业软件打比方最省事,这一层相当于机器人内部的 Kafka。结构上是三层套娃。
最外层 ROS 2 是开发框架,地位类似 Spring 全家桶。真正干活的是底下的 DDS 通信库,Fast DDS、CycloneDDS 都是它的具体实现,可以按需替换。两者之间夹着一层 rmw 适配层,作用跟 JDBC 一模一样——换通信库不用动上层代码。厂商交付给你的接口本质就是 DDS 的 topic 加服务调用,用不用 ROS 2 那层壳由你决定。
这里有个容易被忽略的工程细节:ROS 2 的发行版支持周期差异很大。Jazzy Jalisco 是 LTS,支持到 2029 年;此前的 Humble 支持到 2027 年;而 Kilted Kaiju 属于非 LTS 的短期版本,支持窗口只有一年多。做长期交付的项目,底层锁在 LTS 上更安全,别为了尝鲜 Zenoh 就跳到短周期版本上,后面升级迁移的成本会反噬。
验证 rmw 是否真的切换成功,别只看环境变量。启动一个节点后用 ros2 doctor --report 查中间件实现,或者直接 echo $RMW_IMPLEMENTATION 确认运行时取值,再抓一次 ros2 topic list 看话题是否正常发现。三者对得上,才算切换实现。
用法像消息队列,但有一条红线
手感确实跟消息队列一致。要图像,订阅相机 topic,数据流持续进来,写法跟消费 Kafka 消息没差别;要机器人执行任务,调一次导航服务,传入目标坐标,等同调 RPC;要监控状态,位姿、电量、故障码会持续往 topic 上推,运维系统订阅入库即可。企业软件里写消费者的经验基本能平移过来。
但 DDS 的 QoS 语义和 Kafka 不是一回事,照搬会出事。默认的 Reliable 加 KEEP_LAST 深度 1,在图像这类大包高频 topic 上很容易造成队列积压和延迟雪崩。相机流应该显式配成 BEST_EFFORT,丢掉旧帧比堵住强。多机跨网段时,组播发现经常被交换机拦掉,需要手动配置单播对等节点列表,否则机器人之间互相看不见。这类问题在单机调试时完全暴露不出来,一上现场就炸。
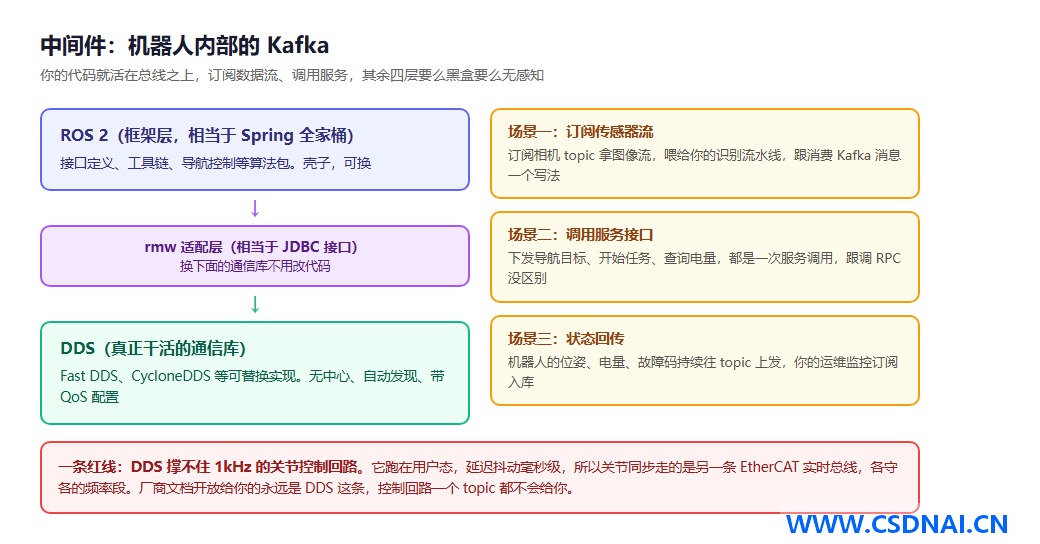
还有一条硬红线:DDS 撑不住 1kHz 的关节控制回路。它跑在用户态,延迟抖动在毫秒级,所以关节同步走的是另一条 EtherCAT 实时总线,两条链路各守各的频率段。厂商文档里开放给你的永远是 DDS 这条,控制回路一个 topic 都不会给,看到了不用奇怪。
ROS 2 从 Kilted 版起把 Zenoh 提升到与 DDS 平级。单机场景两者差距有限,但机器人数量一多,Zenoh 轻量、过弱网的优势就显出来了。做多机器人平台选型时值得纳入评估。
变电站巡检:九成工作在机器人之外
入口清楚了,看真实项目。变电站巡检跑了很多年,结构固定:机器人按任务自主巡检,到点位用可见光加红外拍摄,识别表计读数和热缺陷,结果回传后台生成报告,最后进客户系统。交付物拆开是五块。
真正做在机器人上的只有一块半。第一块任务与调度,客户要求每天早晚各巡一次、雨天加巡,你的系统翻译成任务队列,调导航服务下发,跟踪状态、失败重派——这半块要跟机器人打交道,但方式就是调接口。第二块点位库,工程师遥控机器人在每台设备前摆位、调云台角度和变焦,点保存,十几个参数存库绑定设备条目,现场工作在机器人上做,成果存在你的后端,算半块。
剩下三块半全在软件平台上。识别流水线,图像从 topic 进消息队列,采购的模型推理,结果与阈值比对出告警,厂商不管这段。客户系统对接,告警进 PMS、报告按规范出格式,全是工程苦活,但验收卡的就是它。运维监控,组队状态管理、远程接管、数据回流,加上调度和点位库的服务端部分,纯后端系统。
算下来九成工作量落在机器人外面的平台上。一个后端团队加一个懂电力现场的人就能接,控制工程师一个都不需要。五块里唯一值得当资产沉淀的是点位库:数据存在你的服务端,机器人只是无记忆的执行器,任务来了逐点下发坐标和云台参数。换机器人、多站部署,点位库跟着你走。
多机协同才是平台的价值所在
机器人一多,生意就更大。思路跟企业软件里的调度中心一样:一个站点里轮式守室外平地、四足爬楼梯跨楼层,平台上维护一张统一任务队列。任务来了,调度系统看区域、看哪台机器人空闲、看电量够不够,分下去,各自执行,状态实时回传。底层用 Zenoh 这类中间件把几十台机器人连成一张网,地图和点位库全平台共享。
这套东西的价值在于跟形态无关、跟厂商无关。轮式、四足、人形,不同品牌都接进同一个平台。机器人三年一换代,沉淀的点位库、任务数据、调度规则不换。单台机器人是耗材,平台是资产。
场景也现成。变电站面积大设备多,一台巡完要三小时,三台分区并行一小时收工;电厂有室外设备区、室内配电房、地下管廊,一种形态跑不全,轮式四足混编才覆盖得住;一个地市公司下辖几十个站,任务统一排期、机器人统一调度、告警统一归口,这就是一张网管一个 fleet 的生意,客户签的也是这一层的合同。
一笔账
五层软件栈,上下四层归整机厂,你只从中间件进去。进去之后会发现九成交付工作在机器人外面——任务调度、点位库、识别流水线、客户对接、运维监控,全是企业软件的老本行。机器人多了再加一块多机协同平台,形态无关,可沉淀。运动控制是整机厂的事,你通过中间件接入,集成商的价值在机器人之外,用企业软件的方法论做行业软件的生意。
ID:7171